
Go言語でプログラミングを行う際、文字列の「長さ」をどのように定義するかは非常に重要なテーマです。
初心者が最初につまずきやすいポイントの一つとして、単純な関数を使用しても期待通りの数値が返ってこないケースが挙げられます。
日本語のようなマルチバイト文字を扱う場合、バイト数と文字数の違いを正しく理解しておくことが不可欠です。
Go言語の文字列は、内部的にはUTF-8でエンコードされた読み取り専用のバイトスライスとして保持されています。
この記事では、Go言語における文字列の長さを取得する複数の方法と、それぞれの実務的な使い分けについて詳しく解説します。
len()関数によるバイト数の取得
Go言語で最も一般的に使用される len() 関数は、文字列のバイト数を返します。
ASCII文字(半角英数字)のみを扱う場合、1文字が1バイトで構成されるため、文字数と一致します。
しかし、日本語などのマルチバイト文字が含まれる場合、1文字が3バイト以上で構成されるため、期待する文字数とは異なる結果になります。
以下のコード例で、ASCII文字と日本語における len() 関数の挙動を確認してみましょう。
// len()関数の挙動を確認するサンプルコード
package main

import "fmt"

func main() {
    // ASCII文字のみの文字列
    asciiStr := "Hello"
    // 日本語を含む文字列
    japanStr := "こんにちは"

    fmt.Printf("ASCII: %s, len: %d\n", asciiStr, len(asciiStr))
    fmt.Printf("日本語: %s, len: %d\n", japanStr, len(japanStr))
}ASCII: Hello, len: 5
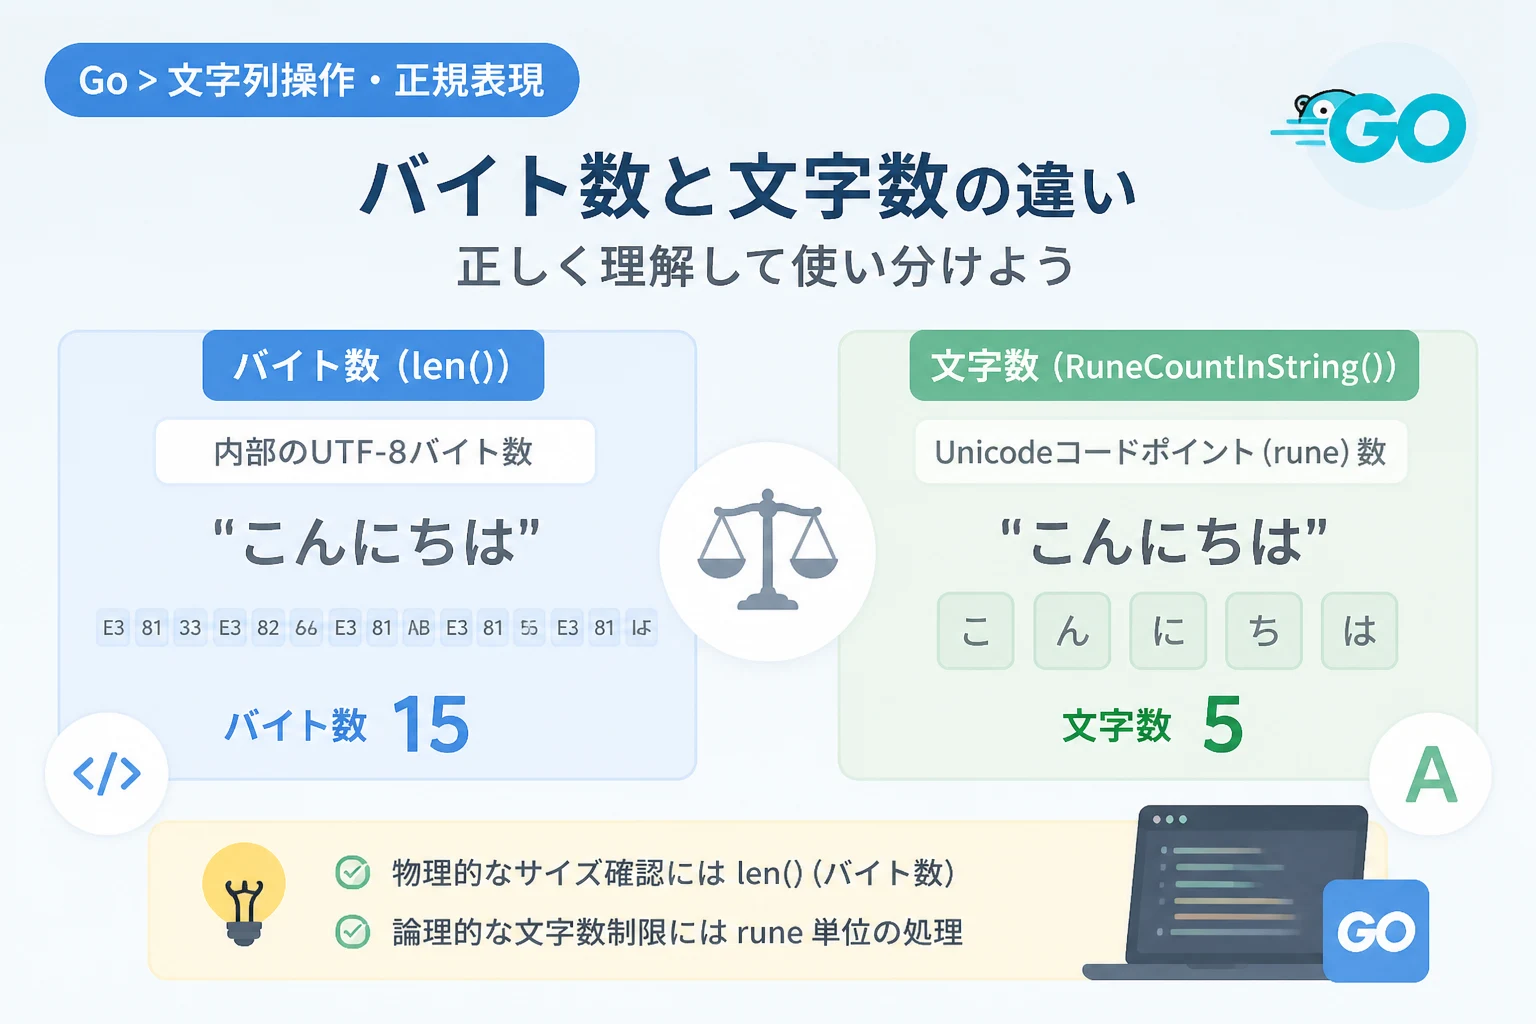
日本語: こんにちは, len: 15なぜ日本語では「15」と表示されるのか
Go言語の文字列型 string は、UTF-8エンコーディングに基づいています。
「こんにちは」という5文字のひらがなは、UTF-8では1文字あたり3バイトを消費します。
その結果、5文字 × 3バイト = 15バイト という計算になり、len() は 15 を返します。
データベースの VARCHAR 型のサイズ制限を確認する場合など、物理的なデータサイズを知りたい場合には len() 関数が最適です。
一方で、画面上に表示する文字数をカウントしたい場合には、この関数だけでは不十分です。
utf8.RuneCountInStringによる文字数の取得
私たちが日常的に「文字数」と呼んでいる、Unicodeの符号点(コードポイント)の数を数えるには unicode/utf8 パッケージを使用します。
このパッケージに含まれる utf8.RuneCountInString() 関数を使用することで、マルチバイト文字を1つとしてカウントできます。
Go言語では、1つのUnicodeコードポイントを rune という型で表現します。
次のサンプルコードで、日本語の文字数を正しくカウントする方法を見ていきましょう。
// utf8.RuneCountInStringを使用した文字数カウント
package main

import (
    "fmt"
    "unicode/utf8"
)

func main() {
    str := "こんにちはGo"

    // バイト数を取得
    byteLen := len(str)
    // 文字数(rune数)を取得
    runeLen := utf8.RuneCountInString(str)

    fmt.Printf("対象文字列: %s\n", str)
    fmt.Printf("バイト数: %d\n", byteLen)
    fmt.Printf("文字数: %d\n", runeLen)
}対象文字列: こんにちはGo
バイト数: 17
文字数: 7RuneCountInStringの仕組みと計算量
utf8.RuneCountInString() は、文字列の先頭から順にバイト列をスキャンし、UTF-8として正しい文字をデコードしながらカウントします。
そのため、len() 関数が O(1) (定数時間)で実行されるのに対し、この関数は O(n) (文字列の長さに比例した時間)のコストがかかります。
非常に長い文字列に対してループ内で頻繁に呼び出すと、パフォーマンスに影響を与える可能性があるため注意が必要です。
入力バリデーションなどで「10文字以内」といった制限を設ける際には、この関数を使用するのが一般的です。
さらに複雑な文字:書記素クラスターへの対応
実は、utf8.RuneCountInString() を使っても、人間が直感的に感じる「文字数」と一致しないケースが存在します。
代表的な例が、絵文字の「肌の色」の指定や、複数のコードポイントが組み合わさって1つの文字を形成する「結合文字」です。
例えば、家族の絵文字や、濁点などの結合文字を含む場合、複数の rune が消費されますが、見た目上は1文字に見えます。
このような「見た目上の1文字」を正確にカウントするには、書記素クラスター(Grapheme Cluster)という概念を扱う必要があります。
// 絵文字や結合文字におけるカウントの差
package main
import (
"fmt"
"unicode/utf8"
)
func main() {
// 家族の絵文字(複数のコードポイントの組み合わせ)
str := "👨👩👧"
fmt.Printf("対象文字列: %s\n", str)
fmt.Printf("バイト数: %d\n", len(str))
fmt.Printf("Rune数: %d\n", utf8.RuneCountInString(str))
}対象文字列: 👨👩👧
バイト数: 18
Rune数: 5上記の例では、1つの絵文字に見えますが、内部的には5つの rune が組み合わさっています。
これを「1文字」と数えたい場合は、標準ライブラリ以外の外部ライブラリ(例えば uniseg など)を使用することを検討してください。
一般的な日本語のテキスト(ひらがな、カタカナ、漢字など)を扱う範囲であれば、基本的には utf8.RuneCountInString() で事足ります。
文字列処理における注意点とベストプラクティス
文字列の長さを取得する目的は、多くの場合、スライス操作やバリデーションのためでしょう。
ここでは、文字列の長さを扱う際に陥りやすい罠と解決策をまとめます。
文字列のスライス操作
Go言語で str[0:3] のようにスライス操作を行うと、それは文字単位ではなくバイト単位での切り出しになります。
マルチバイト文字の途中のバイトで切り出してしまうと、不正な文字列(文字化け)が発生します。
安全にスライスを行うためには、一度 []rune 型に変換してから操作を行い、再度 string 型に戻す手法がよく取られます。
// 安全な文字列の切り出し方法
package main

import "fmt"

func main() {
    str := "Gopherの冒険"

    // 不適切な切り出し(バイト単位)
    badSlice := str[0:7]

    // 安全な切り出し(rune単位)
    runes := []rune(str)
    goodSlice := string(runes[0:7])

    fmt.Printf("バイト単位(失敗): %s\n", badSlice)
    fmt.Printf("Rune単位(成功): %s\n", goodSlice)
}バイト単位(失敗): Gopher
Rune単位(成功): Gopherのfor range による反復処理
文字列を1文字ずつ処理する場合、for i := 0; i < len(str); i++ というループは避けるべきです。
この記述ではバイトごとのアクセスになり、日本語を正しく扱えません。
Go言語の for range 構文を使用すると、自動的にUTF-8をデコードして rune 単位で反復処理を行ってくれます。
文字列の各文字を処理しながらインデックスやカウントを行いたい場合は、常に for range を活用しましょう。
文字列カウント手法の比較一覧
目的や対象とする文字の種類に応じて、最適な手法を選択できるように、以下の比較表を参考にしてください。
| 手法 | 取得できる値 | 計算量 | 主な用途 |
|---|---|---|---|
len(s) | バイト数 | O(1) | メモリサイズ、バイナリ処理、DBバイト制限確認 |
utf8.RuneCountInString(s) | Unicodeコードポイント数 | O(n) | 一般的な文字数カウント、入力バリデーション |
[]rune(s) への変換 | runeスライスの長さ | O(n) | 文字列の安全な切り出し、特定位置へのアクセス |
| 外部ライブラリ (uniseg等) | 書記素クラスター数 | O(n) | 高度な絵文字処理、UI上での厳密な表示幅計算 |
このように、Go言語では「何をもって長さとするか」を開発者が明示的に選ぶ必要があります。
特にWebアプリケーションの開発においては、フロントエンドとの文字数カウントの整合性に注意を払ってください。
JavaScriptの .length プロパティはUTF-16のコードユニット数を返すため、Go言語の RuneCountInString ともまた異なる結果を返す場合があります。
システム全体で「文字数」の定義を統一することが、バグの少ない開発への第一歩となります。
まとめ
Go言語における文字列の長さ取得は、単なる数値の取得以上の意味を持ちます。
組み込みの len() 関数はバイト数を取得するためのものであり、マルチバイト文字を含む日本語の文字数カウントには適していません。
日本語の文字数を正しく数えるには、unicode/utf8 パッケージの RuneCountInString() を使用するのが標準的な方法です。
また、文字列を操作する際には、バイト単位のスライスによる文字化けを防ぐため、rune型への変換や for range の活用が重要となります。
さらに厳密な「見た目上の文字数」を扱う必要がある場合には、書記素クラスターの概念を考慮し、外部ライブラリの利用も検討しましょう。
用途に応じてこれらの手法を適切に使い分けることで、文字化けや境界値による不具合のない、堅牢なGoプログラムを記述できるようになります。
この記事で紹介したテクニックを活用し、Go言語での文字列処理をマスターしてください。