
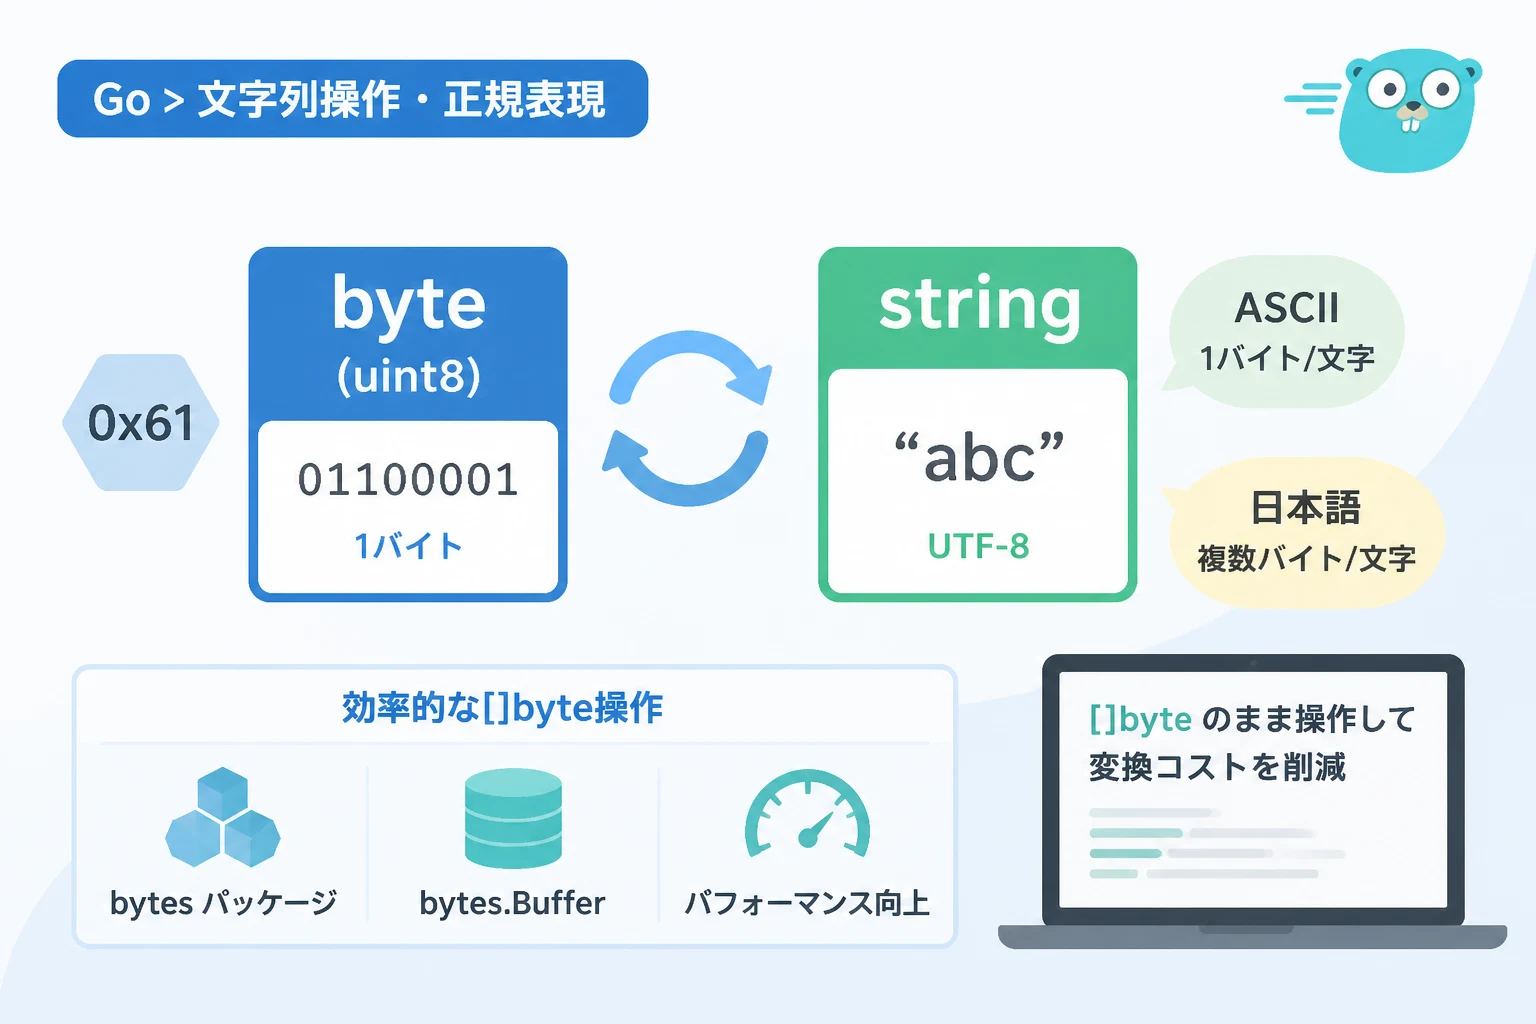
Go言語におけるbyte型は、プログラムの基礎を支える重要なデータ型の一つです。
特にネットワーク通信やファイル操作など、生のバイナリデータを扱う場面では欠かすことができません。
2026年現在、Go言語はクラウドネイティブな開発において不動の地位を築いていますが、そのパフォーマンスを最大限に引き出すためにはbyte型の深い理解が求められます。
本記事では、byte型の正体からstring型との変換メカニズム、そしてメモリ効率を意識した操作方法までを詳しく解説します。
初心者の方から、より高速なコードを書きたい中級者の方まで、実務に役立つ知識を整理していきましょう。
Go言語におけるbyte型の正体
まず、Go言語におけるbyte型がどのような定義を持っているのかを確認します。
実は、Go言語のbyte型はuint8型の別名 (エイリアス)です。
uint8型は8ビットの符号なし整数を意味しており、0から255までの数値を保持することができます。
Goのソースコード上では、以下のように定義されています。
// byte is an alias for uint8 and is equivalent to uint8 in all ways.
// It is used, by convention, to distinguish byte values from 8-bit unsigned integer values.
type byte = uint8
この定義からわかる通り、byte型とuint8型はプログラム上では完全に同一のものとして扱われます。
しかし、あえてbyte型という名前が用意されているのは、そのデータが「数値」ではなく「バイナリデータの1要素」であることを明示するためです。
例えば、画像ファイルのバイナリデータや、HTTPレスポンスのボディなどは、uint8の集まりとしてではなく、byteの集まりとして扱う方が意図が伝わりやすくなります。
byte型とASCII文字
byte型は、コンピューターが文字を扱う最小単位である1バイトと対応しています。
英数字を中心としたASCII文字コードは1バイトで表現されるため、byte型を使って直接文字を表現することが可能です。
package main

import "fmt"

func main() {
    var b byte = 'A'
    fmt.Printf("値: %v, 型: %T, 文字: %c\n", b, b, b)
}値: 65, 型: uint8, 文字: A上記のコードでは、文字 'A' をbyte型の変数に代入しています。
内部的にはASCIIコードの65として保持されますが、%c フォーマット指定子を使うことで文字として出力できます。
byte型とrune型の決定的な違い
Go言語で文字を扱う際、byte型と共によく登場するのが rune 型です。
この2つの違いを正しく理解しておくことは、日本語などの多バイト文字を扱う上で非常に重要です。
結論から述べると、byteは1バイト (8ビット) を表し、runeは1つのUnicodeコードポイント (4バイト) を表します。
マルチバイト文字の扱い
英語圏の文字は1バイトで収まりますが、日本語のひらがなや漢字は、UTF-8エンコーディングにおいて通常3バイトを消費します。
そのため、日本語の1文字をbyte型に格納しようとすると、データが欠落してしまいます。
package main

import "fmt"

func main() {
    s := "あ"
    fmt.Printf("文字列 '%s' のバイト長: %d\n", s, len(s))

    // runeとして扱う場合
    r := []rune(s)
    fmt.Printf("文字列 '%s' のルーン数: %d\n", s, len(r))
}文字列 'あ' のバイト長: 3
文字列 'あ' のルーン数: 1このように、「あ」という1文字はbyte単位で見ると3要素分必要ですが、rune単位で見ると1要素で済みます。
以下の表で、両者の違いを整理しました。
| 特徴 | byte型 | rune型 |
|---|---|---|
| 基底となる型 | uint8 | int32 |
| サイズ | 1バイト | 4バイト |
| 主な用途 | バイナリデータ、ASCII文字 | Unicode文字 (日本語など) |
| リテラル表記 | ‘a’ (ASCII) | ‘あ’ (Unicode) |
string型と[]byteの相互変換
Go言語の実務において最も頻繁に行われる操作の一つが、string と []byte (byteのスライス) の変換です。
多くの標準ライブラリ、例えば io.Reader や os.ReadFile はデータを []byte として返します。
一方で、画面に出力したり文字列操作を行ったりする場合は string 型の方が便利です。
基本的な変換方法
最もシンプルな変換方法は、型キャストを使用することです。
package main

import "fmt"

func main() {
    // string から []byte への変換
    str := "Hello, Go!"
    b := []byte(str)
    fmt.Println(b)

    // []byte から string への変換
    newStr := string(b)
    fmt.Println(newStr)
}[72 101 108 108 111 44 32 71 111 33]
Hello, Go!この変換は非常に直感的ですが、内部的にはメモリのコピーが発生している点に注意が必要です。
Goの string はイミュータブル (不変) ですが、[]byte はミュータブル (可変) です。
もしコピーせずにメモリを共有してしまうと、スライスの内容を書き換えたときに文字列の内容まで変わってしまい、Goの安全性が損なわれるためです。
ゼロコピー変換のテクニック (Go 1.20以降)
パフォーマンスが極めて重要なアプリケーションでは、巨大なデータの変換に伴うコピーのコストを避けたい場合があります。
Go 1.20からは、unsafe パッケージを使用して、安全かつ効率的にコピーなしで変換を行う標準的な方法が提供されています。
package main

import (
    "fmt"
    "unsafe"
)

func main() {
    b := []byte("High Performance")

    // []byte から string へのゼロコピー変換
    s := unsafe.String(unsafe.SliceData(b), len(b))

    fmt.Println(s)
}
ただし、この方法で作成された文字列は、元のバイトスライスを変更すると内容が変化してしまいます。
「一度変換したら元のスライスを絶対に操作しない」という確信がある場合のみ使用してください。
通常の開発では、標準の string(b) を使用するのが最も安全です。
bytesパッケージによる効率的な操作
文字列の操作には strings パッケージがあるように、byteスライスの操作には bytes パッケージが用意されています。
[]byte を string に変換してから strings パッケージを使うのではなく、bytes パッケージで直接操作することで、不必要な型変換を減らすことができます。
よく使われる関数
bytes パッケージには、検索、比較、結合などの便利な関数が揃っています。
bytes.Contains(b, subslice): 指定したバイト列が含まれているか確認するbytes.Split(b, sep): 指定した区切り文字で分割するbytes.Join(subslices, sep): 複数のスライスを結合するbytes.HasPrefix(b, prefix): 特定のバイト列で始まっているか確認する
package main

import (
    "bytes"
    "fmt"
)

func main() {
    data := []byte("apple,orange,banana")

    // カンマで分割
    parts := bytes.Split(data, []byte(","))

    for _, part := range parts {
        fmt.Printf("要素: %s\n", part)
    }
}
このように []byte のまま処理を完結させることで、ガベージコレクション (GC) の負荷を抑えることが可能になります。
大量のバイトデータを扱う際のベストプラクティス
大量のデータを結合したり、繰り返し加工したりする場合、単純なスライスの追加 (append) は非効率になることがあります。
ここでは、より効率的にbyteデータを扱うためのツールを紹介します。
bytes.Bufferの活用
bytes.Buffer は、可変サイズのバイトバッファを提供します。
文字列やバイト列を少しずつ書き溜めて、最後にまとめて取得する場合に非常に適しています。
package main

import (
    "bytes"
    "fmt"
)

func main() {
    var buf bytes.Buffer

    buf.Write([]byte("Go"))
    buf.WriteString("プログラミング")
    buf.WriteByte('!')

    fmt.Println(buf.String())
}
bytes.Buffer を使用すると、内部でメモリの再割り当てを最適化してくれるため、+ 演算子や append を繰り返すよりも高速です。
初期キャパシティの指定
[]byte を make で作成する際、あらかじめ必要なサイズがわかっている場合はキャパシティを指定しましょう。
これにより、データの追加に伴うメモリの再確保回数を最小限に抑えることができます。
// 1024バイトのキャパシティを確保しておく
data := make([]byte, 0, 1024)
この小さな工夫が、高トラフィックなサーバーサイドのプログラムでは大きなパフォーマンスの差となって現れます。
まとめ
Go言語のbyte型は、単なる数値型以上の役割を担っています。
本記事では、byte型がuint8のエイリアスであること、rune型との違い、そしてstring型との変換方法について解説しました。
byte型を扱う際の重要ポイントを以下にまとめます。
- byte型は
uint8のエイリアスであり、1バイトのデータを表す。 - 日本語などの多バイト文字を扱う場合は、
byteではなくruneを意識する。 string(b)や[]byte(s)はメモリコピーを伴うため、大きなデータの変換には注意する。- 効率的な操作には
bytesパッケージやbytes.Bufferを積極的に活用する。
これらの特性を正しく理解して使い分けることで、Go言語らしいシンプルで高速なプログラムを記述できるようになります。
バイナリ操作は難しく感じられることもありますが、基本を押さえればこれほど強力なツールはありません。
ぜひ、日々の開発においてbyte型をマスターし、パフォーマンスの高いコードを目指してください。