
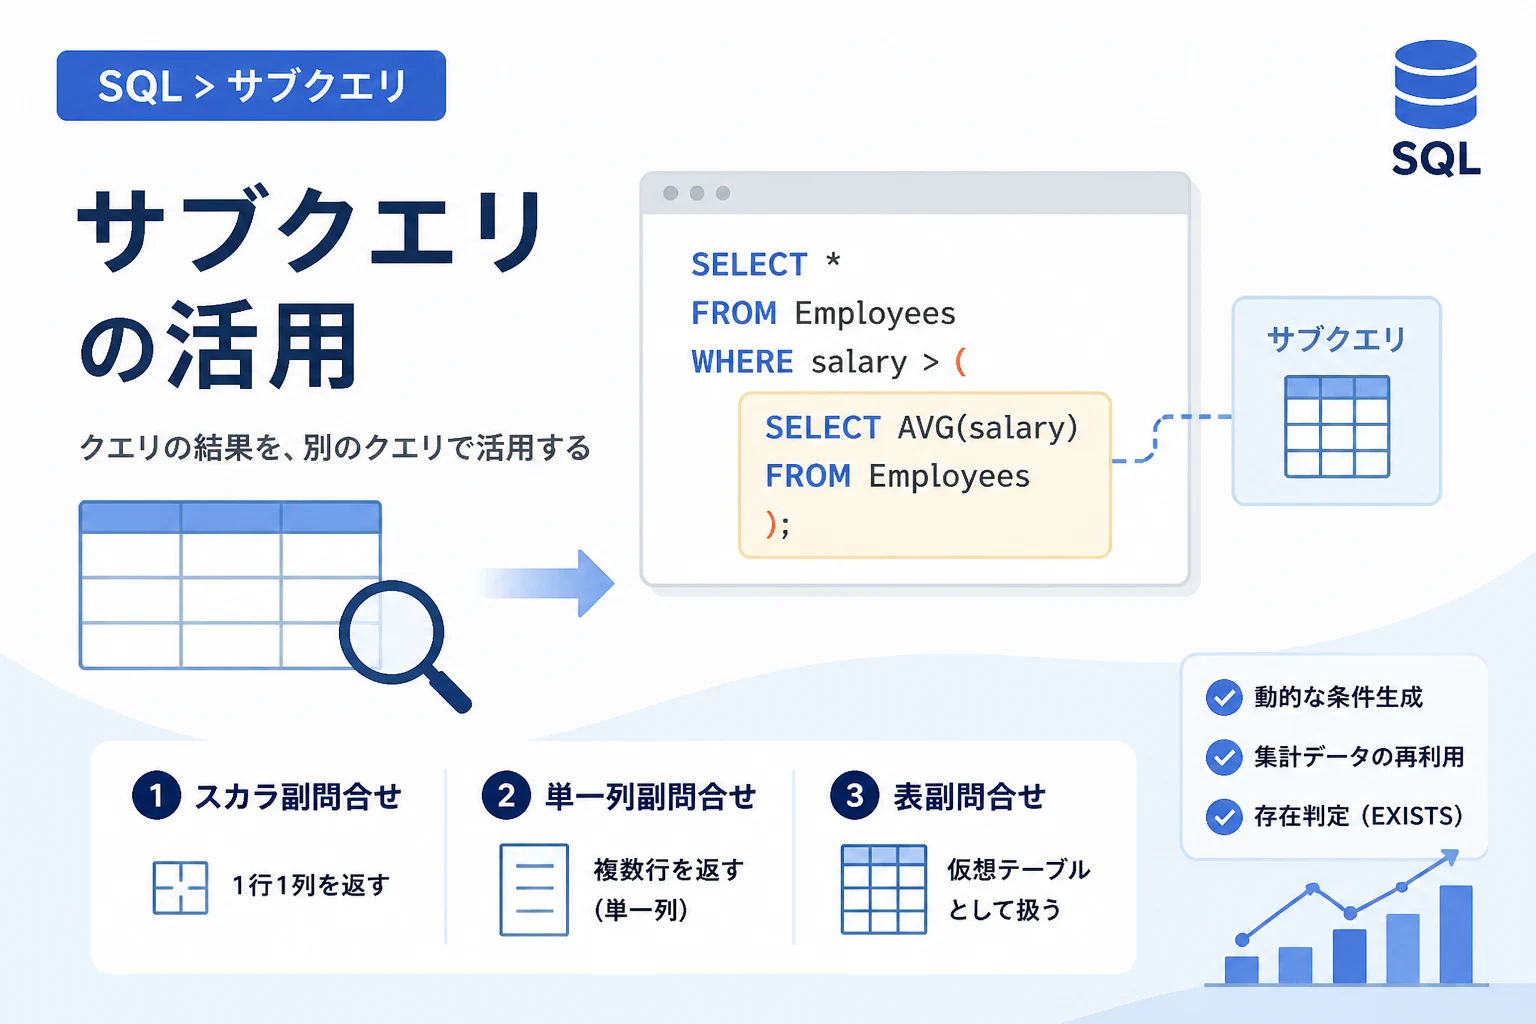
SQLを用いて複雑なデータ抽出を行う際、避けて通れないのが「副問合せ(サブクエリ)」という概念です。
単一のテーブルから単純な条件でデータを取得するだけであれば基本のSELECT文で十分ですが、複数の条件が絡み合う実務の現場では、あるクエリの結果を別のクエリで利用する手法が必要不可欠となります。
本記事では、副問合せの基礎知識から、具体的な書き方、そして実務で役立つ応用テクニックまでを詳しく解説します。
SQLの副問合せ(サブクエリ)とは
副問合せとは、SQL文の中に含まれる別のSELECT文のことを指します。
一般的に「サブクエリ」とも呼ばれ、クエリの結果を一時的な値やテーブルとして扱うことで、より高度なデータ操作を可能にします。
通常、SQLは「どのテーブルからどの列を取得するか」を記述しますが、副問合せを利用すると「計算した結果をもとに、さらに別の計算を行う」といった二段構えの処理が可能になります。
例えば、「全社員の平均給与を算出し、その平均給与よりも高い給与を受け取っている社員の一覧を取得する」といった操作は、副問合せなしでは1回のSQLで記述することが困難です。
副問合せは、主にSELECT、FROM、WHERE、HAVING句などの様々な場所で使用されます。
副問合せの基本的な記述ルール
副問合せを記述する際には、いくつか守らなければならない基本的なルールがあります。
これらを誤ると構文エラーの原因となるため、最初に確認しておきましょう。
- 副問合せは必ず半角の丸括弧 ( ) で囲むことが必須です。
- 副問合せの中には、さらに別の副問合せを記述する「ネスト(入れ子)」が可能です。
- 原則として、比較演算子と組み合わせる場合は、副問合せが返す行数や列数に注意する必要があります。
- 副問合せ内では、通常
ORDER BY句を使用することはできません(一部の例外を除く)。
これらのルールを踏まえた上で、副問合せの種類ごとの具体的な活用方法を見ていきましょう。
副問合せの主な種類
副問合せは、その「戻り値の形式」によって大きく3つのタイプに分類されます。
どのタイプを使用するかによって、組み合わせる演算子が異なります。
スカラ副問合せ
スカラ副問合せは、「1行1列」の単一の値を返す副問合せです。
数値や文字列などの単一のデータとして扱えるため、比較演算子(=, <, > など)と組み合わせて使用するのが一般的です。
単一列副問合せ(複数行副問合せ)
1列のみのデータを返しますが、行数は複数になるタイプです。
主にIN演算子やANY、ALL、EXISTSなどと組み合わせて使用します。
表副問合せ
複数行かつ複数列のデータを、あたかも一つの「テーブル」のように返すタイプです。
主にFROM句に記述され、一時的なビューとして活用されます。
WHERE句で副問合せを活用する
実務で最も頻繁に利用されるのが、WHERE句での副問合せです。
特定の条件に合致するデータを探す際、その条件自体を動的に生成したい場合に役立ちます。
比較演算子を用いたスカラ副問合せの例
例えば、商品テーブル (products) から「平均単価以上の商品」を抽出したい場合を考えてみましょう。
-- 平均単価以上の商品を抽出する
SELECT
    product_id,
    product_name,
    price
FROM
    products
WHERE
    price >= (
        -- ここが副問合せ:全体の平均単価を算出する
        SELECT AVG(price) FROM products
    );
このクエリでは、まず括弧内の副問合せが実行され、平均単価という「一つの値」が算出されます。
その後、メインのクエリ(外部クエリ)がその値を受け取り、比較処理を行います。
動的に変化する平均値という基準を条件に含められるのが大きな利点です。
IN演算子を用いた複数行副問合せの例
次に、部署テーブル (departments) と社員テーブル (employees) を使用し、「東京支店に所属する社員」を抽出する例を見てみましょう。
-- 東京支店に所属する社員の一覧を取得
SELECT
    employee_id,
    employee_name
FROM
    employees
WHERE
    dept_id IN (
        -- 東京支店の部署IDをすべて取得する
        SELECT dept_id FROM departments WHERE location = '東京'
    );
この場合、東京支店が複数存在する可能性があるため、副問合せは複数の値を返す可能性があります。
そのため、等号 (=) ではなく IN を使用します。
複数の候補の中から一致するものを探す処理に非常に適しています。
SELECT句で副問合せを活用する
SELECT句の中に副問合せを記述すると、取得する各行に対して特定の計算結果を列として付加することができます。
-- 社員名とともに、その社員が所属する部署の総人数を表示する
SELECT
    e.employee_name,
    e.dept_id,
    (
        SELECT COUNT(*)
        FROM employees e2
        WHERE e2.dept_id = e.dept_id
    ) AS dept_member_count
FROM
employees e;この手法は、メインのクエリで取得している行の値を、副問合せの中で参照する形になります。
これを「相関副問合せ」と呼びますが、これについては後ほど詳しく解説します。
FROM句で副問合せを活用する(インラインビュー)
FROM句に副問合せを記述すると、クエリの結果を一時的な仮想テーブルとして扱うことができます。
これを「インラインビュー」と呼びます。
-- 部署ごとの平均給与を算出した結果をテーブルとして扱い、さらに絞り込む
SELECT
    dept_avg.dept_id,
    dept_avg.avg_salary
FROM
    (
        SELECT
            dept_id,
            AVG(salary) AS avg_salary
        FROM
            employees
        GROUP BY
            dept_id
    ) AS dept_avg
WHERE
dept_avg.avg_salary > 500000;このように、一度集計したデータに対して、さらにフィルタリングや結合を行いたい場合に極めて有効です。
複雑な集計ロジックを段階的に記述できるため、可読性の向上にも寄与します。
相関副問合せの仕組みと注意点
相関副問合せは、副問合せの中で外部クエリの列を参照する特殊な形式です。
通常の副問合せが単独で実行可能であるのに対し、相関副問合せは外部クエリの各行に対して、1行ずつ副問合せが実行されるようなイメージで動作します。
相関副問合せの実用例
「各部署内で、その部署の平均給与よりも高い給与を得ている社員」を探すクエリを考えてみましょう。
-- 各部署の平均給与と比較して抽出する
SELECT
    e1.employee_name,
    e1.salary,
    e1.dept_id
FROM
    employees e1
WHERE
    e1.salary > (
        -- 外部クエリの「e1.dept_id」を使用して、その部署の平均を計算
        SELECT AVG(e2.salary)
        FROM employees e2
        WHERE e2.dept_id = e1.dept_id
    );
このクエリでは、外部の e1 テーブルから1行取り出すたびに、その部署IDに合致する平均を内部の副問合せで計算しています。
非常に強力な機能ですが、データ量が多い場合には実行回数が増えるため、パフォーマンスが低下しやすいという側面も持っています。
EXISTS演算子と副問合せ
副問合せの有無を判定する際に、EXISTS 演算子がよく使われます。
IN 演算子と似ていますが、EXISTS は「条件に合致する行が1つでも存在するかどうか」だけを確認し、データの取得自体は行わないため、効率的に動作することが多いです。
-- 注文履歴(orders)がある顧客(customers)だけを抽出する
SELECT
    c.customer_name
FROM
    customers c
WHERE
    EXISTS (
        SELECT 1
        FROM orders o
        WHERE o.customer_id = c.customer_id
    );
SELECT 1 と記述しているのは、具体的な値は何でもよいためです。
条件に合う行が見つかった瞬間にその行の判定を終了するため、大量のデータを扱う際の存在チェックにおいて、優れたパフォーマンスを発揮します。
副問合せと結合(JOIN)の使い分け
副問合せで実現できることの多くは、JOIN(結合)でも実現可能です。
どちらを使うべきか迷う場面も多いですが、一般的には以下の観点で選択します。
| 手法 | 適したケース | 特徴 |
|---|---|---|
| 副問合せ | 集計した値を条件に使いたい、単純な存在チェックなど | 階層構造が分かりやすく、一時的な値を利用するのに便利 |
| JOIN | 複数のテーブルから同時に列を取得して表示したい場合 | 多くのRDBMSで最適化されやすく、大量データの処理に向く |
一般に、表示したい項目が複数のテーブルにまたがる場合はJOINを、フィルタリングの基準として別テーブルの値を使いたいだけの場合は副問合せを選択すると、SQLの意図が明確になります。
最新のSQL標準:CTE(共通テーブル式)との関係
2020年代以降のモダンなSQL開発において、複雑な副問合せの代わりに多用されているのがCTE(Common Table Expression:共通テーブル式)です。
WITH句を用いて記述します。
-- CTEを用いた、FROM句副問合せの書き換え例
WITH DeptAvg AS (
    SELECT
        dept_id,
        AVG(salary) AS avg_salary
    FROM
        employees
    GROUP BY
        dept_id
)
SELECT
    *
FROM
    DeptAvg
WHERE
avg_salary > 500000;CTEを使用すると、「まず何をして、次に何をするか」という思考の流れに沿ってSQLを記述できるため、副問合せのネストが深くなって読みづらくなる(いわゆるスパゲッティコード化する)のを防ぐことができます。
副問合せを使用する際のパフォーマンスと注意点
副問合せは便利ですが、使い方を誤るとシステムのレスポンスを著しく悪化させることがあります。
以下の点に留意して設計しましょう。
1. インデックスの活用
副問合せの結合条件やフィルタ条件に使用される列には、適切にインデックスを貼っておくことが重要です。
特に相関副問合せの場合、インデックスがないとフルスキャンが繰り返され、致命的な遅延を招きます。
2. NULL値の扱いに注意
NOT IN を使用する際、副問合せの結果に NULL が含まれていると、外部クエリの結果が常に空になってしまうという罠があります。
これを避けるために、副問合せ内で IS NOT NULL 条件を明示するか、NOT EXISTS への書き換えを検討しましょう。
3. 可読性の維持
副問合せが3重、4重と重なると、後からコードをメンテナンスするのが非常に困難になります。
ネストが深くなりすぎた場合は、ビューの作成やCTEの利用、あるいは処理を分割することを検討してください。
まとめ
SQLの副問合せ(サブクエリ)は、データベース操作の柔軟性を飛躍的に高めてくれる強力な武器です。
- スカラ副問合せは単一の値を条件に使う際に利用する。
- 複数行副問合せは
INやEXISTSと組み合わせてリスト判定を行う。 - インラインビューは集計済みデータを仮想テーブルとして扱う。
- 相関副問合せは行ごとの複雑な比較に使うが、負荷に注意が必要。
これらの特徴を理解し、状況に応じてJOINやCTEと使い分けることが、エンジニアとしてのスキルアップに繋がります。
まずは身近な集計クエリから副問合せを取り入れ、その便利さを実感してみてください。