
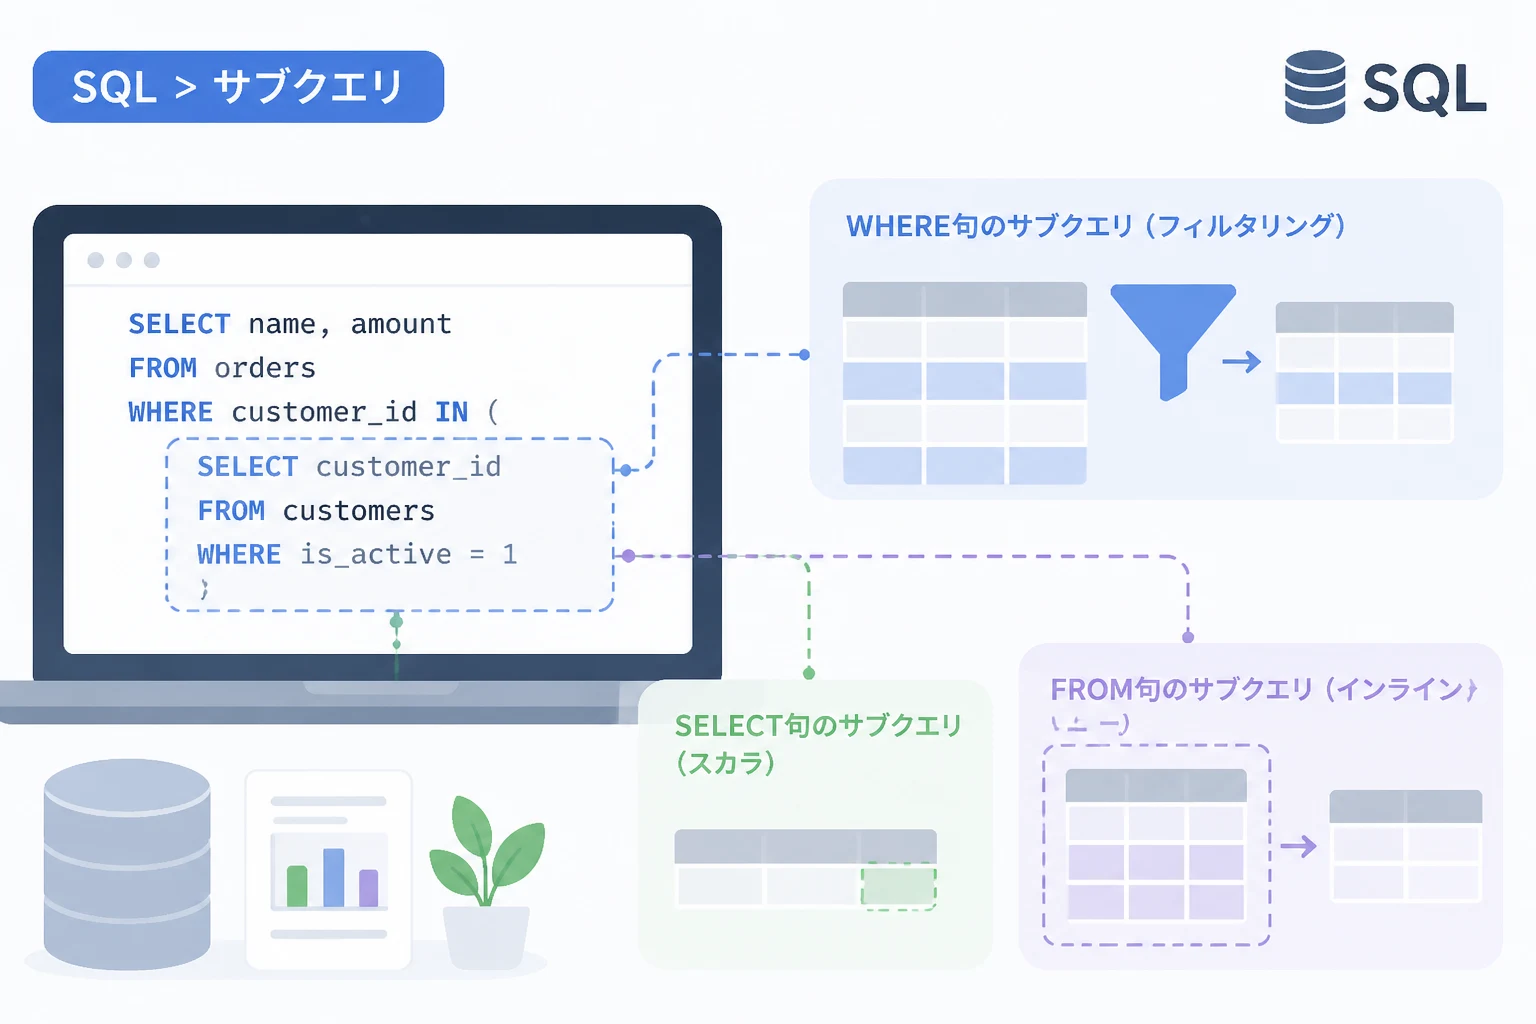
SQLを利用してデータベースから複雑なデータを抽出する際、避けては通れない重要な概念が「サブクエリ(副問合せ)」です。
サブクエリを使いこなすことができれば、複数のステップが必要なデータ操作を一つのSQL文で完結させることが可能になり、開発効率やコードの可読性が飛躍的に向上します。
本記事では、SQL初学者から中級者へステップアップを目指す方に向けて、サブクエリの基本的な仕組みから、SELECT句・FROM句・WHERE句での具体的な書き方、さらには実務で役立つ相関サブクエリやCTE(共通テーブル式)との使い分けまで詳しく解説します。
2026年現在のモダンなデータベース環境においても、サブクエリの理解はデータ分析やシステム開発の基盤となります。
サブクエリ(副問合せ)の基本概念
サブクエリとは、一言で言えば「SQL文の中に含まれる別のSQL文」のことです。
通常のクエリがテーブルから直接データを取得するのに対し、サブクエリは「あるクエリの実行結果を別のクエリで利用する」という入れ子構造(ネスト)を持っています。
サブクエリが解決する課題
例えば、「平均売上以上の商品一覧を取得したい」というケースを考えてみましょう。
この場合、以下の2つのステップが必要になります。
- 全商品の平均売上を計算する
- その計算結果を使って、商品を絞り込む
サブクエリを使わない場合、一度プログラム側で平均値を保持してから再度クエリを投げる必要がありますが、サブクエリを使えば一度の実行で完結させることができます。
基本的な構造
サブクエリは基本的にカッコ () で囲んで記述します。
外側のクエリを「メインクエリ(主問合せ)」、内側のクエリを「サブクエリ(副問合せ)」と呼びます。
-- 基本イメージ
SELECT カラム名
FROM テーブル名
WHERE カラム名 = (SELECT カラム名 FROM テーブル名 WHERE 条件);
記述場所によるサブクエリの種類
サブクエリはSQL文のさまざまな場所に記述できます。
記述する場所によって、その役割や返却されるデータの形式が異なります。
SELECT句でのサブクエリ(スカラ・サブクエリ)
SELECT句に記述するサブクエリは、単一の値を返す必要があります。
これをスカラ・サブクエリと呼びます。
各行に対して特定の集計値などを付与したい場合に便利です。
-- 社員一覧を表示し、各社員の給与と全社員の平均給与の差を表示する
SELECT
    employee_name,
    salary,
    (SELECT AVG(salary) FROM employees) AS avg_salary,
    salary - (SELECT AVG(salary) FROM employees) AS diff
FROM employees;| employee_name | salary | avg_salary | diff |
|---|---|---|---|
| 田中 | 300000 | 250000 | 50000 |
| 佐藤 | 200000 | 250000 | -50000 |
注意点として、SELECT句のサブクエリが複数の行や複数のカラムを返すとエラーになります。
必ず「1行1列」の結果を返すように設計してください。
FROM句でのサブクエリ(インラインビュー)
FROM句にサブクエリを記述すると、その結果を「一時的なテーブル」として扱うことができます。
これをインラインビューと呼びます。
複雑な集計結果を一度作成し、それに対してさらに結合(JOIN)やフィルタリングを行いたい場合に有効です。
-- カテゴリごとの平均給与を算出し、その結果を元に高給与カテゴリを表示
SELECT
    sub.category_id,
    sub.avg_salary
FROM (
    -- ここがサブクエリ
    SELECT
        category_id,
        AVG(salary) AS avg_salary
    FROM employees
    GROUP BY category_id
) AS sub
WHERE sub.avg_salary > 250000;FROM句でサブクエリを使用する場合、多くのデータベース製品(MySQLやPostgreSQLなど)ではサブクエリにエイリアス(別名)を付けることが必須となります。
WHERE句でのサブクエリ
実務で最も多用されるのがWHERE句でのサブクエリです。
特定の条件に合致するデータを動的に特定するために使用します。
単一の値を比較する場合
-- 最も高い給与を受け取っている社員を取得
SELECT employee_name
FROM employees
WHERE salary = (SELECT MAX(salary) FROM employees);
複数の値と比較する場合(IN句)
-- 2026年に注文があった顧客のみを抽出
SELECT customer_name
FROM customers
WHERE customer_id IN (
    SELECT customer_id
    FROM orders
    WHERE order_date >= '2026-01-01'
);
相関サブクエリの仕組みと活用法
サブクエリの中でも少し特殊で強力なのが「相関サブクエリ」です。
通常のサブクエリは内側だけで独立して実行可能ですが、相関サブクエリはメインクエリのカラムを参照しながら動作します。
相関サブクエリの動作イメージ
メインクエリが1行処理されるごとに、その行の値を使ってサブクエリが実行されるというループのような動きをします。
-- 各部署内で、その部署の平均給与よりも高い給与の社員を抽出
SELECT
    e1.employee_name,
    e1.department_id,
    e1.salary
FROM employees AS e1
WHERE e1.salary > (
    -- メインクエリの department_id を参照している
    SELECT AVG(e2.salary)
    FROM employees AS e2
    WHERE e2.department_id = e1.department_id
);
このクエリでは、社員Aさんのデータをチェックする際、サブクエリが「Aさんの所属部署の平均」を計算します。
次に社員Bさんをチェックする際は「Bさんの所属部署の平均」を再計算します。
EXISTS句による存在チェック
相関サブクエリの代表的な活用例が EXISTS 演算子です。
条件に一致するデータが「存在するかどうか」だけを判定するため、大量のデータを扱う際にパフォーマンス面で有利になることがあります。
-- 過去に一度でも注文(orders)をしたことがある顧客(customers)を取得
SELECT c.customer_name
FROM customers AS c
WHERE EXISTS (
    SELECT 1
    FROM orders AS o
    WHERE o.customer_id = c.customer_id
);
SELECT 1 と記述しているのは、データの値自体は不要で「行が存在するか」だけを知りたいためです。
サブクエリ使用時の注意点とパフォーマンス
サブクエリは非常に便利ですが、多用しすぎるとパフォーマンス劣化やコードの複雑化を招く恐れがあります。
実行速度への影響
特に相関サブクエリは、メインクエリの行数分だけサブクエリが繰り返し実行される可能性があるため、大量のデータに対して使用すると処理が非常に重くなることがあります。
2026年現在の最新のデータベースエンジン(PostgreSQL 17+ や最新のクラウドDWHなど)では、クエリオプティマイザがサブクエリを内部的に結合(JOIN)へ書き換えて最適化してくれることが多いですが、それでも以下の点に注意が必要です。
- インデックスが適切に貼られているか確認する。
- 同じサブクエリを何度も書かず、共通化を検討する。
- 結合(JOIN)で書き換えられる場合は、JOINの方が可読性・速度ともに優れるケースが多い。
可読性の低下(ネストの深さ)
サブクエリの中にさらにサブクエリを書くといった「深いネスト」は、後からコードを読む人にとっての大きな負担になります。
目安として3段階以上のネストが発生する場合は、次に紹介するCTEの利用を検討すべきです。
モダンSQLの標準:CTE(共通テーブル式)との使い分け
近年の実務現場では、サブクエリの代わりにCTE(Common Table Expressions)を使用することが推奨されています。
CTEは WITH 句を用いて、クエリの冒頭で一時的な結果セットを定義する手法です。
サブクエリとCTEの比較
**サブクエリ(FROM句)の場合:**
SELECT *
FROM (SELECT category_id, COUNT(*) as cnt FROM products GROUP BY category_id) AS sub
WHERE cnt > 10;
**CTEの場合:**
WITH category_counts AS (
    SELECT category_id, COUNT(*) as cnt
    FROM products
    GROUP BY category_id
)
SELECT *
FROM category_counts
WHERE cnt > 10;
CTEを使うメリット
- 可読性の向上:クエリを上から下へ論理的な順序で読めるようになります。
- 再利用性:一度定義したCTEは、同じメインクエリ内で何度も参照できます。
- 再帰クエリ:サブクエリでは困難な「階層構造のデータ(組織図など)」の取得が可能です。
2026年のシステム開発においては、メンテナンス性の観点から「複雑な処理はCTE、単純な絞り込みはサブクエリ」という使い分けがデファクトスタンダードとなっています。
実務で役立つ具体的な活用シナリオ
シナリオ1:ランキングや上位データの抽出
「各カテゴリで最も価格が高い商品を取得したい」といった場合、サブクエリが力を発揮します。
-- 各カテゴリの最高価格に一致する商品情報を取得
SELECT product_name, category_id, price
FROM products
WHERE (category_id, price) IN (
    SELECT category_id, MAX(price)
    FROM products
    GROUP BY category_id
);
このように、複数のカラムを一度に比較する「行値比較」もサブクエリならスムーズに記述できます。
シナリオ2:データのクリーニングと重複削除
重複しているレコードのうち、最新のIDだけを残して他を抽出するといった処理にもサブクエリは欠かせません。
-- 重複するメールアドレスの中で、最も古いID以外のレコードを特定
SELECT id, email
FROM users
WHERE id NOT IN (
    SELECT MIN(id)
    避けては通れない
    FROM users
    GROUP BY email
);
まとめ
SQLサブクエリ(副問合せ)は、データベース操作の柔軟性を大幅に高めてくれる強力なツールです。
本記事で解説した以下のポイントを振り返りましょう。
- スカラ・サブクエリはSELECT句などで単一の値を返すために使う。
- インラインビューはFROM句で一時的なテーブルとして使う。
- 相関サブクエリはメインクエリの行と連動して動的な条件を作る。
- パフォーマンスと可読性を考慮し、複雑な場合はCTE(WITH句)への書き換えを検討する。
2026年のデータ活用シーンでは、AIによるクエリ自動生成も普及していますが、その生成されたクエリが「なぜサブクエリを使っているのか」「効率的なのか」を判断する力は、依然としてエンジニアやアナリストにとって必須のスキルです。
まずはシンプルなWHERE句のサブクエリから書き始め、徐々に構造を理解して、より高度なデータ抽出に挑戦してみてください。