
SQLは単なるデータの抽出ツールではなく、複雑なビジネスロジックをデータベース層で効率的に処理するための強力な言語です。
その中でも、一つのSQL文の中に別のSQL文を組み込む「副問合せ(サブクエリ)」は、高度なデータ分析や柔軟な条件抽出を実現するために欠かせない技術です。
一方で、主問合せ(メインクエリ)と副問合せの関係性を正しく理解していないと、意図しない結果を招いたり、システムのパフォーマンスを著しく低下させたりするリスクもあります。
本記事では、基本的な副問合せの書き方から、中級者へのステップアップに不可欠な「相関副問合せ」の仕組み、そして2026年現在の開発現場で求められる効率的な使い分けまでを詳しく解説します。
副問合せの基本概念と主問合せとの関係
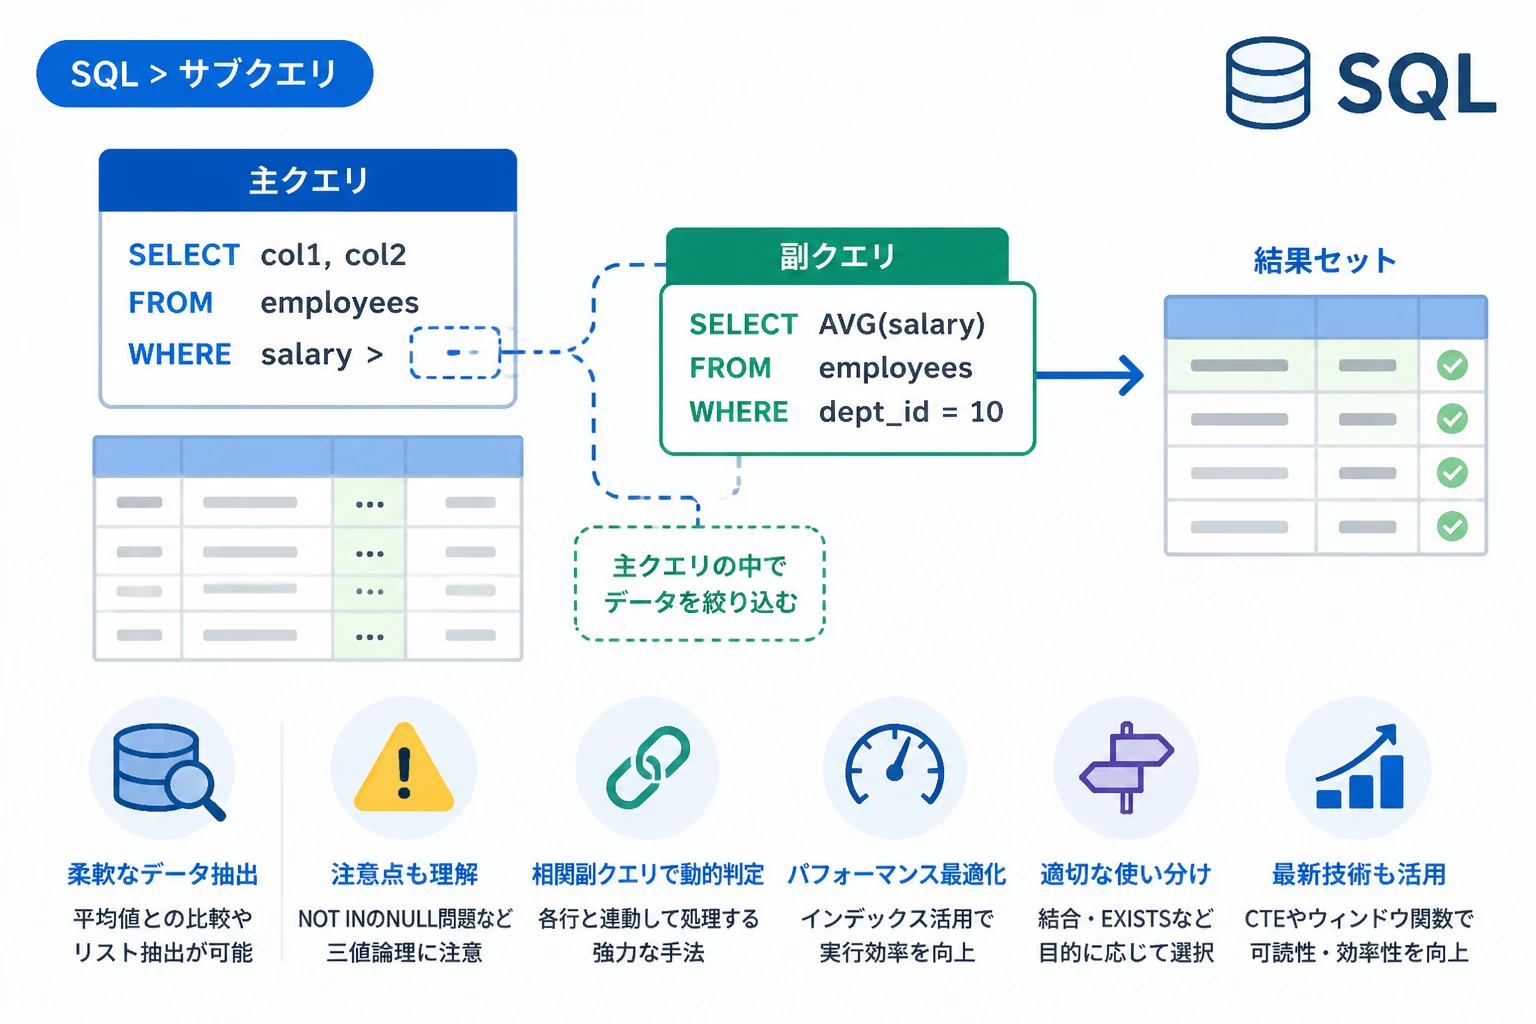
SQLにおける副問合せとは、SELECT文やINSERT文、UPDATE文などの内部に含まれる、別のSELECT文のことを指します。
これに対して、その副問合せを内包している外側のSQL文を「主問合せ」と呼びます。
通常、SQLは一つの命令で一つの結果セットを操作しますが、副問合せを利用することで「ある検索結果を、別の検索の条件として使う」といった2段階の処理を一度のクエリで実行できるようになります。
副問合せが実行される順序
基本的な副問合せ(非相関副問合せ)の場合、データベースエンジンはまず副問合せを先に実行します。
その実行結果を確定させた後、その値を主問合せに受け渡し、最終的な抽出処理を行います。
この「内側から外側へ」という実行フローを理解することが、複雑なクエリを読み解く第一歩となります。
スカラ副問合せ:単一の値を返す最もシンプルな形式
最も利用頻度が高く理解しやすいのが、スカラ副問合せです。
これは、副問合せの結果として「1行1列」の単一の値(スカラ値)のみを返す形式です。
WHERE句での活用例
例えば、「平均単価よりも高い商品の一覧を取得したい」というケースを考えてみましょう。
平均単価はデータによって常に変動するため、固定値で指定することはできません。
-- 平均価格より高い商品を取得する
SELECT
    product_id,
    product_name,
    price
FROM
    products
WHERE
    -- 副問合せで平均価格を算出
    price > (
        SELECT
            AVG(price)
        FROM
            products
    );
このクエリの実行結果イメージは以下の通りです。
| product_id | product_name | price |
|---|---|---|
| P001 | 高機能オフィスチェア | 45000 |
| P005 | 昇降式デスク | 58000 |
この例では、まずカッコ内の副問合せが実行されて平均価格(例:32000円)が算出されます。
その後、主問合せの WHERE price > 32000 が評価される仕組みです。
SELECT句での活用例
スカラ副問合せは、SELECT句の中で「計算結果を列として追加する」際にも利用されます。
-- 各商品の価格と、全体の平均価格を並べて表示する
SELECT
    product_name,
    price,
    (SELECT AVG(price) FROM products) AS avg_price
FROM
    products;
このように記述することで、各行の横に全体の統計情報を並べることができ、データの比較が容易になります。
ただし、行数が多いテーブルでこれを行うと、DBMSの最適化能力によっては処理が重くなる場合があるため注意が必要です。
複数行副問合せ:INやANY/ALLを用いた条件抽出
副問合せの結果が1つではなく、複数の値(1列複数行)を返す場合は、比較演算子(=, <, > など)をそのまま使うことはできません。
代わりに IN や ANY、ALL といった演算子を使用します。
IN演算子によるフィルタリング
特定の条件に合致する「リスト」の中に含まれているかどうかを判定します。
-- 2026年5月に注文があった商品のみを取得する
SELECT
    product_name
FROM
    products
WHERE
    product_id IN (
        SELECT
            product_id
        FROM
            orders
        WHERE
            order_date >= '2026-05-01'
            AND order_date <= '2026-05-31'
    );
このクエリは、「注文テーブルから5月分の商品ID一覧を抽出し、そのいずれかに合致する商品を商品テーブルから探す」という動きをします。
NOT IN 使用時の注意点とNULLの罠
副問合せを利用する際、最も注意すべきなのが NULL の扱いです。 特に NOT IN を使用する際、副問合せの結果セットに一つでも NULL が含まれていると、主問合せの結果が常に空(0件)になってしまうという仕様があります。
これはSQLの三値論理(True, False, Unknown)に起因する挙動であり、実務でハマりやすいポイントです。
2026年の最新のSQL実装でもこの挙動は変わっていないため、「副問合せの結果にNULLが含まれる可能性がある場合は、必ずIS NOT NULLで除外するか、EXISTSを使用する」というルールを徹底しましょう。
FROM句での副問合せ:派生テーブルの活用
副問合せは、WHERE句だけでなくFROM句にも記述できます。
これを派生テーブル(またはインラインビュー)と呼びます。
データベース上の物理的なテーブルではなく、SQL実行時に一時的に作られる「仮想的なテーブル」として扱います。
-- カテゴリ別の平均価格を算出し、その平均が10,000円以上のカテゴリのみ詳細を表示
SELECT
    temp.category_id,
    temp.avg_category_price
FROM
    (
        SELECT
            category_id,
            AVG(price) AS avg_category_price
        FROM
            products
        GROUP BY
            category_id
    ) AS temp
WHERE
    temp.avg_category_price >= 10000;
このように、一度集計した結果に対してさらに条件を絞り込みたい場合に非常に有効です。
なお、近年の開発では可読性の観点から、FROM句の副問合せの代わりに WITH句(共通テーブル式:CTE) を使うことが推奨されるケースも増えています。
相関副問合せ:主問合せと連動する高度なテクニック
副問合せの中でも、最も強力かつ複雑なのが相関副問合せです。
これまでの副問合せは「内側だけで独立して実行可能」でしたが、相関副問合せは「主問合せの各行の値を参照しながら、副問合せが実行される」という特徴を持ちます。
相関副問合せの具体例
「各カテゴリの中で、そのカテゴリの平均価格よりも高い商品」を探すクエリを見てみましょう。
-- 自分の所属するカテゴリの平均価格より高い商品を取得
SELECT
    p1.category_id,
    p1.product_name,
    p1.price
FROM
    products p1
WHERE
    p1.price > (
        SELECT
            AVG(p2.price)
        FROM
            products p2
        WHERE
            -- ここが重要:主問合せのカテゴリIDと副問合せのカテゴリIDを紐付け
            p2.category_id = p1.category_id
    );
このクエリでは、主問合せ(p1)の1行ごとに、その商品の category_id を副問合せ(p2)に渡しています。
副問合せはそのIDを受け取り、そのカテゴリだけの平均価格を計算して返します。
EXISTS演算子との組み合わせ
相関副問合せは、データの存在確認を行う EXISTS と組み合わせて使われることが非常に多いです。
-- 過去に一度も注文されたことがない商品(在庫のみの商品)を特定する
SELECT
    p.product_id,
    p.product_name
FROM
    products p
WHERE
    NOT EXISTS (
        SELECT
            1
        FROM
            orders o
        WHERE
            o.product_id = p.product_id
    );
EXISTS は、条件に合致する行が「1行でも見つかった瞬間に評価を終了する」ため、大量のデータを扱う際に IN よりも高いパフォーマンスを発揮することがあります。
副問合せと結合(JOIN)の使い分け技術
「副問合せで書けることは、結合(JOIN)でも書ける」と言われることがよくあります。
しかし、どちらを使うべきかは状況によって異なります。
2026年現在のベストプラクティスを整理します。
結合(JOIN)を選択すべきケース
- 複数のテーブルから列を表示したい場合: 副問合せは基本的に一つのテーブルの列しか主問合せに返せませんが、JOINなら結合した両方のテーブルの列を自由にSELECTできます。
- パフォーマンスが優先される場合: 多くのRDBMSではJOINの方がオプティマイザによる最適化を受けやすく、特にインデックスが適切に貼られている場合は結合の方が高速です。
副問合せを選択すべきケース
- 集計結果に基づいたフィルタリングを行う場合: 前述の「平均値との比較」などは、副問合せの方が直感的に記述できます。
- 存在チェックを行う場合:
EXISTSを用いた相関副問合せは、重複行が発生する心配がなく、存在の有無だけを判定するロジックに最適です。JOINを使うと、多対多の関係などで意図せず行数が増えてしまう(デカルト積に近い状態になる)リスクがあります。
パフォーマンスを最大化するための注意点
副問合せ、特に相関副問合せは強力ですが、書き方を誤ると「N+1問題」のようなパフォーマンス劣化を引き起こします。
主問合せが100万行ある場合、相関副問合せも100万回実行される可能性があるからです。
以下のポイントを意識してクエリを設計しましょう。
- 相関副問合せの内部で参照する列にはインデックスを貼る: 結合キーとなる列にインデックスがないと、実行のたびにフルテーブルスキャンが発生します。
- 可能な限りウィンドウ関数(分析関数)を検討する: 2026年時点のモダンなSQL環境(PostgreSQL 15+, MySQL 8.0+, Oracleなど)であれば、副問合せを使わずに
OVER()句を用いたウィンドウ関数で解決できるケースが多いです。ウィンドウ関数の方が一度のスキャンで済むため、多くの場合で高速です。 - 副問合せの階層を深くしすぎない: 3層、4層と重なった副問合せは、人間にとっても読みづらく、DBMSの実行計画も不安定になりがちです。
まとめ
SQLの主問合せと副問合せを使い分ける技術は、単なる構文の知識ではなく、データの「評価の順序」と「スコープ」をコントロールする技術です。
- 単一の値が必要ならスカラ副問合せ
- リストに基づいた抽出ならIN句(ただしNULLに注意)
- 行ごとの動的な判定なら相関副問合せ
- 存在判定ならEXISTS
これらを適切に使い分けることで、複雑な抽出条件もシンプルに記述できるようになります。
まずは基本となる非相関副問合せからマスターし、徐々に相関副問合せやウィンドウ関数へとステップアップしていきましょう。
データ構造に合わせた最適なクエリを書くことが、保守性の高い、高速なシステムの構築に繋がります。