
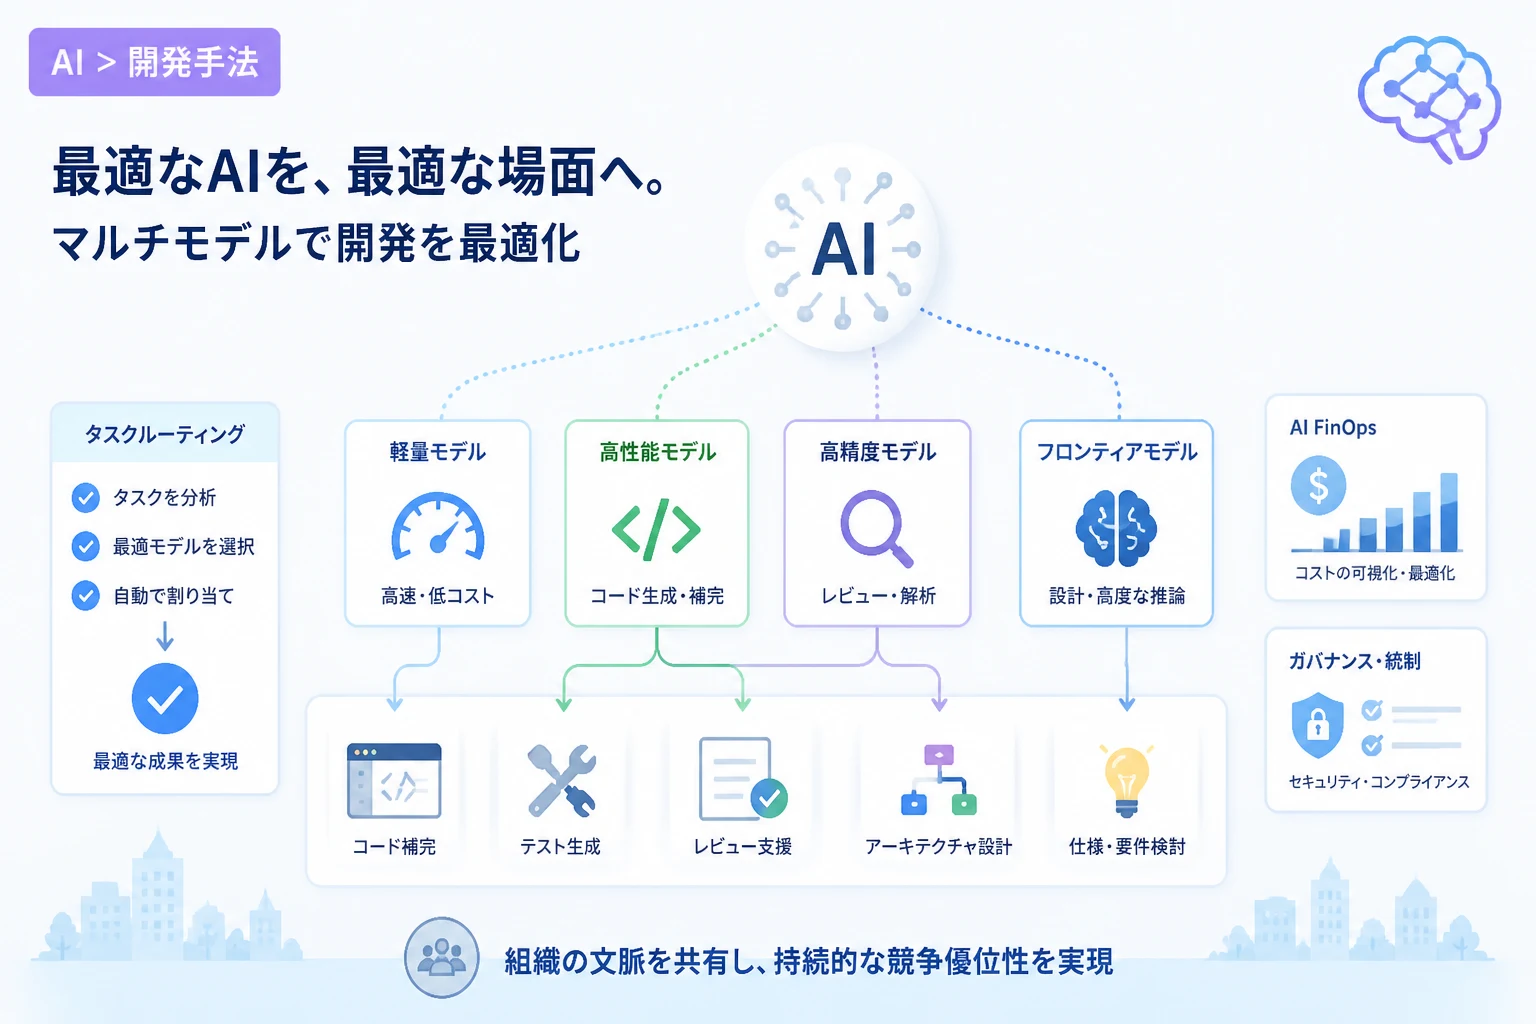
企業がAI導入を加速させる中で、多くの組織がかつてのエンタープライズ・ソフトウェア導入と同じ轍を踏もうとしています。
特定のベンダーを選定し、単一のモデルで標準化を図り、それを組織全体に展開するという手法です。
しかし、一つのモデルですべての課題を解決できるという前提は、現代の複雑な開発環境においては通用しなくなっています。
最新の知見に基づけば、エンタープライズAIの真の価値を引き出す鍵は、「マルチモデル」によるカスタマイズと最適化にあります。
AI導入における「パラドックス」と開発ライフサイクルの現実
現在、多くの企業におけるAI活用は、ソースコードの生成を加速させることだけに焦点が当てられています。
しかし、開発者が実際にコードを書いている時間は、業務全体のわずか15%に過ぎないという調査結果があります。
残りの85%は、プランニング、コードレビュー、テスト、デバッグ、依存関係の管理、チーム間調整、そしてコンプライアンス対応に費やされています。
ここに「AIパラドックス」が生じています。
コード生成だけが加速しても、ツールチェーンの分断や手動の調整作業が残っていれば、全体の生産性は向上しません。
むしろ、調整のコストが開発者一人あたり毎週約1日分も失われているというデータさえ存在します。
開発フェーズごとに異なるAIへの要求性能
ソフトウェア開発ライフサイクル(SDLC)の各工程では、AIに求められる要件が根本的に異なります。
すべてのタスクに最高性能のモデルを適用することは、コスト効率の観点からもパフォーマンスの観点からも合理的ではありません。
1. 速度重視のタスク
コードの自動補完や、コーディング中の修正提案など、開発者の思考を妨げないリアルタイム性が求められるタスクです。
これらには、ミリ秒単位で応答可能な軽量かつ高速なローカルモデルが適しています。
2. 品質と論理的思考が重視されるタスク
アーキテクチャの設計、高度なセキュリティ分析、複雑なリファクタリングなどが該当します。
多少のコストや待機時間が発生しても、最先端のフロンティアモデル(Frontier Models)による深い推論能力が必要です。
3. コスト効率が重視される大量タスク
コミットメッセージの生成やログファイルの要約、数百のレポジトリにわたる依存関係の更新などです。
これらは実行頻度が極めて高いため、安価で信頼性の高いオープンソースモデルの活用が推奨されます。
タスク価値に合わせた「マルチモデル戦略」の実行
エンタープライズAIの成功には、タスクの価値とモデルのコストを最適にマッピングすることが不可欠です。
一つのモデルに固執することは、ある業務では過剰なコストを支払い、別の業務では性能不足に陥るというリスクを招きます。
| タスクカテゴリ | 主なタスク内容 | 推奨されるモデルタイプ | 重視される指標 |
|---|---|---|---|
| リアルタイム支援 | コード補完、インライン修正 | 小型モデル(SLM)、オンプレミスモデル | レイテンシ(応答速度) |
| 高度な意思決定 | セキュリティ監査、設計レビュー | フロンティアモデル(GPT-4o, Claude 3.5等) | 推論精度、コンプライアンス |
| 定型業務の自動化 | テスト生成、ドキュメント作成 | オープンソースモデル(Llama 3, Mistral等) | トークン単価、スループット |
柔軟性を確保するための3つのアプローチ
組織がAIモデルを選択する際には、以下の3つの選択肢を戦略的に組み合わせる必要があります。
第一に、AnthropicやOpenAI、Googleが提供する商用のフロンティアモデルです。
これらは常に最新の性能を享受できますが、ベンダーのロードマップや価格改定に依存するという側面があります。
第二に、セルフホスト型の商用またはオープンソースモデルです。
データレジデンシー(データ所在地の制約)やコストを完全にコントロールできる利点がありますが、インフラ管理の負担が伴います。
第三に、特定のドメインに特化して学習させた独自モデルです。
特定の業界や独自のコードベースにおいては、汎用モデルを凌駕する性能を発揮しますが、構築には高度な専門知識が必要です。
AI支出をクラウド支出と同様に管理する「FinOps」の導入
モデルの柔軟性を確保した後は、その経済性を管理する仕組みが必要になります。
高度な推論モデルは、ルーチンワークに適した汎用モデルと比較して、リクエストあたりのコストが500%以上も高くなることがあります。
そのため、企業はAIの利用を「AI FinOps」として管理しなければなりません。
具体的には、タスクの内容に応じて自動的にモデルを振り分ける「モデルルーティング」の実装が効果的です。
# モデルルーティングの概念例
def route_ai_task(task_type):
    if task_type == "code_completion":
        # 高速で安価なローカルモデルを呼び出し
        return call_fast_model()
    elif task_type == "security_audit":
        # 高性能なフロンティアモデルを呼び出し
        return call_frontier_model()
    else:
        # デフォルトの汎用モデル
        return call_standard_model()

# 実行結果のイメージ
# task_type="security_audit" -> logic_score: 0.98, cost: $0.05
# task_type="code_completion" -> latency: 50ms, cost: $0.0001Task routed to Frontier Model: Analysis complete with 98% accuracy.
Task routed to Local Model: Completion suggested in 48ms.また、予算の暴走を防ぐためのクォータ(制限)設定や、部門ごとの使用量に応じた課金モデル(チャージバック)の導入も検討すべきです。
IDCの予測によれば、2027年までに多くの組織がAIインフラのコストを30%以上過小評価するとされています。
可視化、責任、ガバナンスを備えた管理体制こそが、AI導入をスケールさせるための防波堤となります。
コンテキストの共有とカスタマイズのレイヤー
AIモデルの性能を最大限に引き出すもう一つの要素は、「コンテキスト」の質です。
デバッグを行う開発者は、バックログ、Slackでの議論、Grafanaのメトリクスなど、分散した情報を参照する必要があります。
これらの情報がAIと切り離されていれば、AIは正確な回答を出すことができません。
最近では、「Model Context Protocol (MCP)」のような、異なるツール間でコンテキストを共有するための標準規格が登場しています。
効果的なカスタマイズを構築する3つの階層
組織におけるAIのカスタマイズは、以下の3つのレイヤーで進めるのが理想的です。
- プリセットされたエージェントとワークフロー: 一般的なタスクに対して、専門知識がなくてもすぐに利用できる環境。
- 高度なプロンプティング: 組織独自のプレイブックやコーディング規約をAIに学習させ、出力の精度を高める。
- 統治されたマルチエージェント: 複数のAIエージェントが連携し、人間によるレビュープロセスを含む一連の業務フローを完結させる。
AIが組織固有の文脈(コンテキスト)の中で動作し、適切な説明責任を果たせる構造を設計することが、投資対効果(ROI)を最大化します。
標準化ではなく「オーケストレーション」を目指す
エンタープライズAIの成功とは、一つの完璧なモデルを見つけることではありません。
真の成功は、「適切なモデルを、適切なタスクに、適切なガバナンスの下で接続するシステム」を構築することにあります。
先進的な組織は、モデルの多様性を許容しながら、強力なオーケストレーション(統合制御)機能を備えています。
例えば、サブエージェントがモデルの品質、パフォーマンス、コストをタスクごとに評価し、最適なルートを選択します。
このプロセスが透明化されていることで、開発チームはなぜそのモデルが選ばれたのかを理解し、信頼を持ってAIを活用できます。
また、特定の要件がある場合には、デフォルトのモデル設定を上書きしたり、独自のモデルをインポートしたりできる柔軟性も重要です。
まとめ
エンタープライズAIは、単なるツールの導入から、戦略的なプラットフォームの構築へとフェーズが移行しています。
「一つのモデルですべてを賄う」という考え方を捨て、開発ライフサイクル全体を俯瞰したマルチモデル戦略を採用することが重要です。
性能、コスト、データ保護のバランスをとりながら、モデルのルーティングとFinOpsを徹底することで、AIは初めて持続可能な競争優位性をもたらします。
最終的に差をつけるのは、最新のモデルそのものではなく、それを組織の文脈に合わせて自在に操る「オーケストレーション」の能力なのです。