
現代のエンタープライズソフトウェアは、従来の「Software 1.0」から、AIを中核に据えた「Software 2.0」へのパラダイムシフトを余儀なくされています。
これまでのシステムは確定的な「If-Then」ロジックの積み重ねで構築されてきましたが、複雑化するビジネス環境においてその脆弱性が露呈しています。
AIネイティブ・システムへの移行は、単にチャットボットを導入することではなく、組織の基盤そのものを再定義する試みです。
本記事では、不確実性を管理しつつ、安全性と透明性を両立させた次世代のエンタープライズ基盤設計について詳しく解説します。
Software 1.0の限界とAIネイティブの必然性
従来のエンタープライズシステムは、あらかじめ定義されたルールに基づいて動作するため、想定外のデータや状況変化に直面すると容易に停止してしまいます。
企業はこの「ロジックの隙間」を埋めるために、膨大な人的リソースを投入してデータの照合や例外処理を手動で行ってきました。
AIネイティブ・システムは、学習されたロジックに基づく「Software 2.0」のアプローチを採用し、不確実なリクエストに対しても確率的な推論を用いて柔軟に対応します。
Software 2.0への転換において最も重要なのは、AIを単なる「部品」としてではなく、システムの「OS」として位置づける設計思想です。
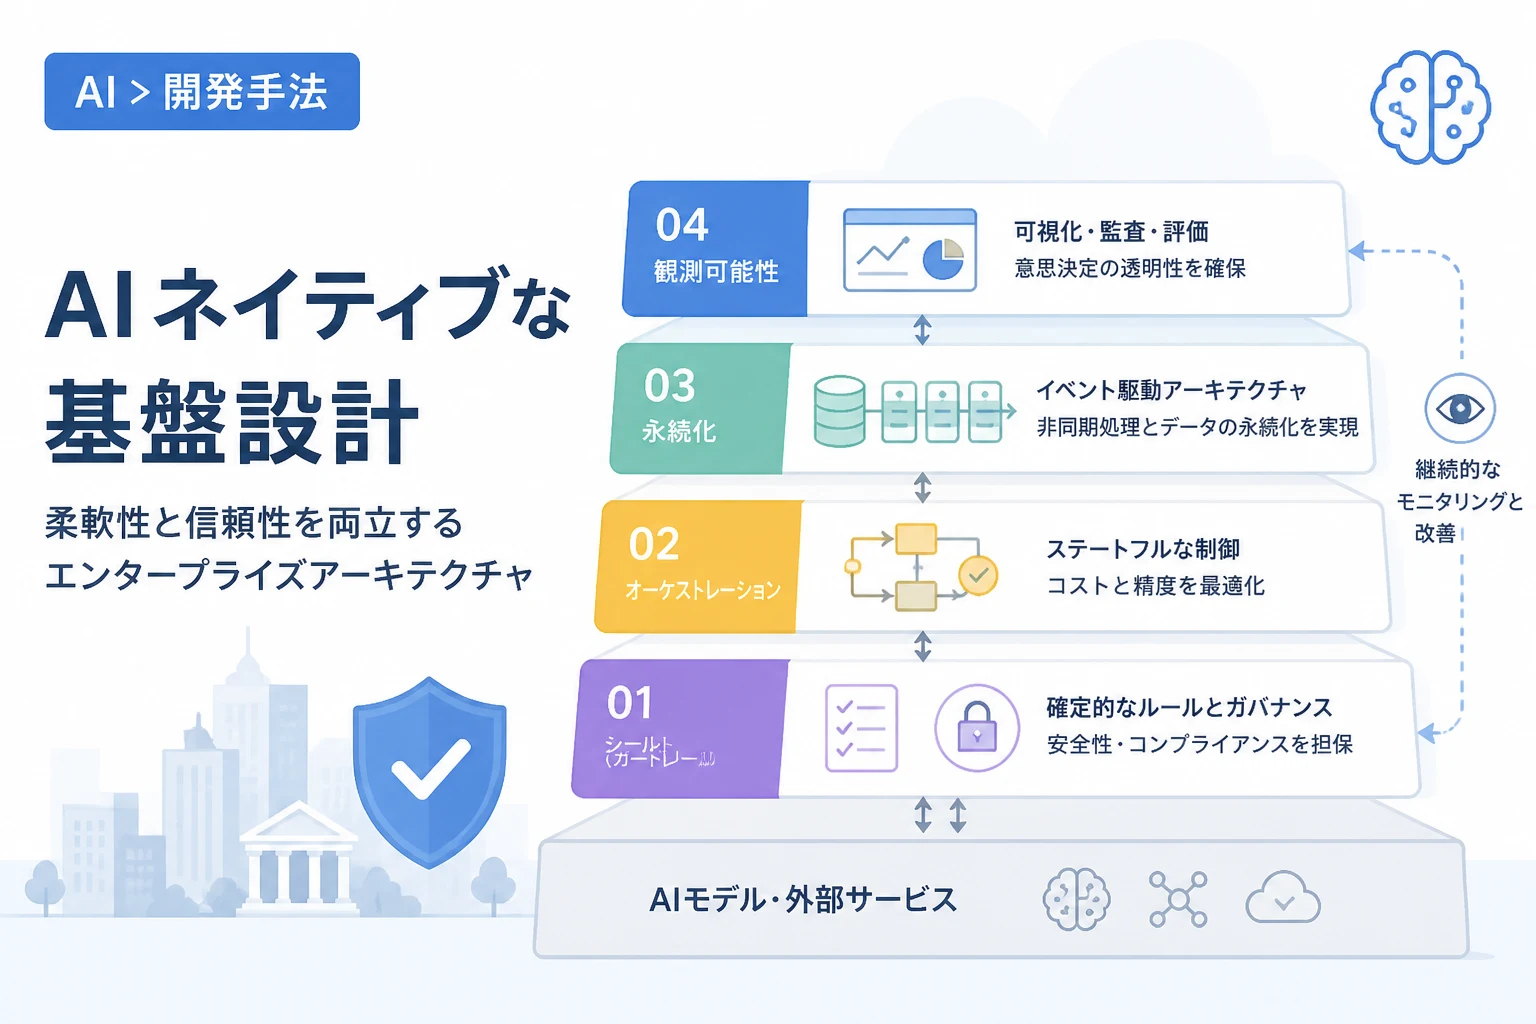
この新しいアーキテクチャを実現するためには、ガバナンス、オーケストレーション、永続性、そして監視という4つの階層を統合的に構築する必要があります。
レイヤー0:確定的なシールドによるガバナンスの確立
AIネイティブ・システムにおいて、LLM(大規模言語モデル)の出力をそのままビジネスロジックに流し込むことは極めて危険です。
そのため、モデルの判断に依存しない「確定的なシールド(AIMS:AI Identity & Management System)」を最外郭に配置する必要があります。
このレイヤーの目的は、LLMがどのような「決定」を下したとしても、企業のポリシーやコンプライアンスを侵害させないことにあります。
具体的には、機密情報(PII)のスクラビングを行うインバウンドゲートウェイと、内部情報の漏洩を防ぐアウトバウンドゲートウェイの二段構えで構成します。
また、既存のLDAP等のアイデンティティ管理システムと連携し、ユーザーの権限に基づいたアクセス制御をLLMのリクエスト前に実行することが不可欠です。
# インバウンド・シールドの実装例
@app.post("/gateway/query")
async def inbound_shield(request: UserRequest, principal: Principal = Depends(verify_jwt)):
    # LDAPからユーザーロールを取得
    user_id = principal.sub
    user_role = await asyncio.to_thread(ldap.get_role, user_id)

    # ユーザー権限に基づきクエリを検証
    if not auth_service.can_access_ai(user_role):
        raise HTTPException(status_code=403, detail="権限がありません")

    # 個人情報(PII)を匿名化
    clean_query = scrubber.redact(request.text)

    # 分散トレーシングのためのID発行
    trace_id = generate_otel_trace()

    # 非同期処理のためにメッセージキュー(Kafka)へ送信
    await kafka.produce("inbound_queries", {"trace_id": trace_id, "query": clean_query})

return {"status": "queued", "trace_id": trace_id}INFO: [trace_id: a1b2c3d4] PII Redaction complete.
INFO: [trace_id: a1b2c3d4] Request queued for Orchestrator.モデルに依存しないガバナンスの重要性
ガバナンスルールは、使用するLLMの種類(Claude、Gemini、GPT等)に関わらず一貫していなければなりません。
モデルを入れ替えた瞬間にセキュリティポリシーが崩壊するようなシステムは、エンタープライズ品質とは呼べません。
AIMSレイヤーを独立させることで、モデルの進化に合わせた柔軟な切り替えと、強固なセキュリティの両立が可能になります。
レイヤー1:ステートフルなオーケストレーション
AIネイティブ・システムの「脳」に相当するのが、オーケストレーションレイヤーです。
単発のチャット応答(Stateless)から、複雑なビジネスプロセスを管理する状態保持型(Stateful)への進化が求められています。
ここで重要な役割を果たすのが、SLM(小規模言語モデル)を活用した「トリアージ(優先順位付け)」の仕組みです。
すべてのリクエストを高性能で高価なモデルに処理させるのではなく、まずはSLMがクエリの複雑さを判断します。
単純なタスクは軽量モデルや確定的なスクリプトで処理し、高度な推論が必要な場合のみ重量級のモデルにルーティングすることで、コストを最大80%削減できます。
RAGとツール利用の高度化
ハルシネーション(もっともらしい嘘)を防ぐためには、最新の社内データを検索してコンテキストとして与えるRAG(検索拡張生成)の導入が標準となります。
さらに、オーケストレーターにはAPIやデータベースを操作するための「ツール(関数呼び出し)」が与えられます。
ただし、AIが誤ったAPIコールを行わないよう、厳格なスキーマ検証と、エラー発生時の自己修復ロジックを組み込む必要があります。
高リスクな判断を伴うプロセスでは、必ず人間の承認を介在させる「Human-in-the-Loop(HITL)」の設計を組み込むことが推奨されます。
# SLMによるコスト最適化とトリアージ
def route_request(state: GraphState):
    # 軽量モデルでクエリの複雑度をスコアリング
    complexity_score = slm_judge.evaluate(state["prompt"])

    if complexity_score < 3:
        # 低コストモデルへ
        return "gpt-4o-mini"
    elif complexity_score < 7:
        # 標準モデルへ
        return "claude-3-5-sonnet"
    else:
        # 最高性能モデルと人間によるダブルチェックへ
        return "human_approval_required"
レイヤー2:イベント駆動型の永続化スパイン
AIによる思考プロセスは時間がかかることが多く、システムには「非同期性」と「耐久性」が求められます。
コンテナが再起動してもAIの思考が途切れないよう、メッセージキュー(Kafka等)を神経系として活用し、すべての状態を永続化する必要があります。
ここで有効な戦略が、AIの「脳の状態」を一時保存する「ハイドレーション / デハイドレーション(水分補給 / 脱水)」メカニズムです。
人間の承認を待つ間など、アイドル状態にあるプロセスのメモリを解放し、安価なストレージへ退避させることで、クラウドコストを劇的に最適化できます。
| ストレージ種別 | 役割 | 採用理由 |
|---|---|---|
| RDBMS / NoSQL | メタデータ・インデックス管理 | 承認待ちタスクの一覧表示など、高速な検索とクエリが必要なため。 |
| オブジェクトストレージ (S3) | 巨大なステート・バイナリ | チャット履歴や参照ドキュメントを含む巨大なJSONを安価に長期保存するため。 |
# デハイドレーション(状態の退避)の実装
def dehydrate_state(thread_id, current_state):
    # セキュリティチェック済みのIDを使用
    validate_id(thread_id)

    # S3に詳細な実行状態を保存
    s3.put_object(
        Bucket="ai-state-bucket",
        Key=f"checkpoints/{thread_id}/state.json",
        Body=json.dumps(current_state)
    )

    # RDBMSにインデックス情報を更新
    db.execute("UPDATE tasks SET status='WAITING' WHERE thread_id=%s", (thread_id,))

    return "Dehydrated"
レイヤー3:ブラックボックスを排除する観測可能性
AIネイティブ・システムにおける最大の懸念は、意思決定プロセスがブラックボックス化することです。
エンタープライズ環境では、特定の回答がなぜ生成されたのかを事後的に検証できる、強力な監査トレイルが必須となります。
「LLM-as-a-Judge(審判としてのLLM)」という手法を用い、別のLLMにメインモデルの回答品質やハルシネーションの有無をリアルタイムで評価させることが有効です。
Arize PhoenixやLangSmithといったツールを活用し、推論の各ステップにおけるトークンコスト、レスポンス時間、評価スコアを可視化します。
これにより、SOC2やGDPRといった厳格なコンプライアンス基準を遵守しながら、AIの運用をスケールさせることが可能になります。
# 監査ログの構築
class AgentState(TypedDict):
    messages: List[dict]
    audit_log: List[AuditEntry] # すべての「思考」を記録
    internal_monologue: List[str] # AIの内部的な独白
まとめ
AIネイティブ・システムの構築は、単なる技術的なアップグレードではなく、企業の不確実性に対する耐性を高める戦略的な投資です。
確定的なガードレールによる安全性、ステートフルなオーケストレーションによる柔軟性、そして永続的なスパインによる効率性の3本柱が、これからのエンタープライズ基盤を支えます。
このアーキテクチャを導入することで、人間はルーチンワークから解放され、AIシステムの「ガバナー(統治者)」としての役割に専念できるようになります。
Software 2.0の時代において、真に競争力を持つのは、AIのポテンシャルを最大限に引き出しつつ、そのリスクを構造的に制御できる企業です。
今回解説した4つのレイヤーを指針として、堅牢かつ進化し続けるAIネイティブ・システムの構築をぜひ検討してください。