
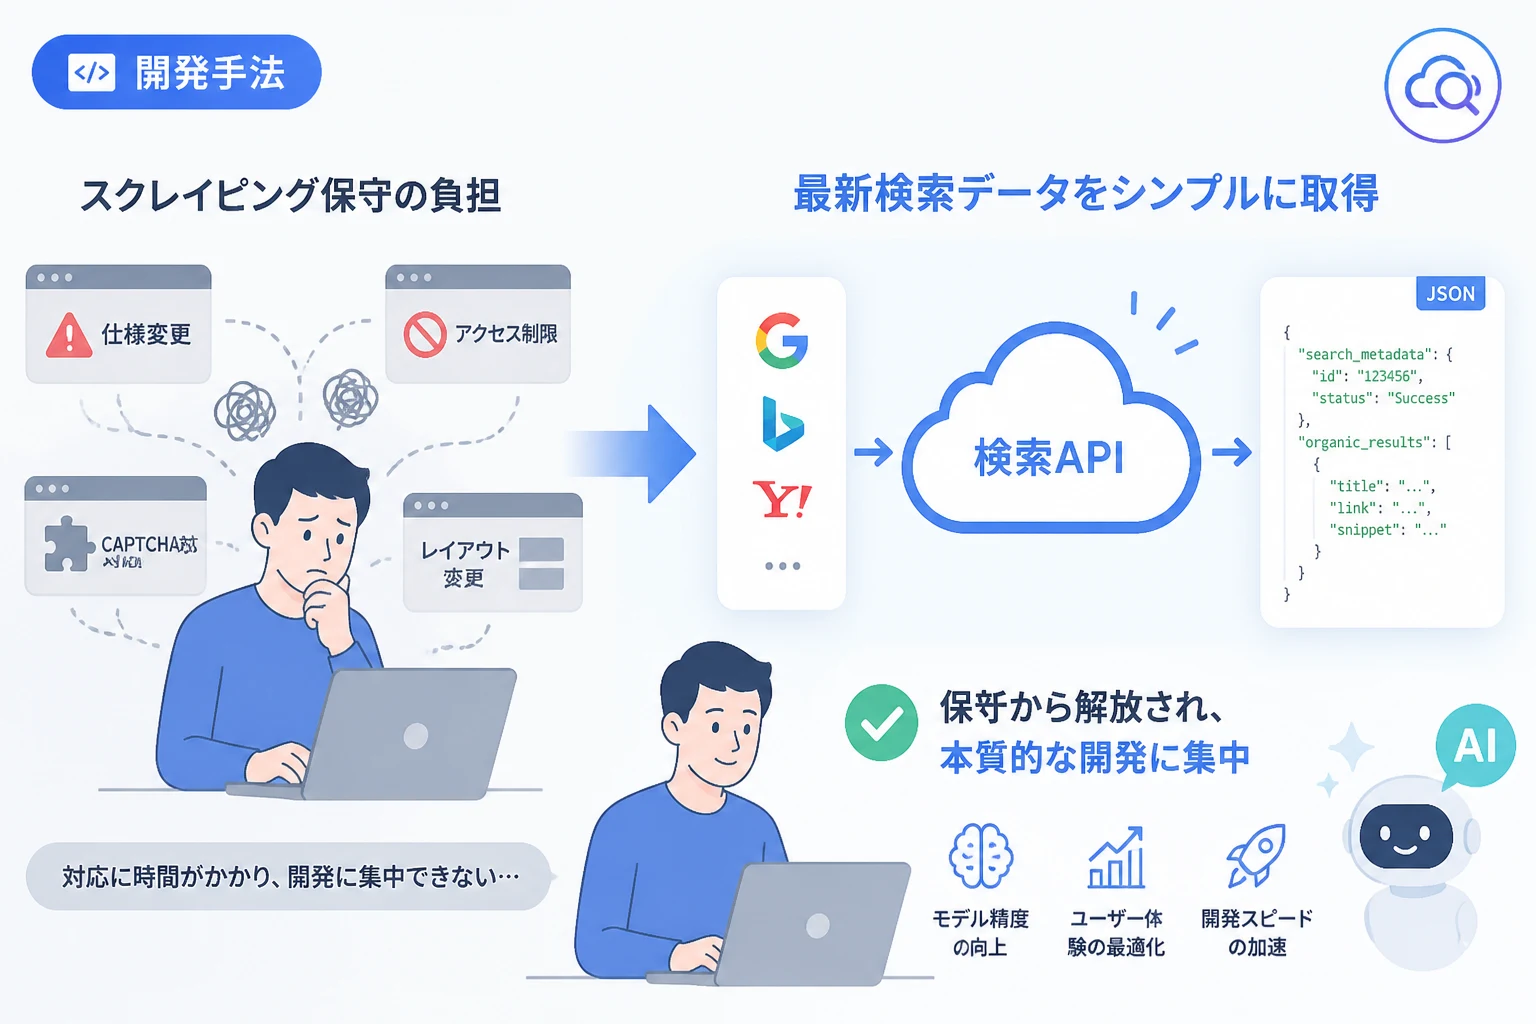
現代のAI開発において、もっとも価値のある資産は「新鮮で正確なデータ」です。
多くのAIエンジニアやデータサイエンティストが、最新の情報を大規模言語モデル (LLM) に取り込むための手法として、検索エンジンのスクレイピングを選択してきました。
しかし、自前でスクレイピング・パイプラインを構築・維持することは、想像以上に困難でリソースを消費する作業です。
本記事では、AIチームが数ヶ月を費やすスクレイピングの保守作業を、わずか1回のAPIコールに集約する「SerpApi」の有用性について深掘りします。
AI開発を阻害する「スクレイピング税」の正体
プロトタイプの段階では、単純なスクリプトで検索結果を取得することはそれほど難しくありません。
しかし、プロダクション環境で大量のデータを継続的に取得しようとすると、「スクレイピング税」とも呼ぶべき膨大な運用コストが発生します。
絶え間ない仕様変更との戦い
検索エンジンは、ユーザーエクスペリエンス向上のために頻繁にページレイアウトを変更します。
自前のスクレイパーを使用している場合、HTMLの構造がわずかに変わるだけでパーサーが壊れ、データ供給が停止してしまいます。
エンジニアは本来のAIモデル改善ではなく、壊れたコードの修正に追われることになります。
高度化するアクセス制限の回避
主要な検索エンジンは、Botによるアクセスに対して厳格な制限を設けています。
IPブロックの回避、プロキシサーバーのローテーション、そして進化し続けるCAPTCHAへの対応は、専門的なノウハウを必要とします。
これらのインフラ管理にリソースを割くことは、製品の市場投入までの時間を大幅に遅らせる原因となります。
SerpApiが提供する「エンジニアリングの解放」
SerpApiは、GoogleやBing、Amazonといった主要な検索エンジンの結果を構造化されたJSON形式で返すAPIサービスです。
開発者は複雑なバックエンドの処理を一切気にすることなく、URLを叩くだけでクリーンなデータを受け取ることができます。
バックエンドで処理される複雑なタスク
SerpApiを利用することで、以下の煩雑な作業をすべて外部委託することが可能です。
- プロキシ管理: 数千ものIPアドレスを適切にローテーションし、ブロックを防ぎます。
- CAPTCHA解決: 高度な認識技術により、人間が介在することなくアクセスを継続します。
- ブラウザレンダリング: JavaScriptの実行が必要な複雑なページも完全にレンダリングした状態で解析します。
- レイアウト変更への即時対応: SerpApiの専任チームが24時間体制で変更を監視し、パーサーを更新します。
主要な対応検索エンジンと活用シーン
SerpApiは100以上の検索エンジンに対応しており、それぞれの用途に特化したエンドポイントを提供しています。
| API名称 | 主な取得データ | 最適なユースケース |
|---|---|---|
| Google Search API | オーガニック検索結果、広告、関連ワード | RAG (検索拡張生成) パイプライン、市場調査 |
| Google AI Overview API | AIによる要約回答の内容 | 最新のAIトレンド解析、競合比較 |
| Google Shopping API | 製品価格、在庫状況、販売店情報 | 動的プライシングツール、EC分析 |
| Google Maps API | 店舗情報、口コミ、評価、座標 | ローカルビジネス分析、推薦システム |
なぜAIエージェントに「生の検索データ」が必要なのか
LLMは学習データに基づいた回答を行いますが、トレーニングカットオフ以降の出来事については正確に答えることができません。
この問題を解決するために、「RAG (Retrieval-Augmented Generation)」という手法が一般的になっています。
ハルシネーションの劇的な抑制
AIが不確かな知識で回答を生成する「ハルシネーション」は、最新の検索結果をコンテキストとして与えることで大幅に減少します。
特に時間の経過とともに変化する株価、ニュース、製品仕様などの情報を扱う場合、リアルタイム検索は必須の機能です。
モデルの制御性と透明性の向上
一部のLLMには標準でブラウジング機能が搭載されていますが、開発者が「どのソースから」「いつ」データを取得するかを制御することは困難です。
SerpApiを介して明示的に検索を行うことで、モデルに渡す情報の鮮度と信頼性をエンジニア側で完全にコントロールできるようになります。
「何に基づいて回答したか」という根拠(エビデンス)を明確にできることは、ビジネス用途のAIにおいて不可欠な要素です。
SerpApiの実装例:Pythonによる検索実行
実際にSerpApiを使用して、Googleから情報を取得する際の実装がいかにシンプルかを見てみましょう。
以下のコードは、Pythonを使用して特定のキーワードに関する検索結果をJSON形式で取得する例です。
from serpapi import GoogleSearch
import json

# APIキーの設定(実際には環境変数などで管理します)
params = {
    "engine": "google",
    "q": "最新のAI開発トレンド 2026",
    "location": "Tokyo, Japan",
    "hl": "ja",
    "gl": "jp",
    "api_key": "YOUR_SERPAPI_KEY"
}

# 検索の実行
search = GoogleSearch(params)
results = search.get_dict()

# オーガニック検索結果の先頭を表示
if "organic_results" in results:
    first_result = results["organic_results"][0]
print(json.dumps(first_result, indent=2, ensure_ascii=False)){
"position": 1,
"title": "2026年のAIトレンド:自律型エージェントの台頭",
"link": "https://example.com/ai-trends-2026",
"snippet": "2026年、AIは単なるチャットツールから、自ら意思決定しタスクを実行する自律型エージェントへと進化しました...",
"displayed_link": "https://example.com › ai-trends-2026"
}このように、複雑なHTML解析を行うことなく、titleやlink、snippetといった必要な情報だけを即座に利用できます。
開発チームが本来集中すべきこと
多くのAIスタートアップや企業内プロジェクトにおいて、リソースは常に限られています。
スクレイパーのメンテナンスにエンジニアの工数を割くことは、機会損失と同義です。
SerpApiのようなマネージドなAPIを採用することで、チームは「モデルの精度向上」や「ユーザー体験の最適化」といった、本来の目的である製品開発に全力を注ぐことができるようになります。
非構造化データであるウェブの世界を、構造化された信頼できるデータソースへと変えることが、AI開発を加速させる鍵となります。
まとめ
AIの進化に伴い、リアルタイムな情報取得の重要性はますます高まっています。
自前のスクレイピング運用に伴う「IPブロック」「CAPTCHA」「レイアウト変更」といった課題は、開発チームの生産性を著しく低下させます。
SerpApiを活用することで、これらのボトルネックを一掃し、1回のAPIコールで高品質な構造化データを手に入れることが可能です。
スクレイピングの保守に追われる日々を終わらせ、次世代のAIアプリケーション構築にリソースを集中させましょう。