
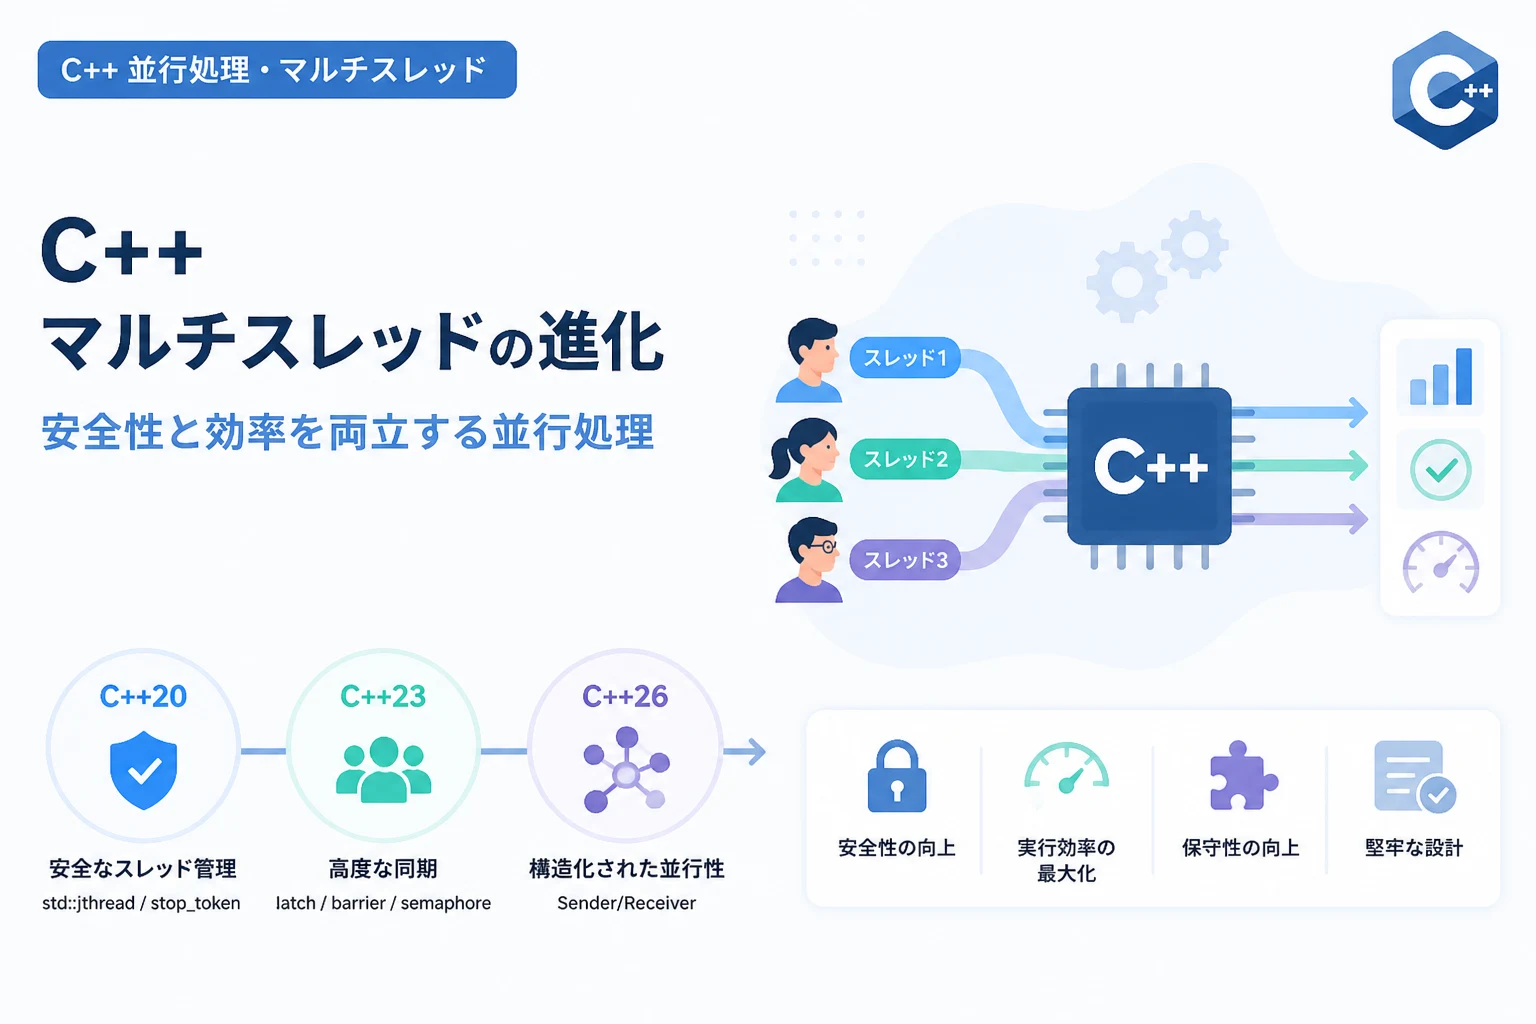
C++におけるマルチスレッドプログラミングは、近年の言語仕様の進化によって劇的な変革を遂げました。
かつての複雑でエラーの起きやすい低レイヤーな操作から、より安全で抽象度の高い設計へとシフトしています。
本記事では、C++20からC++26にかけて導入された最新の機能を軸に、並行処理の実装方法を詳しく解説します。
C++20/23/26における並行処理の進化
現代のソフトウェア開発において、マルチコアプロセッサの性能を最大限に引き出すことは不可欠な課題です。
C++11で標準スレッドライブラリが登場して以来、C++は着実に並行処理の機能を強化してきました。
特にC++20以降では、プログラマが明示的に管理しなければならなかったリソースや同期の仕組みが、標準ライブラリによって自動化されるようになっています。
C++23やC++26では、さらに「構造化された並行性(Structured Concurrency)」の考え方が取り入れられています。
これにより、非同期タスクの生存期間管理やエラーハンドリングが、従来のコールバックベースの手法よりも遥かに簡潔に記述できるようになりました。
最新の規格を理解することは、実行効率を高めるだけでなく、バグの混入を防ぐためにも極めて重要です。
安全なスレッド管理を実現するstd::jthread
C++20で導入されたstd::jthreadは、従来のstd::threadが抱えていた「合流(join)の忘れ」による異常終了の問題を解決しました。
std::jthreadはRAII(Resource Acquisition Is Initialization)の原則に基づき、デストラクタで自動的にjoin()を呼び出します。
これにより、スコープを抜ける際にスレッドの終了を待機することが保証され、プログラムの安全性が飛躍的に向上しました。
また、std::jthreadには協力的な停止要求を可能にする停止トークン(std::stop_token)が組み込まれています。
std::jthreadと停止トークンの実装例
以下のコードは、std::jthreadを使用して安全にスレッドを開始し、外部から停止要求を送る基本的な実装です。
#include <iostream>
#include <thread>
#include <chrono>

void worker_function(std::stop_token stoken) {
    // 停止要求が来るまでループを継続する
    while (!stoken.stop_requested()) {
        std::cout << "ワーカースレッドが動作中です..." << std::endl;
        std::this_thread::sleep_for(std::chrono::milliseconds(500));
    }
    std::cout << "停止要求を受け取り、終了します。" << std::endl;
}

int main() {
    // スレッドの開始。std::jthreadは自動的にstop_tokenを渡す。
    std::jthread worker(worker_function);

    // メインスレッドで3秒間待機
    std::this_thread::sleep_for(std::chrono::seconds(3));

    // stop_request()を呼び出さなくても、workerのデストラクタで停止要求とjoinが行われる
    std::cout << "メインスレッドを終了します。" << std::endl;
    return 0;
}ワーカースレッドが動作中です...
ワーカースレッドが動作中です...
ワーカースレッドが動作中です...
...(中略)
メインスレッドを終了します。
停止要求を受け取り、終了します。この例のように、明示的にjoin()を記述しなくてもプログラムが安全に終了するのがstd::jthreadの利点です。
停止トークンを利用することで、無限ループに陥るリスクを減らし、クリーンアップ処理を確実に行うことができます。
高度な同期プリミティブ:Latch, Barrier, Semaphore
C++20では、スレッド間の同期をより効率的に行うための新しいクラスが追加されました。
これまではstd::condition_variableとstd::mutexを組み合わせて自作していた処理が、標準機能として提供されています。
std::latchによる一回限りの同期
std::latchは、指定したカウントがゼロになるまでスレッドを待機させるダウンカウントラッチです。
複数のスレッドが特定の準備を完了するまでメイン処理を待たせたい場合に、非常に軽量な同期手段として機能します。
std::barrierによる再利用可能な同期点
std::barrierは、複数のスレッドがフェーズごとに同期を合わせるための仕組みです。
すべてのスレッドが特定のポイントに到達するまで待機し、全員が揃ったら次のフェーズへ進むという処理を繰り返すことができます。
これは、並列計算アルゴリズムにおいて反復処理を行う際に非常に有効です。
std::semaphoreによるリソース管理
std::semaphore(特にstd::counting_semaphore)は、同時にアクセスできるスレッド数を制限するために使用されます。
コネクションプールや計算リソースの制限など、一定数の許可証を管理するような場面で活用されます。
#include <iostream>
#include <vector>
#include <thread>
#include <latch>

void task(int id, std::latch& work_done) {
    std::cout << "タスク " << id << " を実行中..." << std::endl;
    std::this_thread::sleep_for(std::chrono::milliseconds(100 * id));

    // 完了を通知
    work_done.count_down();
}

int main() {
    const int num_tasks = 5;
    std::latch work_done(num_tasks);
    std::vector<std::jthread> workers;

    for (int i = 0; i < num_tasks; ++i) {
        workers.emplace_back(task, i, std::ref(work_done));
    }

    // すべてのタスクが完了するまでブロック
    work_done.wait();
    std::cout << "すべてのタスクが完了しました。" << std::endl;

    return 0;
}
C++23/26で期待されるstd::executionとSender/Receiverモデル
C++23およびC++26の最大の注目点は、P2300として提案されている「Schedulers, Senders, and Receivers」のフレームワークです。
これは、非同期処理を合成可能なコンポーネントとして扱うための強力な基盤です。
従来のstd::futureやstd::asyncには、非同期タスクの連鎖やスケジューリングの制御が難しいという欠点がありました。
新しいモデルでは、「Sender(値を送るもの)」「Receiver(値を受け取るもの)」「Scheduler(どこで実行するかを決めるもの)」に役割を分離します。
これにより、GPUでの並列実行やカスタムスレッドプールへのタスク投入を、共通のインターフェースで記述できるようになります。
構造化された非同期処理のメリット
Sender/Receiverモデルを用いると、パイプライン演算子のように非同期タスクを連結できます。
たとえば、「データを読み込み、変換し、保存する」という一連の処理を、それぞれ別々のスレッドやデバイスで実行するように構成可能です。
また、エラーハンドリングやキャンセル処理も統一された方法で記述できるため、堅牢な非同期システムを構築するための土台となります。
C++26では、この基盤をベースにした標準アルゴリズムの並列版がさらに充実する見込みです。
メモリモデルとアトミック操作の深化
マルチスレッドプログラミングにおいて、パフォーマンスのボトルネックとなるのがスレッド間の同期コストです。
C++のメモリモデルを正しく理解し、std::atomicを使いこなすことは、ロックフリー(Lock-free)なアルゴリズムの実装に欠かせません。
メモリオーダーの適切な選択
デフォルトのstd::memory_order_seq_cst(逐次一貫性)は最も安全ですが、実行時のコストも最大です。
特定の条件下では、std::memory_order_acquireやstd::memory_order_releaseを使用することで、不要なメモリフェンスを避け、パフォーマンスを向上させることができます。
ただし、これらは「Happens-before」の関係を正しく設計する必要があり、慎重な検討が求められます。
C++20のアトミック待機・通知機能
C++20からは、std::atomic<T>::wait()やstd::atomic<T>::notify_one() / notify_all()が導入されました。
これにより、変数の値が特定の状態になるまでスレッドを効率的にスリープさせ、値が変わったときに起こすことが可能になりました。
OSレベルのブロッキングを活用するため、ビジーループ(スピンロック)に比べてCPU負荷を大幅に軽減できます。
#include <iostream>
#include <atomic>
#include <thread>

std::atomic<int> data_ready{0};

void producer() {
    // データの準備に時間がかかる想定
    std::this_thread::sleep_for(std::chrono::seconds(1));
    data_ready.store(1);

    // 待機中のスレッドに通知
    data_ready.notify_one();
}

void consumer() {
    // 値が1になるまで待機
    data_ready.wait(0);
    std::cout << "コンシューマー:データを受信しました。" << std::endl;
}

int main() {
    std::jthread t1(producer);
    std::jthread t2(consumer);
    return 0;
}
実行効率を最大化するためのベストプラクティス
並行処理を高速化するためには、単にスレッドを増やすだけでは不十分です。
ハードウェアの特性を考慮した設計が、実行効率を左右する鍵となります。
偽共有(False Sharing)の回避
異なるスレッドが同じキャッシュライン上にある別々の変数に頻繁にアクセスすると、パフォーマンスが著しく低下します。
これを回避するために、C++17で導入されたstd::hardware_destructive_interference_sizeを使用して、変数の間に適切なパディングを挿入することが推奨されます。
ロックの粒度とコンテンションの抑制
ミューテックスによるロック範囲は、必要最小限にするべきです。
長時間ロックを保持すると、他のスレッドが待機状態になり、並列化のメリットが失われます。
可能であれば、読み取り専用のデータにはstd::shared_mutexを使用し、並行読み取りを許可するなどの工夫が必要です。
スレッドプールの活用
スレッドの生成と破棄はコストの高い操作です。
タスクが発生するたびにスレッドを作成するのではなく、あらかじめ作成されたスレッドプールにタスクを投げ入れる設計が一般的です。
C++26のstd::execution環境では、スレッドプールは標準的なコンポーネントとして提供される予定であり、より手軽に利用可能になります。
実戦的な実装例:高効率なタスクキュー
最後に、これまでの知識を統合した、並列タスクキューの概念的な実装を見てみましょう。
ここでは、複数のワーカースレッドが安全にタスクを取り出す仕組みを構築します。
#include <iostream>
#include <vector>
#include <queue>
#include <mutex>
#include <condition_variable>
#include <functional>
#include <thread>

class SimpleThreadPool {
public:
    SimpleThreadPool(size_t threads) {
        for (size_t i = 0; i < threads; ++i) {
            workers.emplace_back([this, i] {
                while (true) {
                    std::function<void()> task;
                    {
                        std::unique_lock<std::mutex> lock(this->queue_mutex);
                        this->condition.wait(lock, [this] {
                            return this->stop || !this->tasks.empty();
                        });

                        if (this->stop && this->tasks.empty()) return;

                        task = std::move(this->tasks.front());
                        this->tasks.pop();
                    }
                    std::cout << "スレッド " << i << " がタスクを実行" << std::endl;
                    task();
                }
            });
        }
    }

    template<class F>
    void enqueue(F&& f) {
        {
            std::unique_lock<std::mutex> lock(queue_mutex);
            tasks.emplace(std::forward<F>(f));
        }
        condition.notify_one();
    }

    ~SimpleThreadPool() {
        {
            std::unique_lock<std::mutex> lock(queue_mutex);
            stop = true;
        }
        condition.notify_all();
        // jthreadではないため、手動でjoinが必要
        for (std::thread& worker : workers) worker.join();
    }

private:
    std::vector<std::thread> workers;
    std::queue<std::function<void()>> tasks;
    std::mutex queue_mutex;
    std::condition_variable condition;
    bool stop = false;
};

int main() {
    SimpleThreadPool pool(4);

    for (int i = 0; i < 8; ++i) {
        pool.enqueue([i] {
            std::this_thread::sleep_for(std::chrono::milliseconds(200));
        });
    }

    return 0;
}このコードは古典的なスレッドプールの実装ですが、C++20以降であればstd::jthreadやstd::semaphoreを用いてさらに簡潔に記述できます。
また、C++26が普及すれば、これらの実装は標準ライブラリのstd::executionベースのスケジューラに置き換わっていくでしょう。
まとめ
C++20/23/26におけるマルチスレッドプログラミングは、安全性と抽象化が大きく向上しました。
std::jthreadによるリソース管理の自動化や、停止トークンによる協力的な中断処理は、現代的なC++開発の標準となっています。
さらに、std::latchやstd::barrierといった同期プリミティブの活用により、複雑なスレッド間の連携も効率的に実装可能です。
今後は、C++26で本格導入されるSender/Receiverモデルを理解し、構造化された並行処理を取り入れることが、プロフェッショナルなエンジニアにとって必須のスキルとなるでしょう。
メモリモデルへの深い理解と、新しい標準ライブラリの積極的な活用を通じて、安全で高性能なソフトウェアの開発を目指しましょう。
最新の言語仕様を追い続けることは、単なる知識のアップデートにとどまらず、設計思想そのものを進化させる貴重な機会となります。