
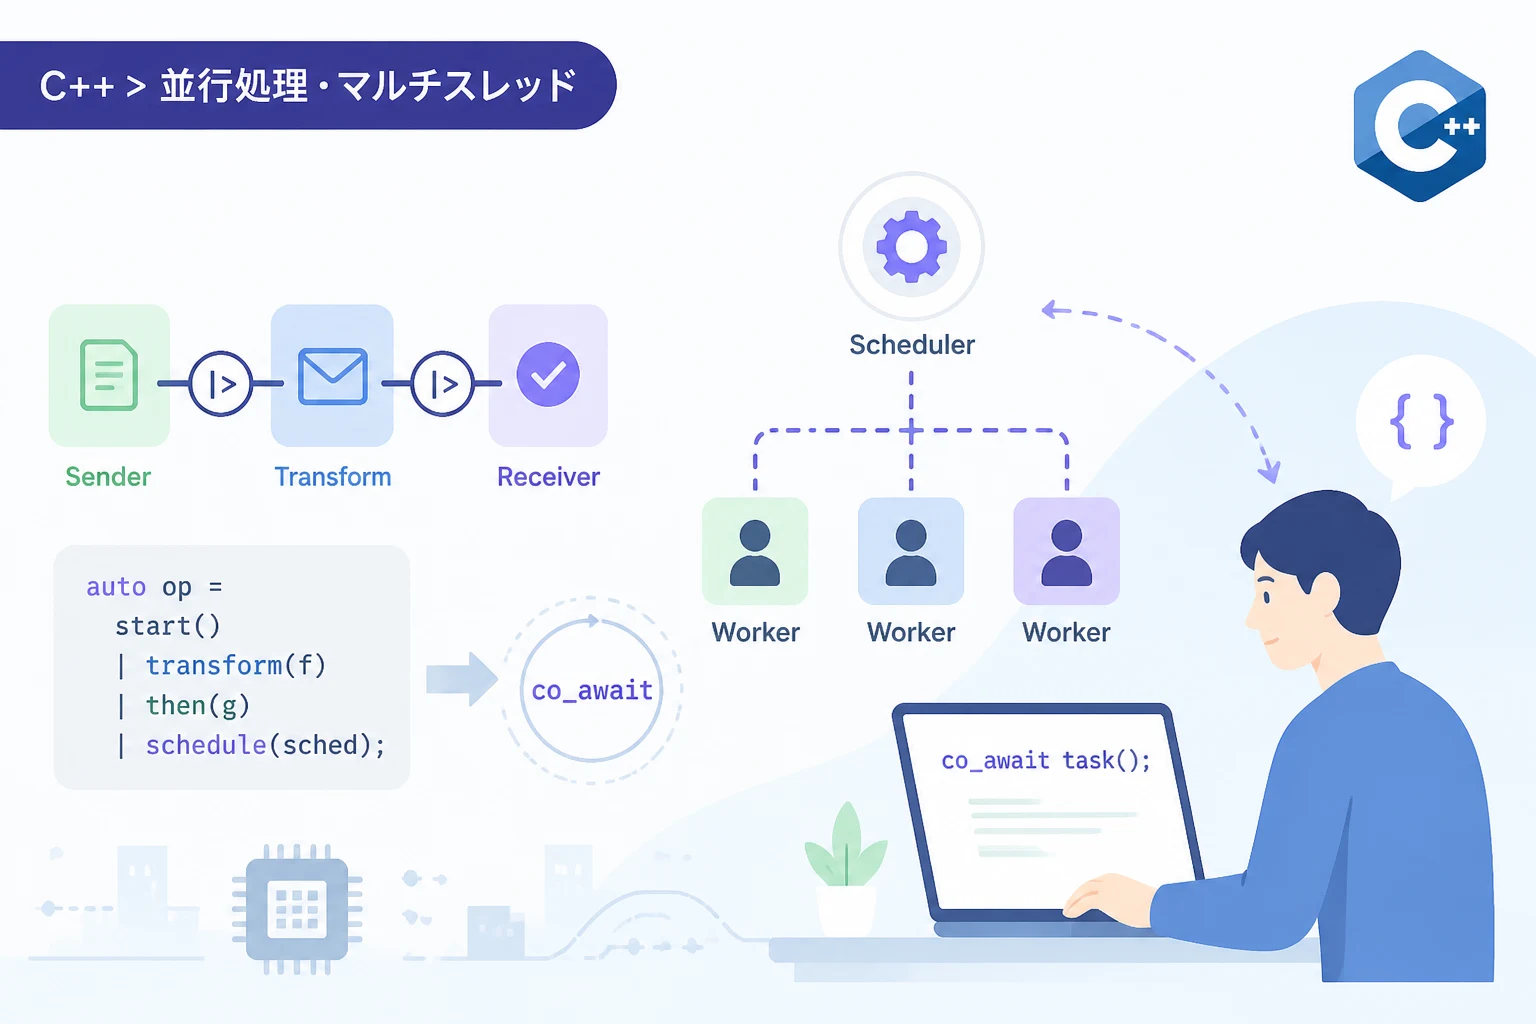
C++の開発環境において、非同期処理の重要性はかつてないほど高まっています。
マルチコアCPUの性能を最大限に引き出すためには、効率的かつ安全な並行プログラミングが不可欠です。
C++26において、長らく議論されてきた「Sender/Receiver」モデルが標準ライブラリに加わり、非同期処理の実装手法が一変しました。
本記事では、最新のstd::executionとコルーチンを組み合わせた、次世代の非同期プログラミング手法について詳しく解説します。
従来の非同期処理が抱えていた課題
C++11で導入されたstd::threadやstd::futureは、基本的な非同期実行を可能にしましたが、多くの制約がありました。
std::futureは一度しか値を転送できず、複数の非同期タスクを効率よく連結する仕組みが不足していました。
また、std::asyncは実行ポリシーの制御が曖昧であり、スレッドの再利用やスケジューリングの最適化が困難でした。
これらの課題を解決するために提案されたのが、P2300として知られるSender/Receiverモデルです。
この新しいフレームワークは、非同期ワークフローの定義と実行を明確に分離することを目指しています。
std::executionの核となる概念
std::executionを理解するためには、Sender、Receiver、そしてSchedulerという3つの概念を把握する必要があります。
Sender:非同期作業の記述
Senderは、将来的に完了する可能性のある計算(非同期ワーク)を表すオブジェクトです。
Sender自体は「何を行うか」を定義するだけであり、この段階ではまだ計算は開始されません。
この遅延実行(Lazy Evaluation)の特性により、複雑な処理の連鎖を効率的に構築することが可能になります。
Receiver:結果の受け取り手
Receiverは、Senderによる計算の結果を受け取るためのインターフェースです。
成功時の値を受け取るset_value、エラーを受け取るset_error、キャンセルを受け取るset_stoppedの3つのチャネルを持ちます。
これにより、非同期処理における例外処理や中断処理が、型安全かつ統一的な方法で扱えるようになりました。
Scheduler:実行リソースの抽象化
Schedulerは、作業が「どこで」実行されるかを決定する抽象レイヤーです。
スレッドプール、イベントループ、あるいはGPUなどの実行リソースを共通のインターフェースで操作できます。
実行場所をハードコードせず、Schedulerを切り替えるだけで実行環境を最適化できるのが最大の利点です。
Sender/Receiverによる基本的な実装例
それでは、std::executionを使用した具体的なコード例を見ていきましょう。
以下の例では、特定のスケジューラ上で数値を計算し、その結果を加工して出力するパイプラインを構築しています。
#include <execution>
#include <iostream>
#include <thread>

int main() {
    // スレッドプールなどのスケジューラを取得(概念的な例)
    auto scheduler = std::execution::get_thread_pool_scheduler();

    // 非同期パイプラインの定義
    auto work = std::execution::schedule(scheduler)
        | std::execution::then([] {
            std::cout << "Task 1 running on thread: " << std::this_thread::get_id() << std::endl;
            return 42;
        })
        | std::execution::then([](int val) {
            std::cout << "Task 2 processing value: " << val << std::endl;
            return val * 2;
        });

    // 実行と結果の待機
    auto [result] = std::this_thread::sync_wait(std::move(work)).value();

    std::cout << "Final Result: " << result << std::endl;

    return 0;
}Task 1 running on thread: 140235671234560
Task 2 processing value: 42
Final Result: 84このコードでは、|(パイプ)演算子を使用してタスクを連結しています。
std::execution::thenは、前のタスクが成功した後に実行される継続処理を定義します。
最後にsync_waitを呼び出すことで、非同期処理の完了を同期的に待機し、結果を取り出しています。
コルーチンとstd::executionの融合
C++20で導入されたコルーチンは、非同期処理を同期処理のように記述できる強力な機能です。
C++26では、std::executionのSenderを直接co_awaitできるようになり、両者の親和性が劇的に向上しました。
Senderをawaitするメリット
従来のコルーチン実装では、独自のプロミステンプレートを用意する必要がありました。
しかし、Sender/Receiverモデルとの統合により、既存のSenderアルゴリズムをコルーチン内でそのまま利用可能になります。
これにより、コードの可読性を維持しつつ、高度な非同期制御を記述できます。
#include <execution>
#include <iostream>

// Senderを返す非同期タスク
std::execution::sender auto async_fetch_data(int id) {
    return std::execution::just(id * 10); // 実際にはネットワーク通信などを想定
}

// コルーチンによる非同期処理の記述
std::execution::sender auto process_data_task() {
    // Senderを直接co_awaitする
    int value1 = co_await async_fetch_data(1);
    int value2 = co_await async_fetch_data(2);

    co_return value1 + value2;
}

int main() {
    auto work = process_data_task();
    auto [total] = std::this_thread::sync_wait(std::move(work)).value();

    std::cout << "Total Value: " << total << std::endl;
    return 0;
}Total Value: 30この例では、process_data_taskというコルーチンの中で、複数のSenderを待機しています。
co_awaitを使用することで、コールバック地獄を回避し、直感的なロジックを構築できています。
高度な非同期アルゴリズムの活用
std::executionには、複雑な並行処理を簡潔に記述するためのアルゴリズムが多数用意されています。
これらを利用することで、自前でスレッド管理や同期機構を実装する必要がなくなります。
並列実行:when_all
複数のSenderを並行して実行し、すべての完了を待つにはwhen_allを使用します。
各タスクは独立して実行され、リソースを効率的に活用できます。
エラー復旧:let_error
非同期チェーンの途中でエラーが発生した場合、let_errorを使用してリカバリ処理を記述できます。
これは、例外処理のcatchブロックに相当する機能を非同期ストリームに提供します。
実行コンテキストの切り替え:transfer
特定の処理をI/O専用スレッドで実行し、その後の加工を計算用スレッドプールで行うといった切り替えが容易になります。
std::execution::transferを使用することで、後続のタスクを実行するSchedulerを動的に変更できます。
非同期処理手法の比較表
これまでのC++における非同期処理の手法を、機能面で比較しました。
| 機能・特性 | std::thread | std::async/future | std::execution |
|---|---|---|---|
| 抽象化レベル | 低 (OSスレッド直結) | 中 | 高 (Sender/Receiver) |
| タスクの合成 | 困難 | 限定的 | 容易 (パイプライン) |
| スケジューリング制御 | 手動 | ライブラリ依存 | 厳密かつ柔軟 |
| オーバーヘッド | 大きい | 中程度 | 最小限 (ゼロコスト抽象化) |
実践的な設計パターン:構造化並行性(Structured Concurrency)
std::executionの導入により、C++でも「構造化並行性」の概念を自然に導入できるようになりました。
構造化並行性とは、非同期タスクの寿命をスコープに基づいて管理する考え方です。
タスクが親スコープを抜ける前に必ず完了またはキャンセルされることを保証することで、リソースリークやダングリングポインタを防ぎます。
Senderの階層構造は、このスコープ管理と非常に相性が良く、堅牢なアプリケーション設計に寄与します。
ストップトークンによるキャンセル
C++20で導入されたstd::stop_tokenは、std::executionにおいても中心的な役割を果たします。
Receiverがキャンセル要求を検知すると、後続のSenderに即座に通知が伝播されます。
これにより、不要になった計算を早期に終了させ、CPUリソースの浪費を抑えることができます。
パフォーマンス最適化のポイント
新しい非同期フレームワークを使用する際は、パフォーマンスを最大限に引き出すための注意点があります。
アロケーションの最小化
Sender/Receiverのチェーンは、コンパイル時に静的に最適化されるように設計されています。
可能な限りstd::execution::connectを直接呼び出すような構造にすることで、実行時の動的メモリ確保を排除できます。
軽量なスケジューラの選択
タスクの内容に応じて適切なスケジューラを選択することが重要です。
計算負荷が高い処理にはスレッドプールを、待機時間が多い処理にはイベントループベースのスケジューラを割り当てましょう。
適切なスケジューリングは、コンテキストスイッチの回数を減らし、スループットの向上に直結します。
まとめ
C++26における非同期処理の進化は、単なる機能追加ではなく、プログラミングモデルそのものの変革です。
std::executionによるSender/Receiverモデルは、非同期タスクの合成性とポータビリティを劇的に向上させました。
また、コルーチンとの融合により、直感的かつ高性能なコードを記述することが可能になりました。
これからのC++開発において、これらの新しい道具を使いこなすことは、効率的でスケーラブルなシステムを構築するための必須条件となるでしょう。
まずは小さなタスクからSender/Receiverを導入し、その強力な抽象化の恩恵を体感してみてください。