
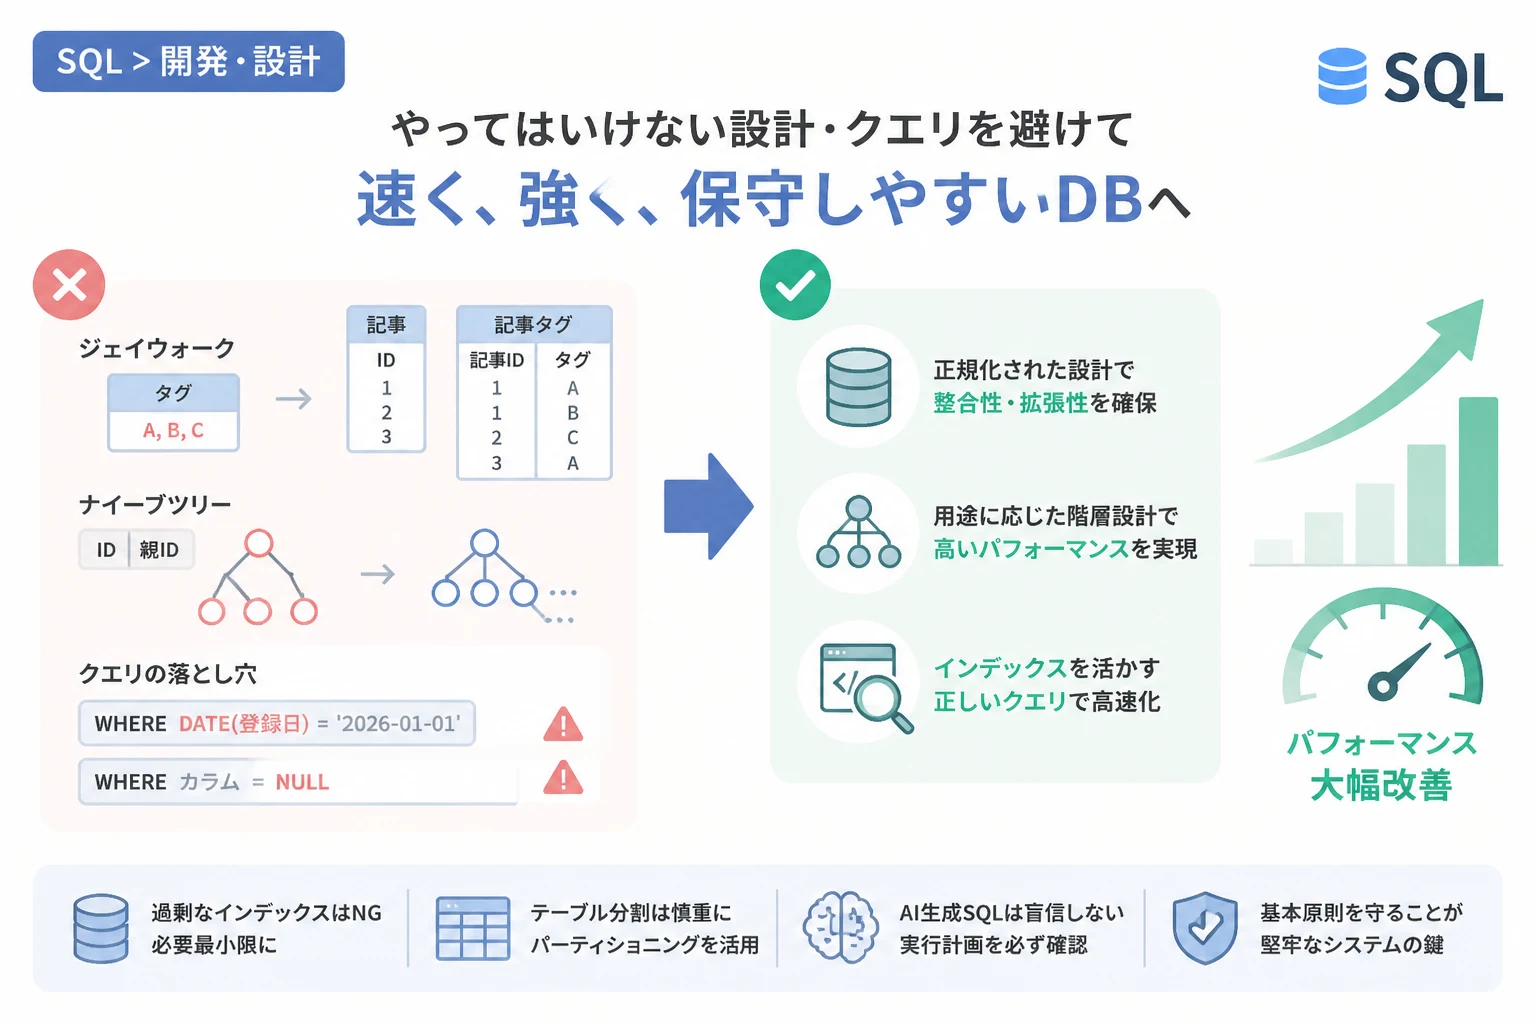
データベース技術が成熟した2026年においても、SQL設計の良し悪しがシステムの命運を分ける状況に変わりはありません。
クラウドネイティブな環境やAIによるクエリ自動生成が普及した現代だからこそ、エンジニアには「何が正解か」だけでなく「何がアンチパターンか」を正しく判断する力が求められています。
不適切な設計やクエリは、単にレスポンスを遅延させるだけでなく、データの整合性を損ない、将来的な機能拡張を阻害する大きな要因となります。
本記事では、現代のシステム開発において避けるべきSQLアンチパターンを整理し、保守性とパフォーマンスを劇的に向上させるための具体的な解決策を提示します。
現場で直面しがちな設計ミスや非効率なクエリの正体を暴き、2026年基準の最適化手法を身につけていきましょう。
論理設計におけるアンチパターン:データベースの土台を腐らせないために
データベースの設計段階で混入したアンチパターンは、後から修正することが極めて困難であり、システム全体の負債となります。
まずは、データの構造そのものに関する代表的な間違いを確認していきましょう。
ジェイウォーク(Jaywalking):カンマ区切りリストの罠
一つのカラムに対して、複数の値をカンマ区切りの文字列として格納してしまう手法を「ジェイウォーク」と呼びます。
例えば、製品テーブルの「カテゴリID」カラムに "1,2,5" のようにデータを保存するケースが該当します。
この設計は、特定のカテゴリを含む製品を検索する際に LIKE 演算子や正規表現を必要とし、インデックスを効率的に利用できません。
データの更新や削除も複雑になり、参照整合性をデータベース側で担保できないため、重大なバグの原因となります。
推奨される解決策:交差テーブルの導入
多対多の関係を表現する場合は、独立した「交差テーブル」を作成するのが正解です。
以下のコードは、アンチパターンを解消し、正規化されたテーブル構造を定義する例です。
-- アンチパターン:カンマ区切りでカテゴリを保持
-- CREATE TABLE products (id INT, category_ids TEXT);

-- 推奨される設計:交差テーブルの作成
CREATE TABLE products (
    product_id INT PRIMARY KEY,
    product_name VARCHAR(255) NOT NULL
);

CREATE TABLE categories (
    category_id INT PRIMARY KEY,
    category_name VARCHAR(100) NOT NULL
);

-- 製品とカテゴリを紐付ける交差テーブル
CREATE TABLE product_categories (
    product_id INT NOT NULL,
    category_id INT NOT NULL,
    PRIMARY KEY (product_id, category_id),
    FOREIGN KEY (product_id) REFERENCES products(product_id),
    FOREIGN KEY (category_id) REFERENCES categories(category_id)
);
ナイーブツリー(Naive Trees):再帰的な階層構造の扱い
組織図やコメントのツリー構造を表現する際、自分の親ID(parent_id)のみを保持する設計は「ナイーブツリー」と呼ばれます。
この設計は、直近の親子関係を取得するのは容易ですが、深い階層を一括で取得しようとすると複雑な再帰クエリやアプリケーション側でのループ処理が必要になります。
階層が深くなるほどクエリのパフォーマンスが指数関数的に悪化するため、大規模なデータセットでは致命的な問題となります。
ツリー構造を効率化する設計手法の比較
データの読み込み頻度や更新頻度に応じて、以下の手法を使い分けることが推奨されます。
| 手法名 | 特徴 | メリット | デメリット |
|---|---|---|---|
| 隣接リスト | parent_idを保持 | 実装が非常にシンプル | 深い階層の取得が困難 |
| 経路列挙(Path Enumeration) | /1/2/5/ のようにパスを保持 | 階層の検索が容易 | パスの文字列長に制限がある |
| 入れ子集合(Nested Sets) | 左右の数値を保持 | 検索が高速 | ノードの追加・移動が重い |
| 閉包テーブル(Closure Table) | 全ての親子関係を別表管理 | 最も柔軟で高速 | 別途テーブルの管理が必要 |
IDリクワイアド(ID Required):無意味なサロゲートキーの乱用
全てのテーブルに対して、一律で「id」という名前の連番主キーを付与することは、必ずしも正解ではありません。
特に交差テーブルにおいて、複合主キーではなく単一の連番IDを主キーにしてしまうと、同じデータの組み合わせが重複して登録されるリスクが生じます。
主キーの本来の役割は「行を一意に特定すること」であり、意味のある自然キー(Natural Key)が存在する場合はそちらを優先すべき場面もあります。
クエリ記述におけるアンチパターン:実行速度を奪う「書き方の癖」
設計が正しくても、クエリの書き方が不適切であればパフォーマンスは発揮されません。
ここでは、オプティマイザの最適化を妨げるNGな書き方を解説します。
フィア・オブ・ジ・アンノウン(Fear of the Unknown):NULLの誤用
SQLにおいて NULL は「不明」を意味する特殊な値であり、通常の比較演算子では期待通りに動作しません。
column = NULL と記述しても常に偽(正確にはUnknown)となるため、意図したデータが取得できないバグが発生します。
また、NOT IN 句のサブクエリの結果に NULL が含まれていると、全体の戻り値が空になってしまう性質は多くのエンジニアを苦しめます。
-- アンチパターン:NULLとの比較
-- SELECT * FROM users WHERE last_login = NULL;

-- 正しい書き方:IS NULL を使用する
SELECT * FROM users WHERE last_login IS NULL;

-- NOT IN の注意点
-- NULLを考慮しないと期待しない結果(空)になる
SELECT * FROM products
WHERE category_id NOT IN (SELECT id FROM categories WHERE status = 'active' OR id IS NULL);
インデックスを無効化する検索条件
インデックスが貼られているカラムであっても、クエリの書き方次第でフルテーブルスキャンが強制されます。
特にカラムに対して関数を適用したり、演算を行ったりする記述は、インデックスが効かなくなる代表例です。
現代のAIアシスタントはこの種の間違いを指摘してくれますが、自分自身で理解しておくことが重要です。
-- アンチパターン:インデックスが効かない(左辺に関数)
-- SELECT * FROM orders WHERE DATE(created_at) = '2026-05-01';

-- 推奨:インデックスを活かす(右辺を範囲指定にする)
SELECT * FROM orders
WHERE created_at >= '2026-05-01 00:00:00'
  AND created_at < '2026-05-02 00:00:00';

-- アンチパターン:文字列の結合や計算
-- SELECT * FROM users WHERE age + 1 > 20;

-- 推奨:定数側で計算する
SELECT * FROM users WHERE age > 19;
アンビギュアス・グループ(Ambiguous Groups):曖昧なGROUP BY
GROUP BY を使用する際、集約関数(SUM, AVGなど)を通していないカラムを選択リストに含めることは避けるべきです。
MySQLの旧バージョンなどでは許容されていましたが、どの行の値が返されるかが非決定的であり、データの信頼性を損ないます。
最新のSQL標準やPostgreSQL、Oracle等ではエラーとなりますが、設定次第で動いてしまう環境もあるため、常に明示的な集約を心がけましょう。
物理設計と運用のアンチパターン:スケーラビリティを確保する
データ量が増大した際に、システムが耐えられるかどうかは物理設計に依存します。
インデックス・ショットガン:手当たり次第のインデックス作成
パフォーマンスを上げようとして、全てのカラムにインデックスを貼ることは逆効果です。
インデックスは検索を高速化しますが、データの挿入(INSERT)、更新(UPDATE)、削除(DELETE)のたびにインデックスの再構築コストが発生します。
また、インデックス自体がストレージ容量を圧迫し、メモリ上のキャッシュ効率を低下させる要因にもなります。
「実行計画(EXPLAIN)」を確認し、実際に使われているインデックス、または必要な複合インデックスを絞り込むことがプロの仕事です。
メタデータ・トリブル(Metadata Tribbles):テーブルの切り出しミス
「logs_2025」「logs_2026」のように、年ごとにテーブルを分割してしまう手法はアンチパターンです。
これを行うと、複数年にまたがる集計クエリが極めて複雑になり、アプリケーション側のロジックも肥大化します。
現代の主要なRDBMSには「パーティショニング」機能が備わっており、物理的な格納場所を分けつつ、論理的には一つのテーブルとして扱うことが可能です。
-- パーティショニングを利用した例(PostgreSQL等)
CREATE TABLE sales_logs (
    id SERIAL,
    sale_date DATE NOT NULL,
    amount DECIMAL(10, 2)
) PARTITION BY RANGE (sale_date);

-- 子パーティションの定義
CREATE TABLE sales_logs_2025 PARTITION OF sales_logs
    FOR VALUES FROM ('2025-01-01') TO ('2026-01-01');

CREATE TABLE sales_logs_2026 PARTITION OF sales_logs
    FOR VALUES FROM ('2026-01-01') TO ('2027-01-01');
2026年におけるモダンSQLの注意点:クラウドとAI時代の落とし穴
テクノロジーが進化した現在でも、新しい環境特有のアンチパターンが生まれています。
サーバーレスデータベースのコスト・バースト
クラウドネイティブなサーバーレスDB(Amazon Aurora Serverless v2など)では、リソースの消費量に応じて課金されます。
非効率なクエリを放置すると、インフラコストが予期せず跳ね上がる「コスト・アンチパターン」に直面します。
かつては「動けば良い」とされていた重いクエリが、現代では直接的な経営リスクになることを意識しなければなりません。
AI任せの不透明なクエリ生成
LLM(大規模言語モデル)を利用してSQLを自動生成する場合、一見正しく見えるが効率が非常に悪いクエリが出力されることがあります。
AIは「最短の記述」を優先する傾向があり、実行時の負荷やロックの範囲を考慮しないケースが見受けられます。
AIが出力したSQLを盲信せず、必ず実行計画を確認するプロセスを開発フローに組み込むことが重要です。
チェックリスト:AI生成クエリのレビューポイント
- 不要なJOINが含まれていないか。
- WHERE句でインデックスが適切に活用されているか。
- 大量データを扱う際にLIMITやOFFSETの使い方が適切か。
- N+1問題を引き起こすような分割クエリになっていないか。
まとめ:アンチパターンを回避し続けるためのマインドセット
SQLアンチパターンを避けることは、単なる技術的な「正解」を求める作業ではありません。
それは、将来の自分やチームメンバーが苦労しないための、優しさと合理性を追求する行為です。
今回紹介したジェイウォークやナイーブツリーといった設計ミス、あるいはインデックスを殺すクエリの書き方は、いずれも「一時的な楽」を求めた結果として発生します。
2026年のエンジニアに求められるのは、最新のデータベース機能を理解した上で、普遍的なリレーショナルモデルの原則を忠実に守ることです。
「正規化を恐れない」「実行計画を必ず見る」「NULLの意味を正しく定義する」という基本に立ち返りましょう。
本記事で解説したアンチパターンを一つずつ排除していくことで、あなたのシステムは圧倒的な保守性とパフォーマンスを手に入れることができるはずです。
日々の開発の中で、クエリ一つを書く際にも「これはアンチパターンではないか?」と自問自答する習慣を身につけてください。
その積み重ねが、堅牢で美しいデータベース構造を構築するための最短ルートとなります。