
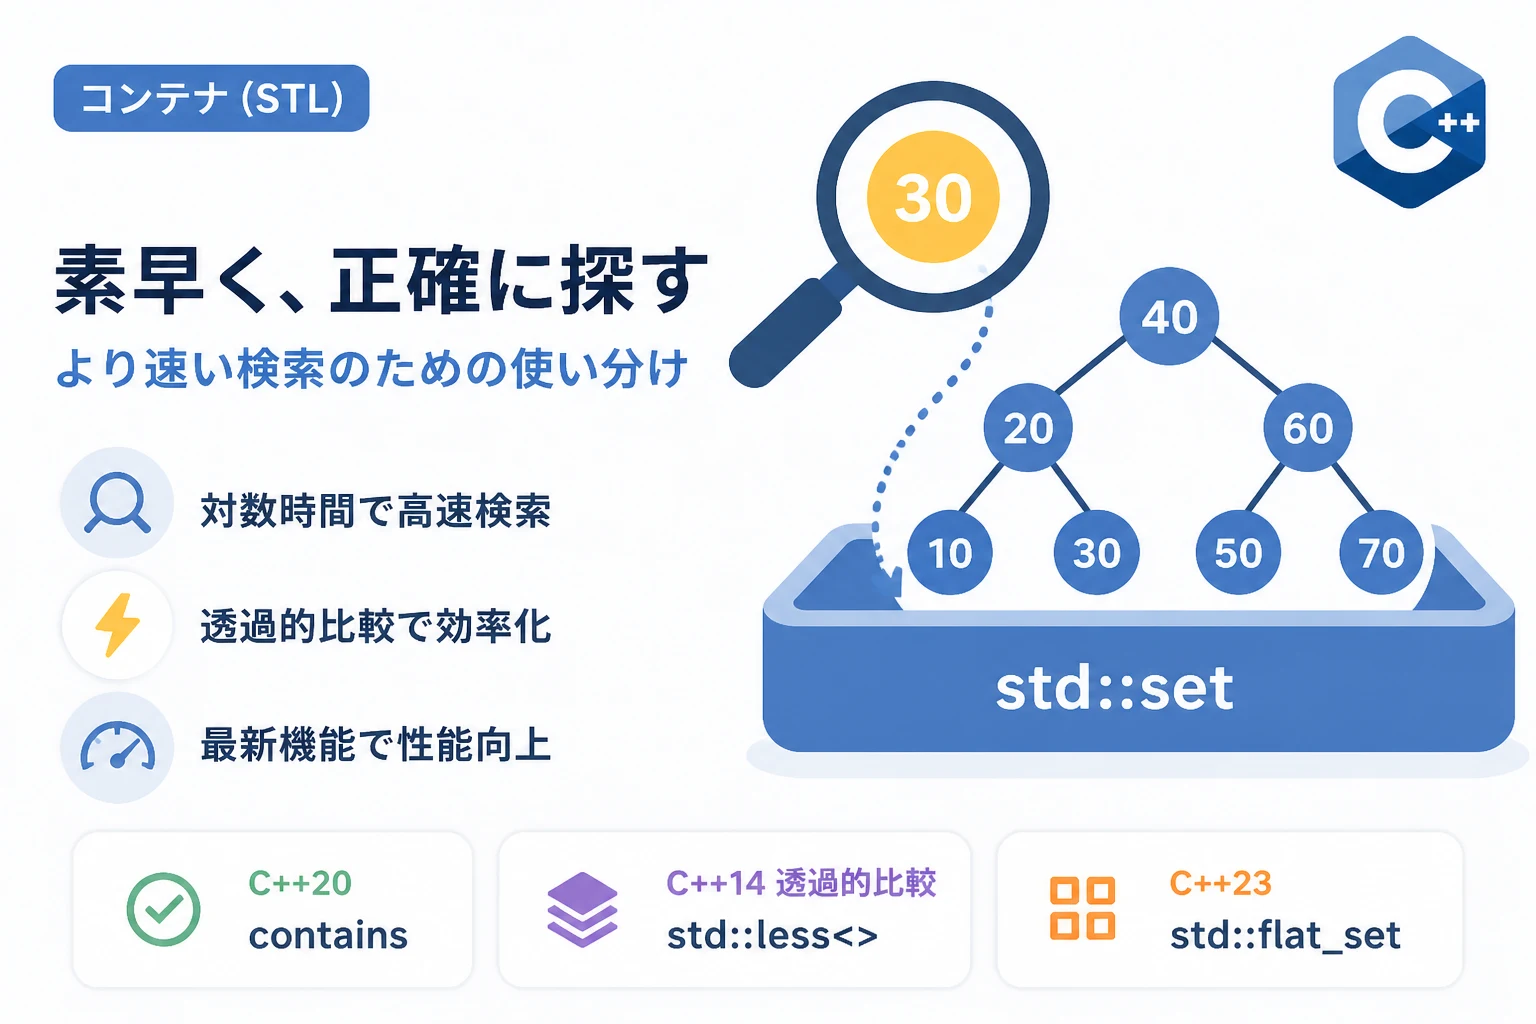
C++においてstd::setは、データを自動的にソートされた状態で保持し、重複を許さない便利なコンテナです。
データ構造には一般的に赤黒木などの平衡二分探索木が採用されており、要素の検索は非常に高速に行われます。
本記事では、基本的なset::findの使い方から、C++20、C++23、そして最新のC++26における進化までを詳しく解説します。
効率的な検索手法をマスターすることで、アプリケーションのパフォーマンスを大幅に向上させることが可能です。
C++におけるstd::set::findの基本
std::set::findは、指定したキーを持つ要素を検索し、その要素を指すイテレータを返すメンバ関数です。
検索アルゴリズムには二分探索が用いられているため、要素数をNとした場合に対数時間(O(log N))での検索が保証されています。
この関数は、要素が見つかった場合にはその要素へのイテレータを返し、見つからなかった場合にはend()イテレータを返します。
基本的な検索コードの書き方
まずは、最も標準的なfindの使用例を確認してみましょう。
#include <iostream>
#include <set>

int main() {
    // 整数を格納するsetを定義
    std::set<int> numbers = {10, 20, 30, 40, 50};

    // 30という値を検索
    auto it = numbers.find(30);

    // イテレータがend()でないことを確認
    if (it != numbers.end()) {
        std::cout << "要素が見つかりました: " << *it << std::endl;
    } else {
        std::cout << "要素は見つかりませんでした。" << std::endl;
    }

    return 0;
}要素が見つかりました: 30検索結果を扱う際は、必ずend()と比較して存在確認を行うのが鉄則です。
存在しない要素に対してイテレータをデリファレンス(*it)すると、未定義動作を引き起こすため注意してください。
検索の計算量とパフォーマンスの重要性
std::set::findの最大のメリットは、その計算量の安定性にあります。
std::vectorに対してstd::find(アルゴリズム版)を使用すると、先頭から順番に探すため線形時間(O(N))がかかってしまいます。
これに対し、std::set::findは木構造を辿るため、データ量が増大しても検索時間の増加が非常に緩やかです。
| 要素数 (N) | std::vector (O(N)) | std::set (O(log N)) |
|---|---|---|
| 1,000 | 約1,000回の比較 | 約10回の比較 |
| 1,000,000 | 約1,000,000回の比較 | 約20回の比較 |
| 1,000,000,000 | 約1,000,000,000回の比較 | 約30回の比較 |
大量のデータを扱う場合、適切なデータ構造の選択がパフォーマンスの鍵となります。
C++20における不均一探索(Heterogeneous Lookup)
C++20からは、std::set::findがより柔軟に進化しました。
従来のfindでは、検索時にコンテナに格納されている型と同じ型(あるいは変換可能な型)のオブジェクトを渡す必要がありました。
例えば、std::set<std::string>を検索する場合、これまではstd::string型のオブジェクトを一時的に作成して渡さなければなりませんでした。
これにより、文字列の動的メモリ確保(オーバーヘッド)が発生するという課題がありました。
C++20以降では、不均一探索(Heterogeneous Lookup)を利用することで、この問題を回避できます。
不均一探索の利用方法
不均一探索を有効にするには、std::setの比較関数にstd::less<void>(または透明な比較子)を指定します。
#include <iostream>
#include <set>
#include <string>
#include <string_view>

int main() {
    // std::less<> を指定することで不均一探索を有効化
    std::set<std::string, std::less<>> stringSet = {"Apple", "Banana", "Cherry"};

    // std::stringを作らずにstd::string_viewで検索可能
    std::string_view target = "Banana";
    auto it = stringSet.find(target);

    if (it != stringSet.end()) {
        std::cout << "見つかりました: " << *it << std::endl;
    }

    return 0;
}この機能により、不要なメモリ確保を抑えた高効率な検索が実現可能となりました。
C++23:待望のstd::set::containsの導入
C++23では、検索に関連する非常に便利なメンバ関数containsが追加されました。
これまでは、要素が存在するかどうかだけを知りたい場合でも、findを呼び出してend()と比較するという冗長な記述が必要でした。
containsを使えば、コードの意図がより明確になり、記述もシンプルになります。
#include <iostream>
#include <set>

int main() {
    std::set<int> s = {1, 2, 3};

    // C++23: containsで存在確認
    if (s.contains(2)) {
        std::cout << "2は存在します" << std::endl;
    }

    return 0;
}containsは内部的にfindと同様の検索を行いますが、戻り値がbool型であるため、条件式の中で直感的に記述できるのが利点です。
値を読み取る必要がなく、存在チェックだけが目的であれば、常にcontainsを使用することを推奨します。
C++26:さらなる検索の最適化とコンパイル時定数
2026年時点の最新仕様であるC++26では、標準ライブラリのさらなるconstexpr対応が進んでいます。
std::setに関連する操作の多くが、コンパイル時に実行可能となる範囲が広がっています。
これにより、メタプログラミングにおける検索処理が容易になり、実行時の負荷をゼロにする最適化が容易になりました。
検索に関わる細かな改善
また、C++26ではアルゴリズムとコンテナの親和性がさらに高まっています。
具体的には、std::setに対する範囲ベースの操作や、新しいrangesアルゴリズムとの統合が強化されました。
例えば、std::ranges::findではなく、コンテナ固有のfindメンバ関数を優先的に使うべきという設計指針は変わりませんが、テンプレートコードにおける一貫性が向上しています。
最新のコンパイラ(GCC 16, Clang 20など)を使用している場合、これらの高度な最適化の恩恵を受けることができます。
効率的な検索のためのベストプラクティス
set::findを使いこなすために、以下のポイントを意識しましょう。
1. アルゴリズム版std::findを使わない
#include <algorithm>に含まれるstd::find(s.begin(), s.end(), key)は、setの内部構造を利用しません。
そのため、計算量がO(N)に低下してしまうため、必ずメンバ関数のs.find(key)を使用してください。
2. データの重複を許す場合はmultisetを検討
同じキーを複数保持したい場合は、std::setではなくstd::multisetを使用します。
multiset::findは、一致する要素のうちの「いずれか1つ」へのイテレータを返します。
3. 検索速度が最優先ならunordered_setを検討
要素の順序(ソート状態)が不要であれば、std::unordered_setを使用する方が高速です。
unordered_set::findの平均計算量は定数時間(O(1))であり、ハッシュテーブルに基づいた検索が行われます。
ただし、最悪の場合の計算量がO(N)になる可能性があるため、リアルタイム性が求められるシステムでは慎重な検討が必要です。
各コンテナの検索性能比較
| コンテナ名 | データ構造 | 検索計算量 | 特徴 |
|---|---|---|---|
| std::set | 平衡二分探索木 | O(log N) | 常にソートされている |
| std::unordered_set | ハッシュテーブル | 平均O(1) / 最悪O(N) | 順序を保持しないが高速 |
| std::vector (ソート済み) | 動的配列 | O(log N) | std::binary_search等を使用 |
まとめ
C++のstd::set::findは、データの整合性を保ちながら高速に検索を行うための強力な手段です。
C++20の不均一探索によるメモリ節約、C++23のcontainsによる可読性向上、そしてC++26の進化によって、その利便性はさらに高まっています。
単純な値の有無を確認したいのか、それとも要素そのものにアクセスしたいのかという目的に応じて、最適な関数を選択することが重要です。
また、順序が必要ない場合にはunordered_setを選択するなど、コンテナの特性を理解した使い分けを心がけましょう。
今回紹介したテクニックを活用し、モダンで効率的なC++コードを記述していきましょう。