
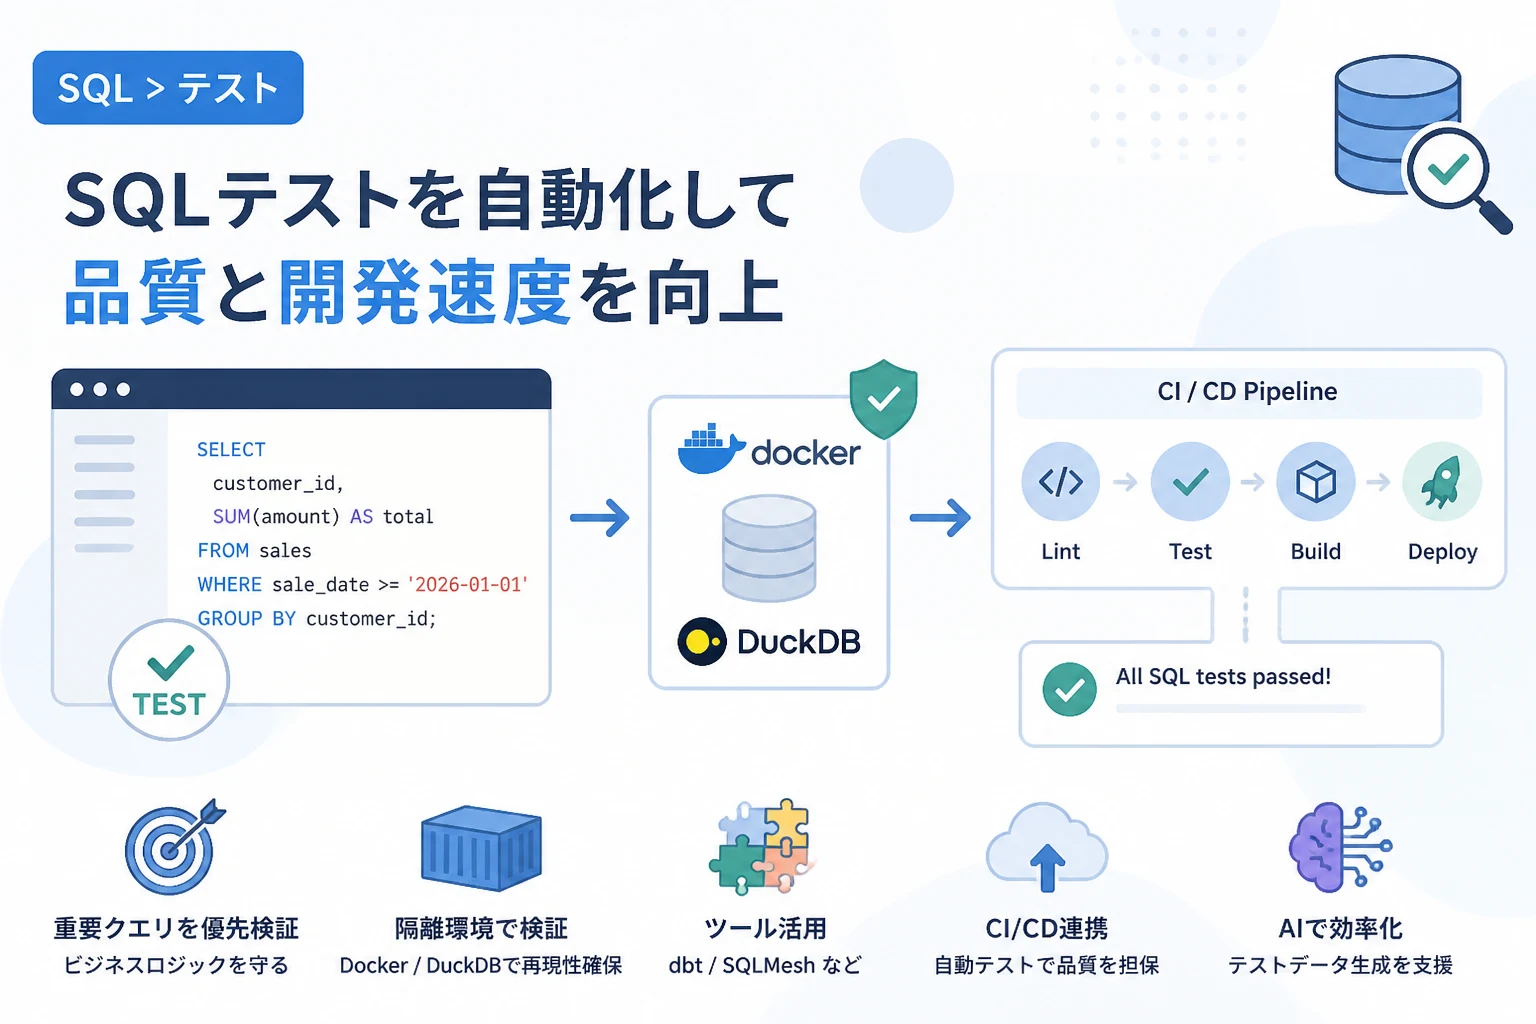
現代のデータ駆動型ビジネスにおいて、SQLは単なるクエリ言語ではなく、ビジネスロジックの中核を担う重要なコンポーネントとなりました。
2026年現在、データウェアハウス(DWH)やデータレイクハウスの進化により、SQLで記述される処理はかつてないほど複雑化しています。
このような状況下で、システムの信頼性を担保するためには、アプリケーション開発と同様にSQLの単体テストを自動化することが不可欠です。
本記事では、最新のツールや手法を交えながら、SQL単体テストの設計からCI/CD連携までの具体的なプロセスを詳しく解説します。
SQL単体テストの重要性と2026年のトレンド
かつてSQLのテストは、本番環境に近いデータをコピーして手動でクエリを実行する「経験則」に頼る部分が多くありました。
しかし、データエンジニアリングの分野でも「Shift-Left(シフトレフト)」の考え方が浸透し、開発の早期段階でのテストが標準となっています。
特に、マイクロサービス化や分散型データベースの普及により、小さなSQLのバグがシステム全体に深刻な影響を及ぼすリスクが増大しています。
2026年においては、データ契約(Data Contracts)の概念が普及し、SQLクエリが期待通りのスキーマと値を返すことを保証する重要性がさらに高まっています。
また、生成AIを活用したSQLコードの自動生成が一般化したことで、人間が書いたコード以上に厳密なバリデーションが求められるようになりました。
自動化された単体テストは、手動テストでは防ぎきれない「サイレント・データ・コラプション(静かなデータの破損)」を防ぐための唯一の防波堤です。
これにより、データパイプラインの変更に伴う回帰テストの工数を大幅に削減し、開発サイクルの高速化を実現できます。
SQL単体テストの設計指針
SQL単体テストを効果的に行うためには、何をテストし、何をテストしないかを明確にする設計指針が必要です。
テスト対象の明確化
すべてのクエリを網羅的にテストするのではなく、ビジネスロジックが含まれる部分を優先してテスト対象を選定します。
具体的には、複雑なJOIN処理、ウィンドウ関数を使用した分析クエリ、CASE式による条件分岐などが該当します。
また、ユーザー定義関数(UDF)やストアドプロシージャも、単体テストによる品質保証が強く推奨される対象です。
テストデータの作成戦略
テストの再現性を確保するために、本番データに依存しない「隔離されたテストデータ」を使用することが基本原則です。
2026年のベストプラクティスとしては、以下の2つのアプローチが主流となっています。
- インメモリデータベースの活用:SQLiteやDuckDBを使用して、高速にスクラップ&ビルド可能な環境でテストを実行する。
- コンテナベースのテスト環境:Dockerを使用して、本番と同じDBエンジン(PostgreSQL, MySQLなど)を瞬時に立ち上げてテストを行う。
テストデータ自体は、境界値分析や等価分割法に基づき、エッジケース(NULL値、極端な大きな値、重複データなど)を意図的に含めるように設計します。
期待される結果の定義
単体テストでは、「入力データ」に対して「期待される出力結果(期待値)」をあらかじめ用意しておきます。
SQLの実行結果と期待値を比較し、1行1列でも差分があればテスト失敗と見なします。
この際、浮動小数点の誤差や日付フォーマットの揺れを許容するかどうかも、テスト設計時に定義しておく必要があります。
SQL単体テストの主要な自動化手法
SQLの単体テストを自動化するには、言語やフレームワークに応じた複数の手法が存在します。
フレームワークを利用したアプローチ
現代のデータ開発において、最も普及しているのがdbt (data build tool)などのフレームワークを活用した手法です。
dbtでは、YAMLファイルにテスト条件を記述するだけで、スキーマチェックや参照整合性のテストを自動化できます。
さらに、dbt-unit-testingパッケージを使用することで、特定のモデルに対する入出力をモック化し、ロジックのみを抽出してテストすることが可能です。
コンテナ技術を活用した隔離環境での実行
データベース製品固有の関数や構文(Window関数やJSON処理など)を多用する場合、本番と同じエンジンでのテストが不可欠です。
Testcontainersなどのライブラリを使用すると、Java、Python、Goなどのプログラミング言語からDBコンテナを動的に制御し、テストを実行できます。
これにより、ローカル環境でもCI/CDパイプライン上でも、全く同じ条件でSQLの動作検証が可能になります。
プログラミング言語によるラッパーテスト
PythonのpytestやNode.jsのJestを使用して、SQLクエリを文字列として読み込み、データベースへ実行して結果を検証する手法も一般的です。
この手法は、SQLだけでなく、その前後のアプリケーションロジックを含めた結合テストに近い単体テストを行いたい場合に有効です。
おすすめのSQL単体テストツール(2026年版)
2026年の最新状況を踏まえた、推奨されるツールを以下の表にまとめました。
| ツール名 | 主な対象環境 | 特徴 |
|---|---|---|
| dbt-unit-testing | Snowflake, BigQuery, Redshift | dbt環境でのデファクトスタンダード。モデル単位のモックテストが容易。 |
| SQLMesh | マルチプラットフォーム | 2020年代半ばから急成長した次世代ツール。効率的な増分更新とテスト機能を備える。 |
| pgTAP | PostgreSQL | PostgreSQL特化型の強力なテストフレームワーク。SQLのみでテストを完結。 |
| tSQLt | SQL Server | SQL Server用の単体テストフレームワーク。トランザクションによるロールバックが可能。 |
| SQLGlot | 汎用(トランスパイラ) | SQLの構文解析に基づき、実行前に論理エラーを検知することが可能。 |
実践例:SQL単体テストのコード実装
ここでは、Pythonのテストフレームワークであるpytestと、軽量なインメモリDBであるDuckDBを組み合わせたSQL単体テストの実装例を紹介します。
この例では、ユーザーの年齢から成人かどうかを判定するシンプルなSQLロジックをテストします。
import duckdb
import pytest

# テスト対象のSQLロジック
def get_adult_status_query(source_table):
    return f"""
    SELECT
        user_id,
        age,
        CASE
            WHEN age >= 20 THEN 'Adult'
            ELSE 'Minor'
        END as status
    FROM {source_table}
    """

def test_adult_status_logic():
    # 1. DuckDBのインメモリ接続を作成
    con = duckdb.connect(database=':memory:')

    # 2. テスト用の入力データを用意
    con.execute("CREATE TABLE users (user_id INTEGER, age INTEGER)")
    con.execute("INSERT INTO users VALUES (1, 25), (2, 18), (3, 20)")

    # 3. クエリを実行
    query = get_adult_status_query("users")
    result = con.execute(query).fetchdf()

    # 4. 結果を検証(期待値との比較)
    # user_id 1: 25歳 -> Adult
    assert result.loc[result['user_id'] == 1, 'status'].values[0] == 'Adult'
    # user_id 2: 18歳 -> Minor
    assert result.loc[result['user_id'] == 2, 'status'].values[0] == 'Minor'
    # user_id 3: 20歳 -> Adult
    assert result.loc[result['user_id'] == 3, 'status'].values[0] == 'Adult'

    print("Test passed successfully!")

if __name__ == "__main__":
    test_adult_status_logic()
上記のコードを実行した際の出力結果は以下の通りです。
Test passed successfully!このように、SQLをロジックとして分離し、モックデータでテストを行うことで、データベース環境の有無に左右されずにロジックの正当性を証明できます。
CI/CDパイプラインへの統合
単体テストは、開発者のローカル環境で実行するだけでなく、CI/CDパイプラインに統合してこそ真価を発揮します。
GitHub Actionsでの自動実行
2026年において最も一般的な方法は、GitHub ActionsなどのCIツールを使用して、プルリクエストが作成されるたびにSQLテストを自動実行する構成です。
CI環境上で一時的なデータベースコンテナを起動し、テストスクリプトを実行するワークフローを定義します。
これにより、ロジックを破壊するような変更が誤ってマージされるのを未然に防ぐことができます。
データ品質チェックとの連携
単体テストが「コードの正しさ」を検証するのに対し、CI/CD後半のステージでは「データの正しさ」を検証するデータ品質チェック(Great Expectationsなど)を配置します。
単体テストに合格したコードだけがステージング環境へデプロイされ、そこで実際のデータセットを用いたテストが行われるという多段構えのガードレールを構築します。
このフローにより、データパイプラインの信頼性は飛躍的に向上します。
SQLテスト自動化の課題と対策
自動化には多くのメリットがありますが、導入にあたって直面しやすい課題も存在します。
最大の課題は、複雑な依存関係を持つテーブルのモック作成に手間がかかることです。
これに対しては、2026年現在、AIによるテストデータ自動生成ツールが解決策として注目されています。
既存のスキーマ定義をAIに読み込ませることで、リレーションを維持したままの整合性のあるテストデータを数秒で生成できるようになりました。
また、テストの実行速度が低下する問題に対しては、変更があったSQLファイルに関連するテストのみを特定して実行する「差分テスト」の手法が有効です。
まとめ
2026年におけるSQL単体テストは、単なる「念のための確認」ではなく、データ基盤の安定稼働を支えるエンジニアリングの根幹です。
自動化手法やツールの選択肢は増えており、プロジェクトの規模や使用しているDWHに最適な構成を柔軟に選択できる時代になりました。
dbtやSQLMeshといったモダンなツールの活用に加え、CI/CDパイプラインへの完全な統合を目指すことが、高品質なデータ提供への近道です。
まずは、ビジネスへの影響が大きい重要なクエリからスモールステップで自動テストを導入し、徐々にカバレッジを広げていくことをおすすめします。
本記事で紹介した設計指針や実装例を参考に、堅牢なSQL開発プロセスを構築してください。