
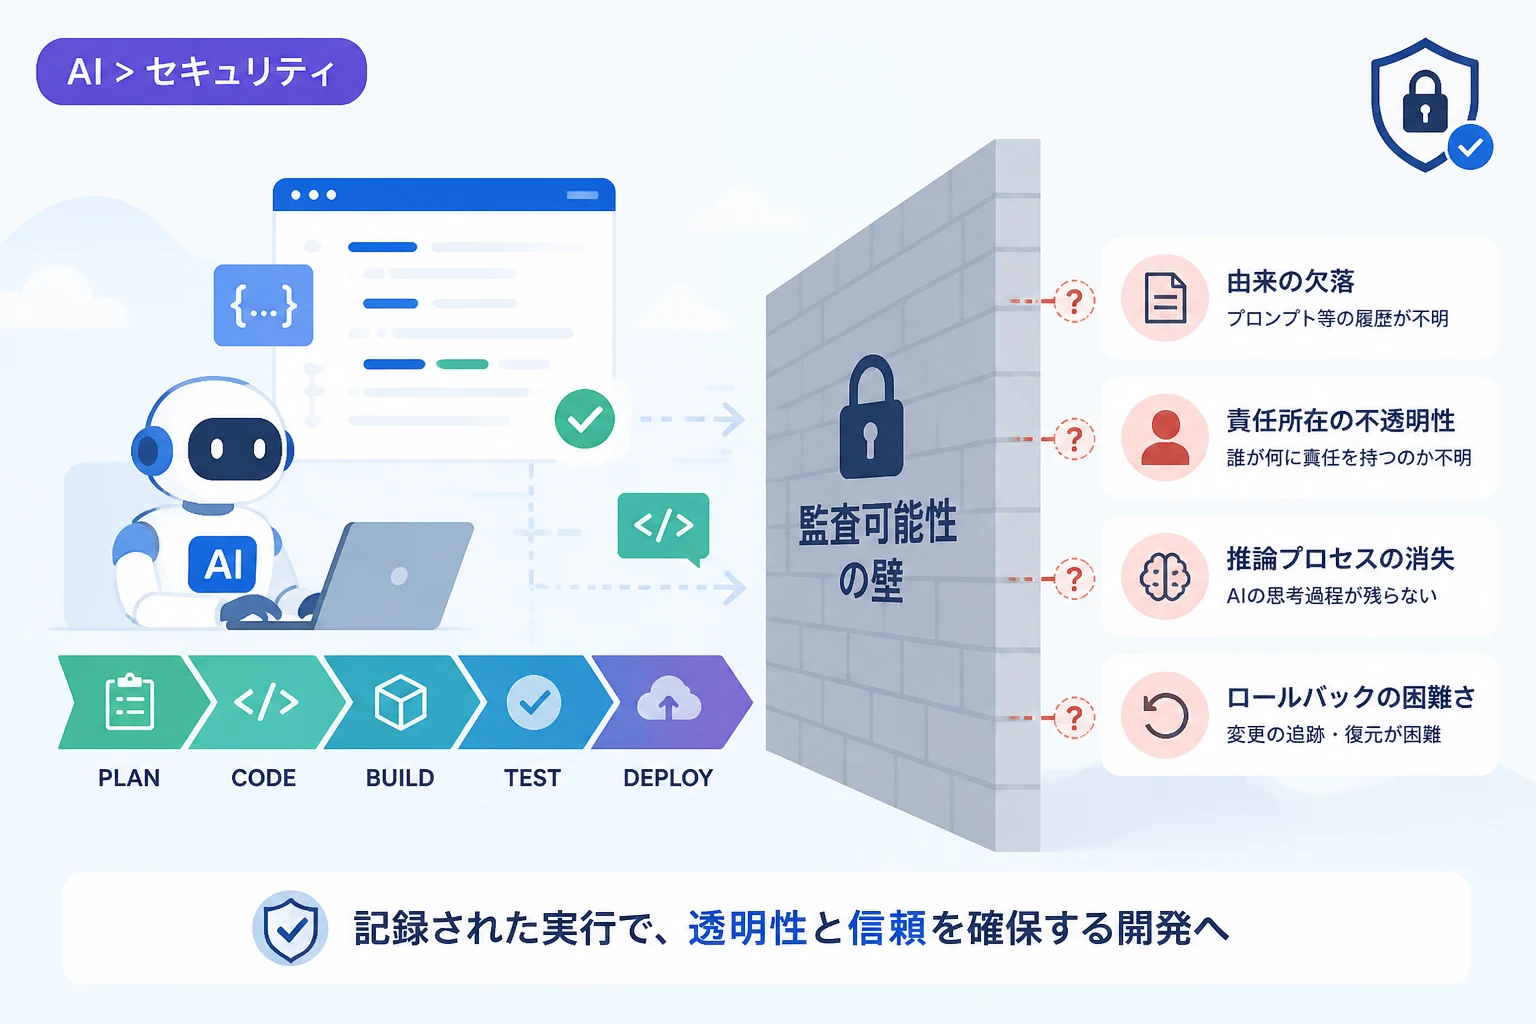
現代のソフトウェア開発において、AIコーディングエージェントの導入は驚異的なスピードで進んでいます。
GitLabが示唆するように、AIによる自動化はデリバリー速度を劇的に向上させますが、一方で企業のコンプライアンス部門にとっては新たな難問を突きつけています。
多くの組織では、AIエージェントがマージリクエスト (MR) を作成し、パイプラインが正常に動作していることに満足し、その裏側に潜むリスクを軽視しがちです。
しかし、規制の厳しい業界では「何が行われたか」だけでなく、「なぜ、誰の責任で、どのような根拠に基づき行われたか」という透明性が不可欠となります。
本記事では、AIエージェントによる開発自動化が直面している「監査可能性」の壁と、それを克服するための戦略について深く掘り下げます。
開発速度の向上とガバナンスの乖離
AIエージェントの導入によって、エンジニアリングチームのベロシティ(開発速度)指標は確実に改善の兆しを見せています。
しかし、金融機関などの厳格な規制環境下にある組織では、内部監査チームから鋭い質問が投げかけられるようになっています。
例えば、AIエージェントが決済サービスの依存関係を更新するMRを作成した場合、その変更を誰が承認し、どのようなプロンプトが使用されたかを即座に証明できるでしょうか。
現状の多くの開発現場では、AIエージェントの作業は「境界が定義されていないトランザクション」として処理されており、監査に耐えうる記録が残っていません。
デリバリーシステムがAIの思考プロセスやコンテキストを捕捉できていないことが、最大のボトルネックとなっているのです。
露呈する4つのコンプライアンス例外
AIエージェントがCI/CD環境で自律的に活動を始めると、予測可能な4つのコンプライアンス上の課題が浮き彫りになります。
1. プロバナンス(由来)の欠落
AIエージェントがどのような入力を消費したのか、どのリポジトリの状態を参照したのかを証明する手段がありません。
タスクの仕様書、検索されたコンテキストの参照、ツールへの呼び出し履歴が保存されていないため、変更の「正当な由来」を辿ることが困難です。
2. アイデンティティ帰属の不透明性
多くの場合、AIエージェントは共有のサービスアカウントやトークンを使用して操作を行います。
その結果、人間が意図した変更なのか、AIが自律的に判断した変更なのかを区別することができなくなります。
責任の所在が曖昧になることは、エンタープライズレベルのセキュリティにおいて致命的な欠陥となります。
3. 意思決定チェーンの再構築不可
AIがなぜそのコードを選択したのか、どのようなポリシーチェックを事前に評価したのかという「推論プロセス」は、エフェメラル(一時的)なトレースの中に消えてしまいます。
後から監査人が「なぜこの依存関係が選ばれたのか」を問い詰めても、再現可能な形で回答を示すことができません。
4. ロールバック境界の曖昧さ
AIによる複数の変更が密結合している場合、問題が発生した際に特定の作業ユニットだけを切り離して元に戻すことが困難です。
トランザクションの境界が明確でないため、手作業による複雑なコミットの「考古学調査」が必要になります。
なぜ既存のCIログでは不十分なのか
人間が作成するMRの場合、変更の差分(diff)、承認記録、そしてパイプラインの実行結果があれば、エビデンスとしては十分でした。
しかし、AIエージェントが作成するMRには、それらに加えて「タスク仕様」「使用されたモデルのバージョン」「ポリシー評価ログ」などの膨大な付随情報が必要となります。
既存のCIログは「何が起きたか(Output)」は記録しますが、「AIが何を見てどう考えたか(Context & Reasoning)」を記録するようには設計されていません。
以下の表は、人間による開発とAIエージェントによる開発で求められる監査項目の違いをまとめたものです。
| 監査項目 | 人間による開発 | AIエージェントによる開発 |
|---|---|---|
| 変更の動機 | コミットメッセージ・課題票 | プロンプト・タスク仕様・検索コンテキスト |
| 実行主体 | 個人のユーザーID | AIの識別子 + 承認した人間のID |
| 判断基準 | エンジニアの経験・レビュー | モデルの推論ログ・ポリシー評価結果 |
| 再現性 | コードの再ビルド | 入力の固定(Pinned Input)による再実行 |
「記録された実行(Recorded Execution)」の実装
この問題を解決するためには、プラットフォームエンジニアリングの範疇として「記録された実行」という概念を導入する必要があります。
これは、AIエージェントのすべての活動を、単なるテキストログではなく、構造化された永続的なアーティファクトとして保存する仕組みです。
具体的には、以下のようなJSON形式のメタデータを各MRに紐付けることが推奨されます。
{
  "agent_execution_record": {
    "transaction_id": "ax-789-q2",
    "timestamp": "2026-05-12T10:30:00Z",
    "human_sponsor": "user-456",
    "agent": {
      "model": "gpt-4-turbo-2026",
      "version": "v2.1.0"
    },
    "context_refs": [
      "repo:payment-service@sha256:abc...",
      "doc:security-policy-v4"
    ],
    "policy_checks": [
      {
        "rule": "dependency-vulnerability-check",
        "result": "passed",
        "reasoning": "No known CVEs for selected version"
      }
    ],
    "tool_calls": [
      {
        "tool": "npm-search",
        "args": "axios@latest"
      }
    ]
  }
}
このような記録があれば、監査人は1時間以内にエビデンスを収集し、特定の変更が企業のガバナンスに従っているかを検証できます。
戦略的な「記録レイヤー」の構築
競争圧力によって開発のスピードを優先したくなるのは理解できますが、ガバナンスを後回しにすることのリスクは甚大です。
規制当局の検査で見つかる「エビデンスの欠落」は、単なるビルドの失敗よりもはるかに高コストな修正を伴うからです。
リーダーシップ層は、「AIエージェントのための実行記録レイヤー」の構築を、コンプライアンス上のオーバーヘッドではなく、製品の重要な機能として定義すべきです。
まずは、依存関係の変更やIaC(Infrastructure as Code)の修正など、リスクの高いユースケースから優先的に記録の自動化を開始してください。
まとめ
AIエージェントによる開発の爆発的な普及は、DevSecOpsのあり方を根本から変えようとしています。
しかし、監査可能性を欠いた自動化は、いずれ組織の成長を阻害する大きな制約となります。
「Provenance(由来)」「Identity(アイデンティティ)」「Decision Chain(意思決定チェーン)」「Rollback(ロールバック)」の4点を軸に、透明性の高いワークフローを再構築することが、次世代の開発プラットフォームには求められています。
テクノロジーの進化に歩調を合わせ、「信頼できる自律性」をいかに確立するかが、今後のDevSecOps戦略の成否を分けるでしょう。