
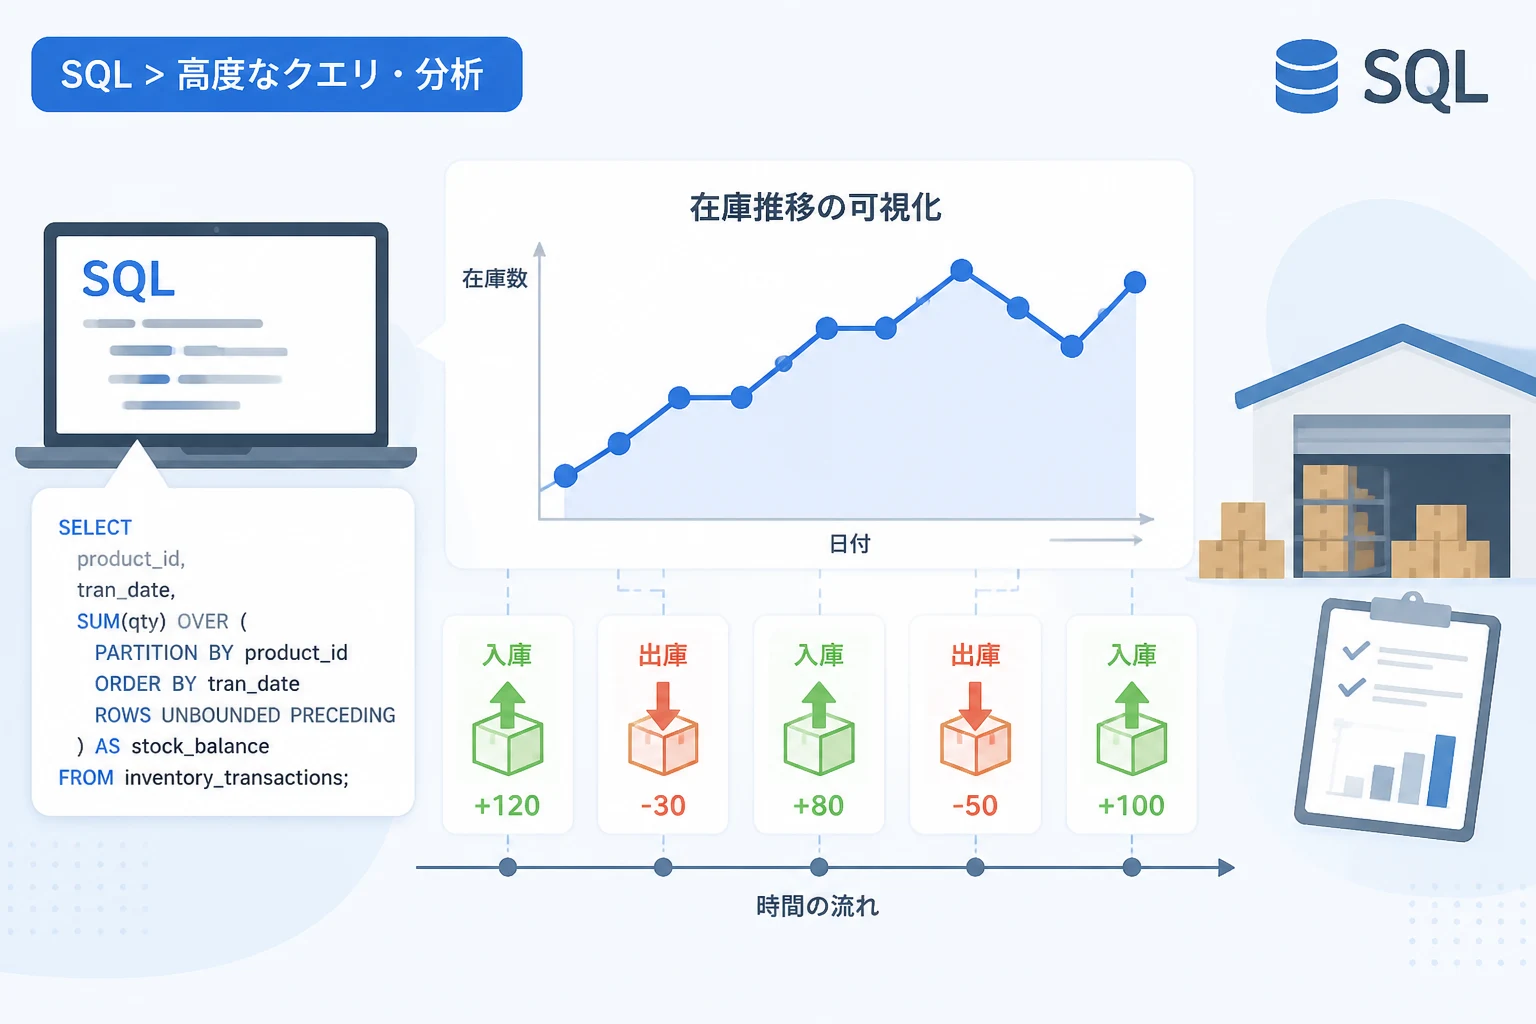
在庫管理は、企業の利益を最大化するために避けては通れない重要な業務の一つです。
適切な在庫数を常に把握しておくことで、過剰在庫によるキャッシュフローの悪化や、欠品による機会損失を未然に防ぐことが可能になります。
特に膨大な商品データを扱う現代のビジネスシーンにおいて、データベースから直接「在庫の推移」を算出する技術は、データサイエンティストやシステムエンジニアにとって必須のスキルといえるでしょう。
本記事では、SQLのウィンドウ関数を活用して、日々の入出庫データから在庫の推移を導き出す具体的な手法を詳しく解説します。
在庫推移をSQLで管理する重要性
在庫推移とは、ある時点の在庫数に対して、その後の入庫数と出庫数を加減算して算出される連続的なデータのことを指します。
従来の表計算ソフトでは、データ量が増加するにつれて処理が重くなり、リアルタイムな分析が困難になるという課題がありました。
SQLを用いることで、数百万行を超えるトランザクションデータからでも、高速かつ正確に在庫の変動を可視化することが可能になります。
リアルタイムな在庫把握のメリット
SQLによる在庫計算を導入する最大のメリットは、常に最新の状況に基づいた意思決定ができる点にあります。
例えば、特定の商品の在庫が急激に減少している傾向をクエリ一つで特定できれば、自動発注システムとの連携もスムーズに行えます。
また、過去の在庫推移を分析することで、季節ごとの需要予測や在庫回転率の向上にも役立てることができます。
データに基づいた客観的な判断は、経験や勘に頼らない効率的なロジスティクス戦略の構築に寄与します。
手動管理(Excelなど)の限界
Excelなどの表計算ソフトでも在庫計算は可能ですが、履歴データが蓄積されるほどファイルサイズが肥大化します。
複数のユーザーが同時にアクセスしてデータを更新する場合、データの整合性を保つことが難しくなるというリスクも存在します。
SQLであれば、トランザクション処理によってデータの整合性が保証され、複数人による同時操作も安全に行うことができます。
さらに、他の業務システムやBIツールとの連携が容易であるため、データ利活用の幅が大きく広がります。
在庫推移算出の基本ロジック
SQLで在庫推移を算出する際の基本的な考え方は、「累積和(Running Total)」の計算です。
在庫の基本式は、現在の在庫 = 前日の在庫 + 本日の入庫数 - 本日の出庫数 で表されます。
これをSQLの集合論として捉えると、特定の基準日(あるいは期首)からのすべての増減を合計していく処理になります。
入庫と出庫の差分計算
まず、データベースには「入庫」と「出庫」が別々のレコード、あるいは別々のカラムとして記録されていることが一般的です。
在庫推移を計算する前段階として、これらの値を「変動量」として一つの数値にまとめる必要があります。
入庫をプラスの数、出庫をマイナスの数として定義することで、単純な合計処理(SUM)だけで在庫の変動を計算できるようになります。
累積和(Running Total)の考え方
累積和とは、データの並び順に従って、それまでの値を次々に足し合わせていく計算手法です。
在庫管理においては、日付順にレコードを並べ、その時点までの増減量を累計したものが「その時点での在庫数」となります。
SQLでは、この累積和を算出するためにウィンドウ関数(Window Function)が利用されます。
ウィンドウ関数は、特定の範囲(ウィンドウ)に対して集計処理を行う強力な機能であり、在庫推移の算出には欠かせません。
ウィンドウ関数(OVER句)を活用した在庫計算
SQLにおいて累積和を求める標準的な方法は、SUM() 関数と OVER 句を組み合わせることです。
この機能を使うことで、自己結合(Self Join)などの複雑な記述を避けて、シンプルかつ高速なクエリを記述できます。
SUM() OVERの基本構文
基本的な構文は、SUM(集計対象) OVER (ORDER BY ソートキー) という形になります。
ORDER BY に日付やIDを指定することで、その並び順に沿った累計が計算されます。
例えば、以下のコードは日付順に数量を累積する例です。
SELECT
    transaction_date,
    quantity,
    SUM(quantity) OVER (ORDER BY transaction_date) AS stock_running_total
FROM
    inventory_logs;
このクエリにより、各行にはその日までの合計在庫が表示されるようになります。
ORDER BYとROWS BETWEENの役割
ウィンドウ関数内で ORDER BY を使用すると、デフォルトでは「先頭行から現在の行まで」が集計対象となります。
この動作を明示的に制御するために、ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW というオプションが使われることもあります。
これは「無制限に前の行から現在の行までを範囲とする」という意味を持ち、在庫推移の算出において標準的な指定方法です。
データベースの種類(PostgreSQL, MySQL 8.0+, SQL Server, Oracleなど)によっては、この記述を省略しても ORDER BY があれば自動的に累積和として処理されます。
実践的なSQLクエリの構築手順
それでは、実際に使用可能なテーブル構造を想定して、在庫推移を算出するステップを見ていきましょう。
ここでは、商品の入出庫履歴を管理するテーブルを用意し、そこから日ごとの在庫推移を導き出します。
テーブル構造の定義
まずは、サンプルの入出庫テーブルを作成します。
-- 入出庫履歴テーブルの作成
CREATE TABLE stock_transactions (
    id SERIAL PRIMARY KEY,
    product_id INT NOT NULL,
    transaction_date DATE NOT NULL,
    change_qty INT NOT NULL -- 入庫は正、出庫は負の数
);

-- サンプルデータの挿入
INSERT INTO stock_transactions (product_id, transaction_date, change_qty) VALUES
(101, '2026-05-01', 100), -- 入庫
(101, '2026-05-02', -20), -- 出庫
(101, '2026-05-03', -10), -- 出庫
(101, '2026-05-04', 50),  -- 入庫
(101, '2026-05-05', -40); -- 出庫
日ごとの集計処理
実務では、1日に複数の入出庫が発生することが多いため、まずは日付単位で集計を行うのが一般的です。
CTE(共通テーブル式)を使用して、1日の合計変動量を算出してから累積和を求めると、結果が見やすくなります。
WITH daily_summary AS (
    SELECT
        transaction_date,
        SUM(change_qty) AS daily_change
    FROM
        stock_transactions
    WHERE
        product_id = 101
    GROUP BY
        transaction_date
)
SELECT
    transaction_date,
    daily_change,
    SUM(daily_change) OVER (ORDER BY transaction_date) AS current_stock
FROM
    daily_summary
ORDER BY
    transaction_date;
実行結果の確認
上記のクエリを実行した結果、以下のような在庫推移データが得られます。
 transaction_date | daily_change | current_stock
------------------+--------------+---------------
 2026-05-01       |          100 |           100
 2026-05-02       |          -20 |            80
 2026-05-03       |          -10 |            70
 2026-05-04       |           50 |           120
2026-05-05 | -40 | 80このように、各日付の終了時点における在庫の残高(current_stock)が正しく計算されていることがわかります。
在庫推移計算における注意点と応用
実務における在庫管理は、単純な累計計算だけでは不十分なケースがあります。
データの不備や、期首の繰り越し処理など、考慮すべきポイントがいくつか存在します。
期首残高の取り扱い
データベースを運用し始める前の在庫(期首在庫)がある場合、それを計算の起点にする必要があります。
一つの方法は、特定の過去日付に「初期在庫」としてのレコードを挿入しておくことです。
あるいは、クエリ内で定数を加算する方法もありますが、管理のしやすさを考えるとマスタデータや初期設定レコードとして保持しておくのが望ましいでしょう。
商品カテゴリー別の推移
複数の商品を同時に扱う場合、PARTITION BY 句を使用します。
これにより、商品ごとに独立した累積和を一度のクエリで計算することが可能になります。
SELECT
    product_id,
    transaction_date,
    change_qty,
    SUM(change_qty) OVER (PARTITION BY product_id ORDER BY transaction_date) AS stock_by_product
FROM
    stock_transactions;
PARTITION BY product_id を指定することで、商品IDが切り替わるタイミングで累計値がリセットされるようになります。
欠品データの可視化
在庫推移を分析する際、在庫が「0」を下回る、いわゆるマイナス在庫が発生していないかを確認することが重要です。
SQLで算出した current_stock に対して、CASE 式を用いることでアラートを表示させることができます。
SELECT
    transaction_date,
    current_stock,
    CASE WHEN current_stock < 0 THEN '要確認' ELSE '正常' END AS status
FROM (
    -- ここに先程の累積和クエリを記述
) sub;
パフォーマンス最適化のポイント
大量のデータを扱う場合、ウィンドウ関数の実行速度が問題になることがあります。
パフォーマンスを維持するためには、適切な設計が不可欠です。
インデックスの活用
ウィンドウ関数の ORDER BY や PARTITION BY で使用するカラムには、インデックスを貼っておくことが基本です。
特に (product_id, transaction_date) のような複合インデックスは、特定商品の在庫推移を抽出する際に劇的な効果を発揮します。
インデックスがない場合、データベースは全行をスキャンしてソート処理を行う必要があるため、実行時間が大幅に増加します。
中間テーブルやビューの作成
在庫推移を頻繁に参照する場合、毎回最初からの累積を計算するのは非効率です。
例えば、月末時点の在庫確定値を別のテーブルに保存しておくなどの工夫が考えられます。
これを「スナップショット」と呼び、計算の起点となる過去の確定値を参照することで、計算対象となるデータ範囲を限定し、負荷を軽減させます。
まとめ
SQLを用いた在庫推移の算出は、ウィンドウ関数を活用することで驚くほどシンプルに実現できます。
SUM() OVER 句を使いこなし、日付ごとの累積和を求める手法は、在庫管理だけでなく売上推移やユーザー行動分析など、幅広い分野で応用可能です。
実務においては、初期在庫の扱い方や、商品ごとのパーティション分割、さらには大量データに対するパフォーマンス対策が重要となります。
本記事で紹介した基本クエリや最適化の考え方を参考に、ぜひ自社のデータ分析やシステム開発に役立ててください。
正確な在庫データの推移を可視化することは、迅速かつ的確なビジネス判断を下すための第一歩となるはずです。