
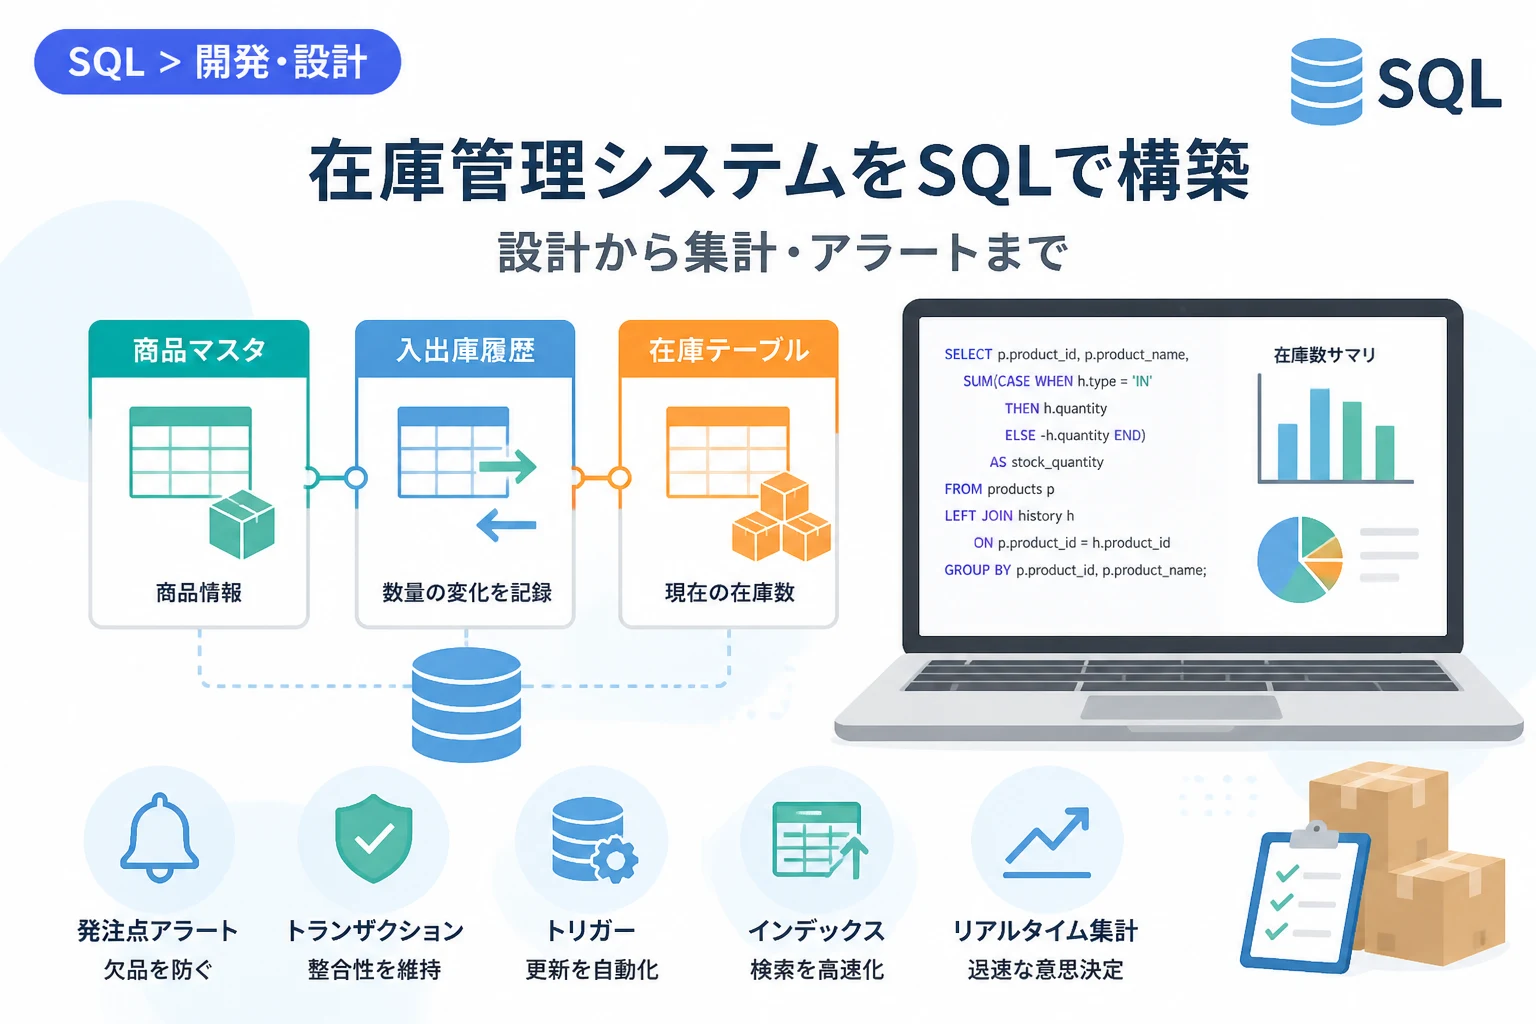
企業のビジネスにおいて、商品の在庫状況を正確に把握することは利益の最大化とコスト削減に直結する極めて重要な課題です。
多くの企業が表計算ソフトからの脱却を図り、リレーショナルデータベースを用いた堅牢な在庫管理システムの構築を検討しています。
本記事では、SQLを活用して効率的かつ正確な在庫管理システムを構築するための具体的な手順を詳しく解説します。
テーブル設計の基本から、実務で即座に役立つ集計クエリの作成方法までを網羅的に取り上げていきます。
在庫管理にSQLを導入するメリット
在庫管理にSQLを用いる最大のメリットは、データの整合性を高度に保てる点にあります。
表計算ソフトでは人為的なミスによってデータが破損するリスクがありますが、SQLベースのデータベースでは制約機能により不正な入力を防ぐことが可能です。
また、大量のデータに対しても高速な検索や集計が可能であり、リアルタイムでの在庫把握が容易になります。
複数のユーザーが同時にアクセスしてもデータが競合しにくい仕組みが備わっているため、チームでの運用にも適しています。
さらに、他の業務システムやECサイトとの連携がスムーズに行える点も、SQLを採用する大きな理由となります。
将来的な拡張性を考慮すると、SQLによる在庫管理は最も推奨される選択肢の一つと言えるでしょう。
効率的な在庫管理のためのテーブル設計
在庫管理システムを構築する際、最初に最も時間をかけるべきなのがテーブル設計です。
データがどのように関連し合うかを整理することで、複雑な集計もシンプルなSQLで記述できるようになります。
一般的に、在庫管理には「商品マスタ」「入出庫履歴」「倉庫・ロケーション」の3つの要素が必要です。
商品マスタテーブル (products)
商品マスタは、取り扱うすべての商品の基本情報を保持するテーブルです。
商品ID、商品名、カテゴリ、販売価格、仕入価格、そして「適正在庫数」などを定義します。
適正在庫数を設定しておくことで、在庫が不足した際に自動的に通知する仕組みを構築できます。
入出庫履歴テーブル (stock_transactions)
在庫管理において、現在の在庫数だけを保存する設計は推奨されません。
「いつ」「どの商品が」「いくつ」「どのような理由で」動いたのかをすべて記録する必要があります。
このテーブルには、取引ID、商品ID、取引タイプ (入荷・出荷・返品・棚卸など)、数量、日付を記録します。
履歴を残すことで、過去の在庫推移の分析や、不正な在庫操作の発見が可能になります。
在庫数管理テーブル (inventories)
各倉庫や拠点における現在の在庫数を保持するテーブルです。
商品IDと倉庫IDを組み合わせた主キーを設定し、現在の数量を管理します。
このテーブルは、入出庫履歴が発生するたびに値を更新するか、あるいは定期的に履歴テーブルから集計して更新する運用を行います。
SQLによるデータベース構築の実践
それでは、実際にSQLを使用してテーブルを作成してみましょう。
ここでは、代表的なRDBMS (MySQL, PostgreSQL, SQL Serverなど) で共通して利用できる標準的なSQL構文を使用します。
-- 商品マスタテーブルの作成
CREATE TABLE products (
    product_id INT PRIMARY KEY, -- 商品ID
    product_name VARCHAR(100) NOT NULL, -- 商品名
    category VARCHAR(50), -- カテゴリ
    standard_cost DECIMAL(10, 2), -- 標準仕入単価
    list_price DECIMAL(10, 2), -- 販売価格
    reorder_level INT -- 発注点 (この値を下回ったら発注)
);

-- 入出庫履歴テーブルの作成
CREATE TABLE stock_transactions (
    transaction_id INT AUTO_INCREMENT PRIMARY KEY, -- 取引ID
    product_id INT, -- 商品ID
    transaction_type ENUM('IN', 'OUT', 'ADJUST') NOT NULL, -- IN:入荷, OUT:出荷, ADJUST:調整
    quantity INT NOT NULL, -- 動いた数量
    transaction_date TIMESTAMP DEFAULT CURRENT_TIMESTAMP, -- 取引日時
    FOREIGN KEY (product_id) REFERENCES products(product_id)
);

-- 現在の在庫状況を保持するテーブル
CREATE TABLE inventories (
    product_id INT PRIMARY KEY,
    quantity_on_hand INT DEFAULT 0, -- 現在の手元在庫
    last_updated TIMESTAMP DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP,
    FOREIGN KEY (product_id) REFERENCES products(product_id)
);
上記のコードにより、基本的な在庫管理の基盤が整いました。
DECIMAL 型を使用しているのは、通貨や精密な数値を扱う際に浮動小数点数による誤差を避けるためです。
また、FOREIGN KEY (外部キー) を設定することで、存在しない商品の入庫を記録しようとした場合にエラーが発生するように制御しています。
データの挿入と初期化
テーブルが作成できたら、サンプルデータを挿入してみましょう。
まずは商品情報を登録し、その後に入庫処理をシミュレーションします。
-- 商品の登録
INSERT INTO products (product_id, product_name, category, standard_cost, list_price, reorder_level)
VALUES (1, '高性能ノートPC', '電子機器', 80000, 120000, 5);

INSERT INTO products (product_id, product_name, category, standard_cost, list_price, reorder_level)
VALUES (2, 'ワイヤレスマウス', '周辺機器', 1500, 3500, 20);

-- 初回入荷の記録 (100台入荷)
INSERT INTO stock_transactions (product_id, transaction_type, quantity)
VALUES (1, 'IN', 100);

-- 在庫テーブルの更新 (初回登録)
INSERT INTO inventories (product_id, quantity_on_hand)
VALUES (1, 100);
このように、履歴の作成と現在の在庫数の更新をセットで行うのが基本です。
在庫計算クエリの作成と活用
在庫管理システムの真価は、蓄積されたデータから必要な情報を素早く抽出することにあります。
特に重要なのは、現在の正確な在庫数と、補充が必要な商品の特定です。
現在の在庫数を算出するSQL
inventories テーブルを参照すれば現在の在庫は分かりますが、履歴テーブルから集計することで、データに矛盾がないかを確認できます。
-- 履歴から算出した現在在庫とマスタ情報の結合
SELECT
    p.product_name,
    SUM(CASE WHEN st.transaction_type = 'IN' THEN st.quantity
             WHEN st.transaction_type = 'OUT' THEN -st.quantity
             WHEN st.transaction_type = 'ADJUST' THEN st.quantity
             ELSE 0 END) AS calculated_stock
FROM
    products p
JOIN
    stock_transactions st ON p.product_id = st.product_id
GROUP BY
p.product_id, p.product_name;product_name | calculated_stock
------------------|-----------------
高性能ノートPC | 100
ワイヤレスマウス | 0このクエリでは、CASE 式を用いて入荷をプラス、出荷をマイナスとして集計しています。
これにより、常に履歴に基づいた「理論在庫」を算出することが可能です。
在庫不足を検知するアラートクエリ
実務で非常に役立つのが、あらかじめ設定した「発注点」を下回っている商品をリストアップするクエリです。
-- 在庫が発注点を下回っている商品の抽出
SELECT
    p.product_name,
    i.quantity_on_hand,
    p.reorder_level,
    (p.reorder_level - i.quantity_on_hand) AS shortage_quantity
FROM
    products p
JOIN
    inventories i ON p.product_id = i.product_id
WHERE
    i.quantity_on_hand <= p.reorder_level;
このクエリを定期的に実行することで、欠品による販売機会の損失を防ぐことができます。
「何個足りないか」という不足分 (shortage_quantity) も計算しているため、発注作業の効率化に繋がります。
データ整合性を保つための高度なテクニック
実運用では、不測の事態によってデータの整合性が失われることを防がなければなりません。
例えば、履歴テーブルには記録されたが、在庫数テーブルの更新に失敗したという状況は避けなければなりません。
トランザクション処理の重要性
複数の処理を「一つのまとまり」として扱うのがトランザクションです。
入庫処理を行う際は、履歴の挿入と現在の在庫数の更新を一つのトランザクションで行います。
START TRANSACTION;

-- 1. 履歴を挿入
INSERT INTO stock_transactions (product_id, transaction_type, quantity)
VALUES (1, 'OUT', 5);

-- 2. 在庫数をマイナス更新
UPDATE inventories
SET quantity_on_hand = quantity_on_hand - 5
WHERE product_id = 1;

COMMIT;もし2の更新処理でエラーが発生した場合、ROLLBACK を実行することで1の履歴挿入も取り消されます。
これにより、「出荷したことになっているのに在庫が減っていない」という矛盾を完全に防ぐことができます。
トリガー(Trigger)による自動更新
手動で2つのテーブルを更新するのが手間な場合、SQLの「トリガー」機能を使用すると便利です。
トリガーを設定すれば、履歴テーブルにデータが挿入された瞬間に、自動で在庫数テーブルを更新させることができます。
CREATE TRIGGER after_stock_transaction_insert
AFTER INSERT ON stock_transactions
FOR EACH ROW
BEGIN
    IF NEW.transaction_type = 'IN' THEN
        UPDATE inventories
        SET quantity_on_hand = quantity_on_hand + NEW.quantity
        WHERE product_id = NEW.product_id;
    ELSEIF NEW.transaction_type = 'OUT' THEN
        UPDATE inventories
        SET quantity_on_hand = quantity_on_hand - NEW.quantity
        WHERE product_id = NEW.product_id;
    END IF;
END;
この設定により、アプリケーション側から履歴を挿入するだけで、在庫数が常に最新の状態に保たれるようになります。
開発の工数を削減しつつ、更新漏れというヒューマンエラーを排除できる非常に強力な手法です。
パフォーマンスを最適化するインデックスの設計
データの件数が数万件、数十万件と増えてくると、集計クエリの動作が重くなることがあります。
これを解決するために、適切なカラムにインデックスを貼ることが重要です。
特に、外部キーとして頻繁に使用する product_id や、検索条件になりやすい transaction_date にはインデックスを検討しましょう。
-- 日付検索を高速化するインデックス
CREATE INDEX idx_transaction_date ON stock_transactions(transaction_date);

-- 商品ごとの集計を高速化するインデックス
CREATE INDEX idx_product_id ON stock_transactions(product_id);
インデックスを貼ることで、読み込み速度は劇的に向上しますが、書き込み時の負荷がわずかに増加します。
在庫管理システムにおいては、参照の頻度が非常に高いため、適切なインデックス設計は不可欠なステップです。
まとめ
SQLを用いた在庫管理システムの構築は、データの正確性と業務の効率化を両立させるための最良のアプローチです。
まずはシンプルな商品マスタと入出庫履歴の設計から始め、徐々にトランザクションやトリガーを活用して自動化を進めていきましょう。
正確なデータ設計は、単なる管理業務の枠を超え、将来的な需要予測や経営判断の材料としても価値を発揮します。
本記事で紹介したSQLクエリを参考に、自社の業務に最適な在庫管理システムを実現してください。
継続的な改善とデータの蓄積こそが、ビジネスの安定成長を支える基盤となります。