
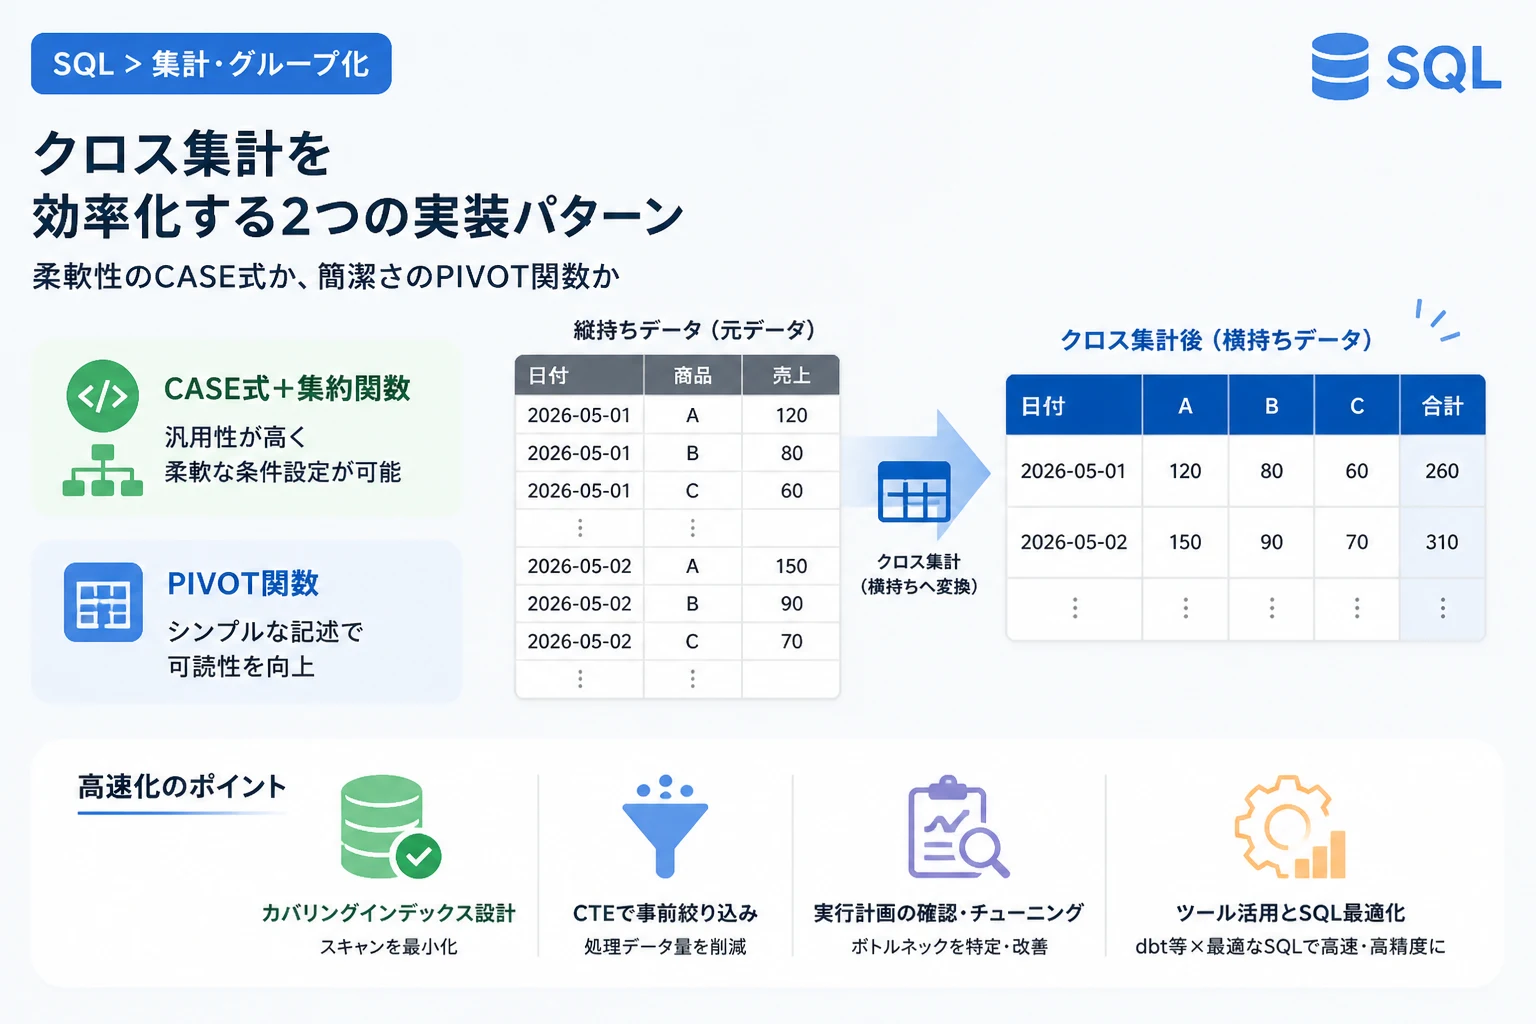
データ分析の現場において、縦方向に並んだレコードを横方向の表形式に変換する「クロス集計」は、最も頻繁に利用されるテクニックの一つです。
売上データの月別推移やアンケート結果の集計など、ビジネスレポートの作成には欠かせない処理と言えるでしょう。
SQLでクロス集計を実現する方法には、伝統的なCASE式を用いる手法から、データベース固有のPIVOT関数を利用する手法まで、複数のパターンが存在します。
本記事では、2026年現在の主要なデータベースにおける最新のトレンドを踏まえ、効率的なクロス集計の実装パターンと、パフォーマンスを最大化するための秘訣を詳しく解説します。
SQLにおけるクロス集計の重要性と基本概念
クロス集計とは、データベースに保存されている「行(レコード)」のデータを、特定のキーに基づいて「列(カラム)」へと展開し、行列形式で集計する処理を指します。
リレーショナルデータベースは通常、データを正規化して縦方向に長く保持する構造(縦持ち)を得意としています。
しかし、人間がデータを視覚的に理解したり、Excelなどの表計算ソフトで分析したりする際には、横方向に項目が並ぶ構造(横持ち)の方が適しています。
例えば、日次で蓄積された売上ログから「店舗ごとの月別売上合計」を算出する場合、月を列として展開することで、一目で推移を確認できるようになります。
このように、SQLでクロス集計を効率的に行えるかどうかは、データ分析のスピードと精度に直結する重要なスキルとなります。
近年では、BIツールの普及によりツール側でピボット処理を行うケースも増えていますが、大量のデータを扱う基盤層では、依然としてSQLによる前処理の最適化が求められています。
CASE式と集約関数を組み合わせた汎用的なクロス集計
SQLでクロス集計を行うための最も基本的かつ汎用的な手法が、「集約関数とCASE式の組み合わせ」です。
この手法は、標準SQLに準拠しているため、MySQL、PostgreSQL、SQL Server、Oracle、BigQuery、Snowflakeなど、ほぼすべての主要なデータベースエンジンで動作します。
CASE式の基本的な構文と仕組み
CASE式を用いたクロス集計の基本原理は、特定の条件に合致する場合のみ値を返し、それ以外は0やNULLを返すロジックを列ごとに作成することにあります。
まず、簡単な売上集計の例を見てみましょう。
-- CASE式を用いた月別売上集計の基本パターン
SELECT
    product_name AS "商品名",
    SUM(CASE WHEN sales_month = '2026-01' THEN amount ELSE 0 END) AS "1月売上",
    SUM(CASE WHEN sales_month = '2026-02' THEN amount ELSE 0 END) AS "2月売上",
    SUM(CASE WHEN sales_month = '2026-03' THEN amount ELSE 0 END) AS "3月売上"
FROM
    sales_records
GROUP BY
product_name;商品名 | 1月売上 | 2月売上 | 3月売上
---------+---------+---------+---------
ノートPC | 500000 | 450000 | 600000
マウス | 15000 | 12000 | 18000
モニタ | 120000 | 110000 | 150000このクエリでは、SUM関数の中にCASE式を記述することで、月ごとの値をフィルタリングしながら合算しています。
条件に合致しない場合に 0 を指定することで、合計値の計算に影響を与えずに特定の列へデータを振り分けています。
複数条件やNULL値を考慮した集計
実務では、単なる合計だけでなく、平均値の算出や、データが存在しない場合の処理も重要になります。
平均値を求める場合には、分母が 0 にならないよう、ELSE 句を省略して NULL を返すように設計するのが一般的です。
-- 平均値を求める際のCASE式の利用
SELECT
    category_id,
    AVG(CASE WHEN region = 'Tokyo' THEN price END) AS avg_tokyo_price,
    AVG(CASE WHEN region = 'Osaka' THEN price END) AS avg_osaka_price
FROM
    product_prices
GROUP BY
    category_id;
AVG などの集約関数は NULL を無視して計算するため、このように記述することで正確な平均値を算出できます。
CASE式による手法は、列の定義を柔軟にカスタマイズできる点が最大のメリットです。
PIVOT関数を利用した効率的なクロス集計
SQL ServerやOracleといった商用データベース、あるいはGoogle BigQueryやSnowflakeなどのモダンなデータウェアハウスでは、専用の PIVOT 句が用意されています。
PIVOT関数を使用すると、CASE式を羅列するよりも簡潔に、かつ直感的にクエリを記述することが可能です。
SQL ServerやOracleでの実装例
PIVOT関数を使用する場合、どの列を行見出しにし、どの列の値を集計し、どの列の値を新しい列名にするかを指定します。
-- PIVOT関数を用いた売上集計(SQL Server / Oracle / BigQuery等)
SELECT *
FROM (
    SELECT product_name, sales_month, amount
    FROM sales_records
) AS source_table
PIVOT (
    SUM(amount)
    FOR sales_month IN ('2026-01', '2026-02', '2026-03')
) AS pivot_table;product_name | 2026-01 | 2026-02 | 2026-03
-------------+---------+---------+---------
ノートPC | 500000 | 450000 | 600000
マウス | 15000 | 12000 | 18000
モニタ | 120000 | 110000 | 150000PIVOT関数を使用することで、CASE式を何度も書く手間が省け、クエリ全体の可読性が大幅に向上します。
特に集計対象の列(上記の例では sales_month の値)が多い場合、コードの記述量を劇的に削減できるでしょう。
PIVOT関数のメリットと制限事項
PIVOT関数の利点は、コードが宣言的であり、意図が明確に伝わることです。
一方で、いくつかの制限事項も存在します。
まず、PIVOT関数の IN 句に指定する値は、通常は静的に記述する必要があるという点です。
動的に増え続ける月や商品名を自動的に列として展開するには、動的SQL(ダイナミックSQL)を組み合わせてクエリを組み立てる必要があります。
また、データベース製品によってPIVOTの構文が微妙に異なるため、移植性が低いというデメリットもあります。
実務で役立つ!CASE式とPIVOT関数の使い分け
どちらの手法を選択すべきかは、プロジェクトの要件や使用しているデータベースの特性によって決まります。
ここでは、判断基準となるポイントを整理します。
可読性と保守性の観点
単純な集計項目を展開するだけであれば、PIVOT関数の方がスマートです。
しかし、「1月と2月の合計を別の列で出したい」あるいは「特定の条件では重み付けを変えたい」といった複雑なロジックが絡む場合は、CASE式の方が柔軟に対応できます。
CASE式は、各列に対して個別の条件を詳細に設定できるため、ビジネスロジックが複雑な集計に適しています。
対応するデータベースエンジンの違い
以下の表に、主要なデータベースごとの対応状況をまとめました。
| データベース名 | CASE式によるクロス集計 | PIVOT関数のサポート |
|---|---|---|
| MySQL | 対応 | 非対応 |
| PostgreSQL | 対応 | 非対応(FILTER句やCROSSTAB関数で代用) |
| SQL Server | 対応 | 対応 |
| Oracle | 対応 | 対応 |
| BigQuery | 対応 | 対応 |
| Snowflake | 対応 | 対応 |
MySQLやPostgreSQLを中心に使用している環境では、CASE式を用いた実装がデファクトスタンダードとなります。
PostgreSQLには tablefunc モジュールの CROSSTAB 関数もありますが、設定が煩雑なため、CASE式が選ばれることが多いです。
クロス集計を高速化するためのパフォーマンスチューニング
数百万件、数千万件という膨大なデータをクロス集計する場合、単純なクエリでは処理時間が大幅に増大する可能性があります。
クロス集計を高速化するための具体的なテクニックを紹介します。
インデックス設計の最適化
クロス集計のパフォーマンスを左右する最大の要因は、データのスキャン範囲をいかに絞り込めるかです。
GROUP BYに使用する列と、集計に使用する列を含んだ「カバリングインデックス」を作成することが極めて有効です。
例えば、先ほどの売上集計の例であれば、(product_name, sales_month, amount) の複合インデックスを作成することで、ベーステーブルへのアクセスを回避し、インデックスのみで集計を完結させることが可能になります。
サブクエリとCTE(共通テーブル式)の活用
巨大なテーブルに対して直接クロス集計を行うのではなく、まずは WITH 句(CTE)を使用して、必要な範囲のデータだけを絞り込むのが定石です。
-- CTEを使用して集計対象を絞り込んでからクロス集計を行う
WITH filtered_sales AS (
    SELECT
        product_name,
        sales_month,
        amount
    FROM
        sales_records
    WHERE
        sales_date >= '2026-01-01'
        AND sales_date < '2026-04-01'
)
SELECT
    product_name,
    SUM(CASE WHEN sales_month = '2026-01' THEN amount ELSE 0 END) AS jan,
    SUM(CASE WHEN sales_month = '2026-02' THEN amount ELSE 0 END) AS feb,
    SUM(CASE WHEN sales_month = '2026-03' THEN amount ELSE 0 END) AS mar
FROM
    filtered_sales
GROUP BY
    product_name;
このように、一旦中間テーブルのような形でデータを切り出すことで、データベースエンジンはより効率的な実行計画を立てやすくなります。
実行計画の確認ポイント
クエリの低速化が疑われる場合は、必ず EXPLAIN 命令を使用して実行計画を確認しましょう。
特に、「Sort」や「HashAggregate」にかかっているコストが高い場合、メモリ不足によるディスクI/Oが発生している可能性があります。
この場合、作業メモリ(work_memなど)の調整や、集計キーのカーディナリティ(値の種類数)を見直すことが改善への近道となります。
動的なクロス集計の実装アプローチ
実務で頻繁に遭遇する課題の一つが、「列の数が事前に決まっていない」という状況です。
例えば、「過去12ヶ月分」の売上を集計する場合、月が変わるたびにクエリを書き換えるのは現実的ではありません。
ストアドプロシージャによる動的SQLの生成
これを解決するためには、プログラム側でSQLを組み立てるか、データベース側で動的SQLを実行する仕組みを利用します。
以下は、ストアドプロシージャ内で実行すべきクエリを動的に組み立てるイメージです。
-- 動的SQLを用いたクロス集計の概念(PostgreSQL/PL/pgSQL風)
DO $$
DECLARE
    months TEXT;
    query TEXT;
BEGIN
    -- 集計対象の月を動的に取得し、CASE式のリストを作成する
    SELECT STRING_AGG(
        FORMAT('SUM(CASE WHEN sales_month = %L THEN amount ELSE 0 END) AS %I', m, 'month_' || m),
        ', '
    ) INTO months
    FROM (SELECT DISTINCT sales_month FROM sales_records ORDER BY sales_month) AS sub;

    -- 最終的なクエリを組み立てる
    query := 'SELECT product_name, ' || months || ' FROM sales_records GROUP BY product_name';

    -- クエリを実行(実際にはカーソルや一時テーブルを使用)
    EXECUTE query;
END $$;
動的SQLは非常に強力ですが、SQLインジェクションのリスクやデバッグの難易度が高まる点に注意が必要です。
2026年のモダンな開発環境では、dbt(data build tool)などのデータ変換フレームワークを利用して、コンパイル時にSQLを生成する手法も広く採用されています。
2026年におけるクロス集計の最適解
近年、クラウド型データウェアハウスの進化により、以前よりもはるかに大規模なデータのクロス集計が高速化されました。
しかし、基礎となる「いかにスキャン量を減らすか」「いかに効率的な型で集計するか」という原則は変わりません。
特にSnowflakeやBigQueryのような列指向ストレージでは、クロス集計で生成される「多数の列」に対するスキャン効率が向上していますが、それでも無駄な列の生成は避けるべきです。
また、マテリアライズドビュー(Materialized View)を事前作成しておくことで、リアルタイム性を損なわずにクロス集計結果を高速に取得する手法も一般化しています。
クロス集計は単なる表示形式の変更ではなく、「データの価値を最大化するための変換処理」として捉え、システム全体の負荷を考慮した実装を選択することが重要です。
まとめ
SQLでのクロス集計は、CASE式と集約関数を用いた汎用的な手法と、PIVOT関数による効率的な手法の二つが主流です。
あらゆるデータベース環境で動作し、柔軟なカスタマイズが可能なCASE式は、エンジニアが必ず習得しておくべき必須のスキルと言えます。
一方で、特定のプラットフォームに最適化されたPIVOT関数は、クエリを簡潔にし、メンテナンス性を向上させる強力な武器となります。
パフォーマンスを最適化するためには、インデックスの適切な設計や、CTEによるデータの事前絞り込みが欠かせません。
データの規模や更新頻度、利用するデータベース製品の特性を見極め、状況に応じた最適な実装パターンを選択してください。
本記事で紹介したテクニックを活用し、高速で堅牢なデータ分析基盤の構築に役立てていただければ幸いです。