
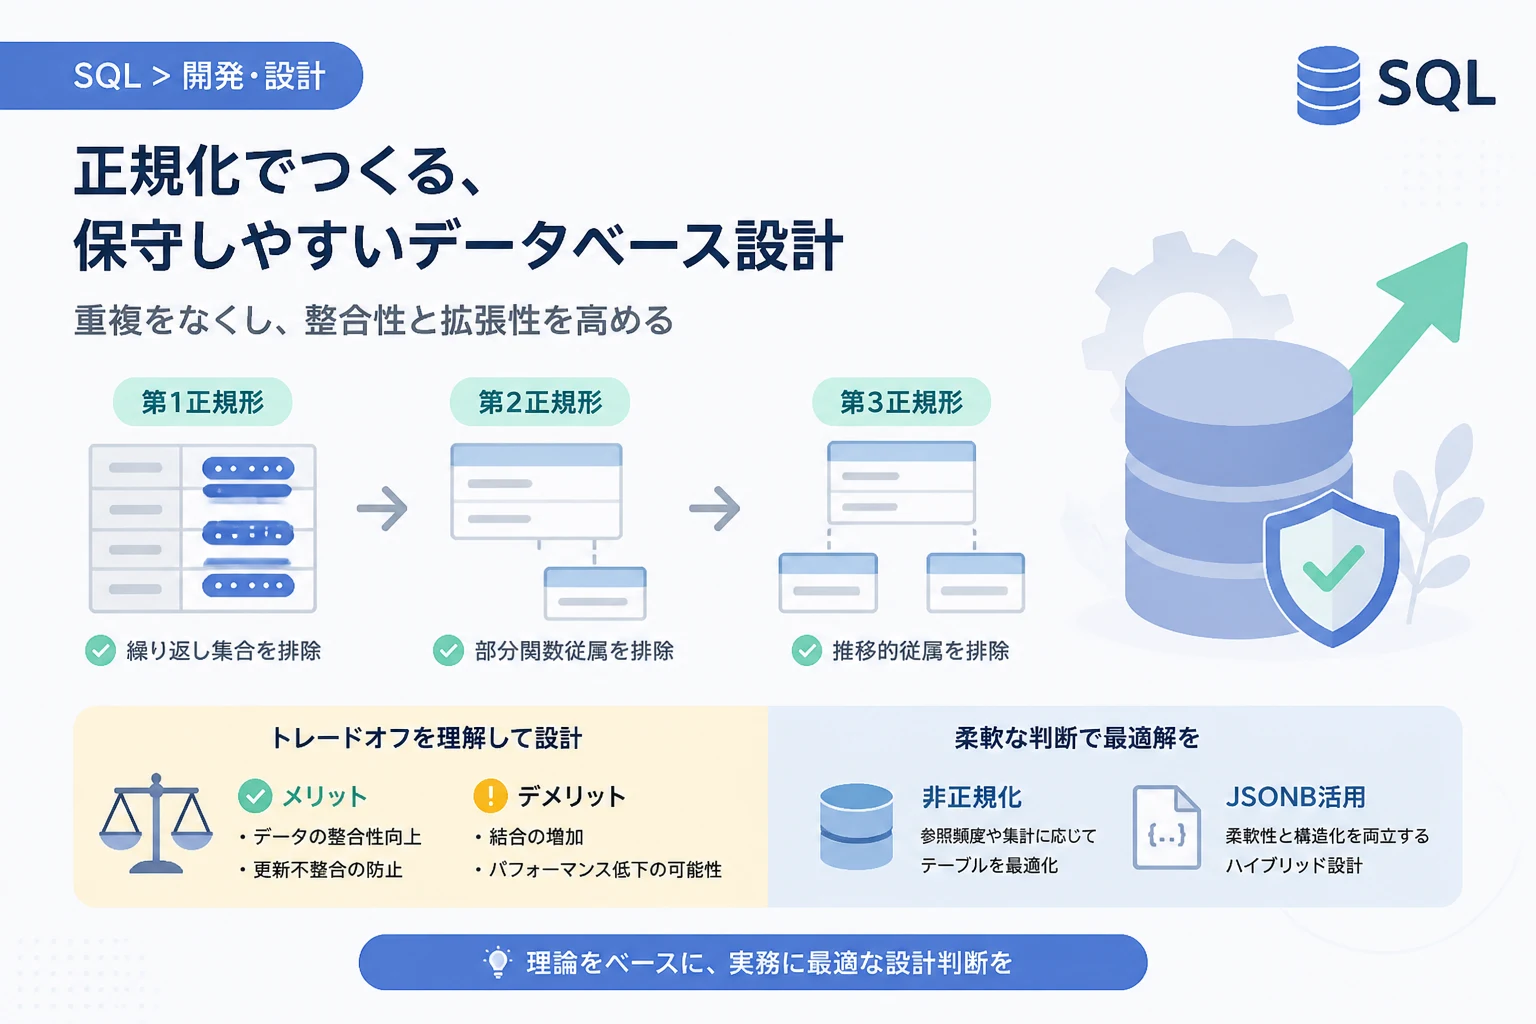
データベース設計において、データの整合性を保ち、将来的な仕様変更に耐えうる「保守性」を確保することは、エンジニアにとって永遠の課題です。
特に、アプリケーションの規模が拡大し、データ量が増大し続ける現代のシステム開発では、初期段階でのデータベース設計の成否が、その後の運用コストに決定的な影響を与えます。
その中核となる技術がSQLの正規化です。
正規化は単なる理論上の形式美ではなく、データの重複を排除し、更新不整合(アノマリー)を防ぐための実戦的な手法です。
本記事では、正規化の基本手順から、実務において重要となる「どこまで正規化すべきか」という判断基準までを、2026年現在のシステム開発事情を背景に詳しく解説します。
データベース正規化の目的と重要性
正規化とは、リレーショナルデータベース(RDBMS)の設計において、データの重複を最小限に抑え、論理的な整合性を維持するためにテーブル構造を整理するプロセスのことです。
なぜ、これほどまでに正規化が重視されるのでしょうか。
その主な理由は以下の3点に集約されます。
データの整合性の維持
同じデータが複数の箇所に存在すると、一方を更新した際にもう一方を更新し忘れるというリスクが生じます。
これを更新不整合と呼びます。
正規化によって「一つの事実は一つの場所に(One Fact in One Place)」という原則を徹底することで、データの矛盾を根本から防ぐことができます。
ストレージ容量の効率化
重複するデータを排除することで、物理的なストレージ使用量を削減できます。
現代ではクラウドストレージのコストは低下していますが、それでもテラバイト単位、ペタバイト単位のデータを扱うシステムでは、無視できないコスト削減効果があります。
また、データ量の削減はバックアップやリカバリの高速化にも寄与します。
保守性と拡張性の向上
正規化されたテーブル構造は、各テーブルの役割が明確であるため、新しい機能を追加する際のインパクト分析が容易になります。
例えば、顧客情報の仕様が変更された際、customers テーブルのみを修正すれば済む構造になっていれば、システム全体の改修コストを大幅に抑えることが可能です。
正規化の手順:第1正規形から第3正規形まで
実務において、ほとんどのケースでは第3正規形(3NF)までを適用することが標準とされています。
ここでは、具体的な注文管理システムのデータを例に、各ステップを追っていきましょう。
非正規形(Unnormalized Form)の例
まず、正規化が行われていない状態のテーブルを想定します。
一見、スプレッドシートのように見やすく感じますが、データベースとしては非常に扱いづらい構造です。
| 注文番号 | 注文日 | 顧客名 | 顧客住所 | 商品名(個数) | 合計金額 |
|---|---|---|---|---|---|
| 101 | 2026-05-01 | 田中 太郎 | 東京都渋谷区 | PC(1), マウス(2) | 160,000 |
| 102 | 2026-05-02 | 佐藤 次郎 | 大阪府大阪市 | キーボード(1) | 12,000 |
この状態では、一つのセルに複数の商品情報が含まれており(繰り返し集合)、SQLでの検索や集計が極めて困難です。
第1正規形(1NF):原子値への分解
第1正規形では、すべての列が単一の値(原子値)を持つように構成します。
具体的には、繰り返し集合を排除し、行を分離します。
第1正規形を適用したテーブル構造
-- 第1正規形のテーブル例
CREATE TABLE orders_1nf (
    order_id INT,           -- 注文番号
    order_date DATE,        -- 注文日
    customer_name TEXT,     -- 顧客名
    customer_address TEXT,  -- 顧客住所
    product_name TEXT,      -- 商品名
    quantity INT,           -- 個数
    unit_price INT,         -- 単価
    PRIMARY KEY (order_id, product_name) -- 複合主キー
);
第1正規形にすることで、特定の商品の売上を SUM() 関数などで簡単に集計できるようになります。
しかし、この状態では「注文番号」と「商品名」が重複しており、まだ不十分です。
第2正規形(2NF):部分関数従属の排除
第2正規形では、第1正規形を満たした上で、主キーの一部にのみ従属する列(部分関数従属)を別テーブルに切り出します。
上記の orders_1nf では、主キーが (order_id, product_name) の複合キーとなっています。
order_date,customer_name,customer_addressはorder_idだけが決まれば確定します。unit_priceはproduct_nameだけが決まれば確定します。
これらを分離します。
第2正規形適用後の構成
注文テーブル
- 注文番号(PK)
- 注文日
- 顧客名
- 顧客住所
注文明細テーブル
- 注文番号(PK, FK)
- 商品名(PK)
- 個数
商品マスタ
- 商品名(PK)
- 単価
これにより、商品の単価が変更された際も、商品マスタの1レコードを更新するだけで済むようになります。
第3正規形(3NF):推移的関数従属の排除
第3正規形では、第2正規形を満たした上で、主キー以外の列の間にある依存関係(推移的関数従属)を排除します。
注文テーブルを見てみると、order_id(主キー)によって customer_name が決まり、その customer_name によって customer_address が決まるという関係があります。
これを分離し、「顧客」を独立した実体(エンティティ)として扱います。
第3正規形適用後のテーブル定義例
-- 顧客マスタ
CREATE TABLE customers (
    customer_id SERIAL PRIMARY KEY,
    customer_name VARCHAR(100) NOT NULL,
    customer_address TEXT
);

-- 商品マスタ
CREATE TABLE products (
    product_id SERIAL PRIMARY KEY,
    product_name VARCHAR(100) NOT NULL,
    unit_price INT NOT NULL
);

-- 注文ヘッダ
CREATE TABLE orders (
    order_id SERIAL PRIMARY KEY,
    customer_id INT REFERENCES customers(customer_id),
    order_date DATE NOT NULL
);

-- 注文明細
CREATE TABLE order_details (
    order_id INT REFERENCES orders(order_id),
    product_id INT REFERENCES products(product_id),
    quantity INT NOT NULL,
    PRIMARY KEY (order_id, product_id)
);これで、データの重複がほぼなくなり、整合性が極めて高い構造になりました。
顧客が住所を変更しても、過去の注文履歴に影響を与えることなく、マスタ情報だけを更新すれば良くなります。
実務における判断基準:いつ正規化を止めるべきか
理論上は第3正規形、あるいはそれ以上のボイス・コッド正規形(BCNF)などを目指すのが理想ですが、実務では「過度な正規化」がパフォーマンスを低下させる場面があります。
結合(JOIN)のコストとパフォーマンス
正規化が進むほどテーブル数は増え、データを取得する際に必要な JOIN の回数が増加します。
2026年現在のDBエンジンやハードウェアの性能向上は著しいものの、数千万件、数億件のデータに対して大規模な複数テーブル結合を行うと、レスポンス速度が許容範囲を超えることがあります。
非正規化(逆正規化)を検討するケース
以下のような条件下では、あえて正規化を崩す(非正規化)という選択肢が検討されます。
- 参照頻度が極めて高い: eコマースのトップ画面などで、特定の情報を表示するために毎回5つ以上のテーブルをJOINしている場合。
- データ更新がほとんど発生しない: ログデータや過去のアーカイブデータなど、後から修正されないことが確定しているデータ。
- 複雑な集計が必要な場合: リアルタイムでの集計が求められるダッシュボードなどでは、あえて合計値を計算済みのカラムとして保持することがあります。
非正規化を行う際の注意点
非正規化はあくまで「パフォーマンスのための苦肉の策」であることを忘れてはいけません。
「正規化された設計をベースにし、必要に応じてピンポイントで崩す」のが正しい手順です。
最初から非正規な設計に逃げるのは、保守性の欠如を招く非常に危険な行為です。
非正規化を採用する場合は、以下の対策を講じることが推奨されます。
- トリガーを使用して、元のデータが更新された際に非正規化されたカラムも自動で更新する。
- アプリケーション側のトランザクション管理で整合性を保証する。
現代的なアプローチ:JSON型とハイブリッド設計
2026年のSQL界隈では、PostgreSQLなどの主要なRDBMSが高度なJSONB型をサポートしています。
これにより、すべてのデータをリレーショナルに正規化するのではなく、一部の非定型なデータをJSON形式で保持する「ハイブリッド設計」が普及しています。
JSONBを活用すべきシーン
- スキーマレスな特性が必要な属性: 例えば、商品の「スペック」情報など、商品カテゴリごとに項目が全く異なる場合。
- 頻繁にスキーマが変更される初期開発フェーズ: 第1正規形に厳格に従うと、カラム追加のたびにマイグレーションが必要ですが、JSONなら柔軟に対応可能です。
ただし、「検索のキーになるカラム」や「外部キー制約が必要なカラム」は、必ず正規化して独立したカラムとして定義すべきです。
JSON内に埋め込まれたデータへのインデックス作成も可能ですが、結合の効率や整合性チェックの面ではリレーショナルな設計に劣ります。
正規化を実践するためのSQLチェックリスト
正規化を行う際、設計段階で以下のポイントをセルフチェックすることをお勧めします。
- 一意性の確保: すべてのテーブルに適切な主キー(PK)が定義されているか。
- 重複の排除: 同じ意味を持つデータが、異なる複数のテーブルに散らばっていないか。
- NULLの回避: 正規化が不十分なために、特定の行で大量の
NULLが発生していないか(これはテーブル分離のサインです)。 - 型の一貫性: 外部キー(FK)として参照するカラムのデータ型が、参照元と完全に一致しているか。
以下は、正規化が不適切な場合に発生しやすい問題を確認するためのクエリ例です。
特定のカラムの組み合わせでデータが重複しているかを確認します。
-- 重複データの検出(例:顧客名と住所の組み合わせが不自然に重複していないか)
SELECT customer_name, customer_address, COUNT(*)
FROM orders_1nf
GROUP BY customer_name, customer_address
HAVING COUNT(*) > 1;
このようなクエリを実行して、想定外の重複が見つかる場合は、設計を第2正規形、第3正規形へと進める必要があるというシグナルになります。
まとめ
SQLの正規化は、単にデータを整理する作業ではありません。
システムの「寿命」を延ばし、開発チームの生産性を維持するための戦略的な投資です。
本記事で解説した手順を振り返ります。
- 第1正規形: 繰り返しをなくし、最小単位にする。
- 第2正規形: 主キーの一部に従属するデータを切り出す。
- 第3正規形: 項目間の依存関係(推移的従属)を排除する。
理論に忠実な設計は、変更に強く、データの汚れを防ぎます。
一方で、実務においては、パフォーマンス要件やデータの特性(JSONBの活用など)に応じて、柔軟に判断を下す力も求められます。
まずは「常に第3正規形を目指す」ことから始め、そこからボトルネックとなる箇所を特定していくという王道のアプローチを徹底しましょう。
それが、2026年以降も価値を持ち続ける堅牢なシステムを構築するための第一歩となります。