
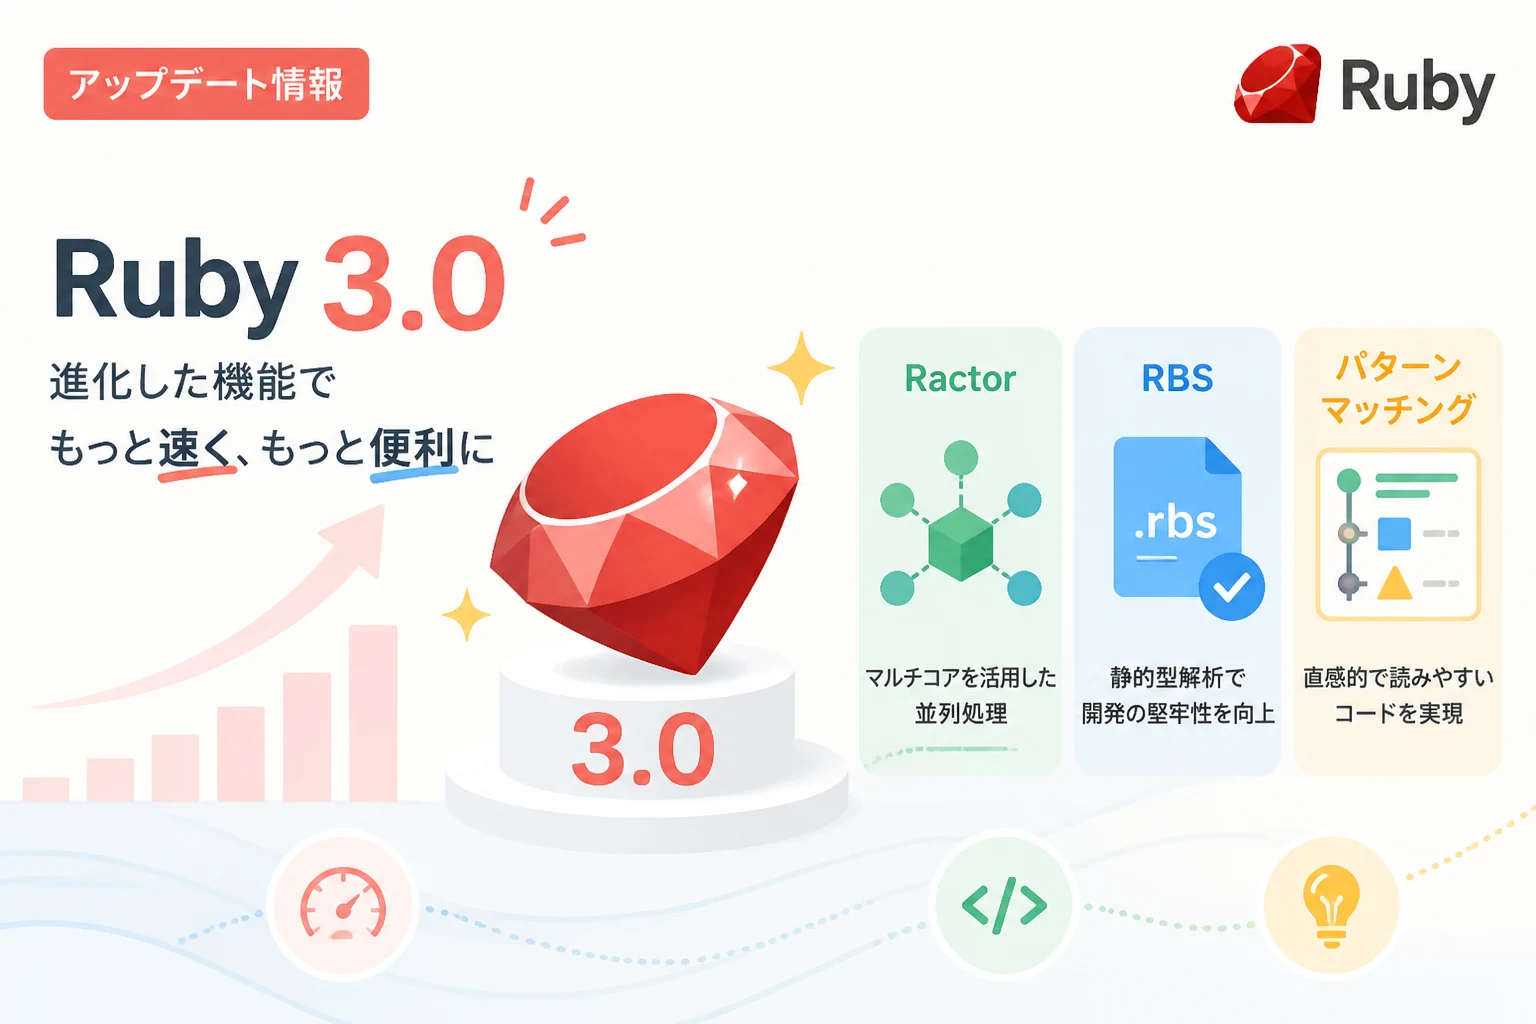
Rubyは1995年の誕生以来、プログラミングの楽しさと生産性の向上を追求し続けてきました。
その歴史において最大の転換点となったのが、2020年12月にリリースされたRuby 3.0です。
開発から数年が経過した2026年現在においても、Ruby 3.0で導入された主要な機能は、Rubyエコシステムの基盤として揺るぎない地位を築いています。
本記事では、Ruby 3.0が掲げた「Ruby 3×3」という野心的な目標の達成状況を振り返りながら、Ractor、RBS、パターンマッチングといった革新的な機能が現在の開発現場にどのような変化をもたらしたのかを詳しく解説します。
Ruby 3.0の核心:Ruby 3×3の達成とパフォーマンスの進化
Ruby 3.0の最大のテーマは、まつもとゆきひろ氏が提唱した「Ruby 3×3 (Ruby 3 times 3)」でした。
これはRuby 2.0と比較して実行速度を3倍にするという宣言であり、多くの開発者がその実現を待ち望んでいました。
MJITによる実行速度の向上
Ruby 3.0では、Ruby 2.6から導入されていたMJIT (Method-based Just-In-Time compiler) が大幅に改善されました。
MJITは、頻繁に呼び出されるRubyメソッドをC言語のコードに変換し、それをコンパイルして機械語として実行する仕組みです。
これにより、数値計算などの特定の処理において劇的な高速化が実現されました。
2026年現在の視点で見れば、MJITはその後登場するRJITやYJITへの重要な布石であったことがわかります。
Ruby 3.0時点でのMJITは、Railsのような大規模なWebアプリケーションにおいて劇的な速度向上をもたらすには至りませんでしたが、Rubyが「遅い」という評価を払拭するための大きな一歩となったことは間違いありません。
メモリ管理とガベージコレクションの最適化
パフォーマンス向上は単なる実行速度だけでなく、メモリ管理の効率化も含まれていました。
Ruby 3.0では、ヒープの断片化を抑制する仕組みや、ガベージコレクション (GC) の効率化が進められました。
これにより、長時間稼働するサーバーアプリケーションにおいて、メモリ使用量の安定性が向上しました。
Ractor:Rubyにおける真の並列処理の幕開け
Ruby 3.0で最も注目を集めた新機能の一つがRactor (Ruby Actor)です。
これまでRubyには、スレッドを並列に実行することを制限するGVL (Global VM Lock) が存在していました。
Ractorはこの制限を打破し、マルチコアプロセッサの性能をフルに活用するための実験的機能として導入されました。
GVLの壁を越える仕組み
従来のRubyのスレッドは、複数のスレッドを作成しても、ある時点では1つのスレッドしかRubyコードを実行できませんでした。
これを解決するために導入されたRactorは、各Ractorが独立したGVLを持つという構造を採用しています。
Ractor間でオブジェクトを共有するには厳格な制限があり、基本的にはコピーまたは移動によってデータをやり取りします。
これにより、マルチスレッドプログラミングで常に懸念される「データ競合」を言語レベルで防止しています。
Ractorの基本的なコード例
以下のコードは、2つのRactorを使用して並列計算を行う簡単な例です。
# 2つのRactorを生成して並列に計算を行う
r1 = Ractor.new do
  # 重い計算をシミュレート
  sleep(1)
  42
end

r2 = Ractor.new do
  # 重い計算をシミュレート
  sleep(1)
  100
end

# それぞれのRactorから結果を受け取る
# メインスレッドはブロックされず、並列に処理が進む
results = [r1.take, r2.take]
p results[42, 100]2026年におけるRactorの立ち位置
Ruby 3.0リリース直後は「実験的」という位置づけでしたが、2026年現在では多くのライブラリがRactorに対応し、CPUバウンドな処理を効率化するための標準的な手段となっています。
特にデータ解析や画像処理などの分野で、Rubyの活用範囲を大きく広げる役割を果たしました。
RBS:静的型解析による堅牢な開発
動的型付け言語であるRubyに、型定義の概念を持ち込んだのがRBSです。
Ruby 3.0では、Rubyプログラム自体の文法を変えることなく、外部ファイルとして型定義を記述する方式が採用されました。
RBSを導入するメリット
RBSを使用することで、開発者はコードの実行前に型の不整合を見つけることができます。
これは、大規模な開発プロジェクトにおいて以下のようなメリットをもたらします。
- ドキュメントとしての役割:メソッドの引数や戻り値の型が明示されるため、コードの可読性が向上します。
- IDEサポートの強化:エディタの補完機能やリファクタリングがより正確になります。
- 早期のバグ発見:実行時のエラー (NoMethodErrorなど) を未然に防ぐことができます。
RBSの定義例
RBSは .rbs という拡張子のファイルに記述します。
例えば、ユーザー情報を扱うクラスの型定義は以下のようになります。
# user.rbs
class User
  attr_reader name: String
  attr_reader age: Integer

  def initialize: (name: String, age: Integer) -> void
  def adult?: () -> bool
endこのように、Rubyの本体コードと型定義を分離することで、Ruby特有の柔軟性を損なうことなく型安全性を高めることが可能になりました。
現在では、SteepやTypeProfといったツールと組み合わせて使用されるのが一般的です。
パターンマッチング:複雑なデータ構造の簡潔な処理
Ruby 2.7で試験的に導入されたパターンマッチングは、Ruby 3.0で正式な機能となりました。
これにより、JSONデータや入れ子になった配列、ハッシュなどの複雑な構造を持つデータを、驚くほど簡潔に記述できるようになりました。
case…inによる強力な分岐
従来の case...when 文とは異なり、case...in 文はデータの構造そのものをチェックし、同時に変数への代入 (デコンストラクション) を行います。
# 複雑なハッシュデータの処理例
user_data = { name: "Alice", age: 30, roles: ["admin", "editor"] }

case user_data
in { name: String => name, age: 20..40, roles: ["admin", *others] }
  puts "#{name}さんは管理者権限を持っています。他のロール: #{others.join(', ')}"
else
  puts "条件に一致しませんでした。"
endAliceさんは管理者権限を持っています。他のロール: editorパターンマッチングの応用範囲
パターンマッチングは、APIから取得したデータのパースや、条件の多いビジネスロジックの整理に非常に有効です。
コードの行数を減らすだけでなく、意図が明確なコードを書くことができるため、現代のRuby開発において欠かせない手法となっています。
Ruby 3.0以降、右代入演算子 (=>) を用いた1行パターンマッチも導入され、活用の幅はさらに広がりました。
開発体験を向上させる細かな改善点
Ruby 3.0には、大きな新機能以外にも、開発者の日常的な不満を解消する多くの改善が含まれています。
引数の分離:キーワード引数と位置引数
Ruby 3.0における最も大きな破壊的変更の一つが、キーワード引数と位置引数の完全な分離です。
Ruby 2.xまでは、ハッシュをキーワード引数として渡すなどの曖昧な挙動が許容されていましたが、3.0からは厳格に区別されるようになりました。
これにより、メソッドの呼び出しがより明快になり、意図しない挙動によるバグの混入を防ぐことができるようになりました。
移行期には多くの開発者が警告への対応に追われましたが、2026年現在ではこのクリーンな仕様がRubyの信頼性を支えています。
エンドレスメソッド定義 (End-less method definition)
1行で済むような単純なメソッドを簡潔に定義できる新しい構文が導入されました。
# 従来の定義
def square(x)
  x * x
end

# エンドレスメソッド定義
def square(x) = x * x

puts square(5)25冗長な end を省略できるため、関数型のプログラミングスタイルを好む開発者や、シンプルな計算メソッドを多数定義する場合に好まれています。
| 機能名 | 概要 | 主なメリット |
|---|---|---|
| Ractor | 並列処理モデル | マルチコアCPUの有効活用 |
| RBS | 型定義ファイル | 静的解析による品質向上 |
| Pattern Matching | 構造化データの抽出 | コードの簡潔化と可読性向上 |
| Keyword Arguments | 引数仕様の整理 | 意図しないバグの防止 |
| MJIT | JITコンパイラ | 特定の処理の高速化 |
2026年の視点から見るRuby 3.0の遺産
Ruby 3.0がリリースされた当時、その目標の高さから「本当に実現できるのか」という声もありました。
しかし、2026年を迎えた今、私たちはRuby 3.0が単なる高速化のバージョンではなく、Rubyがエンタープライズ領域や高度な並列処理が必要な領域でも十分に戦えることを証明した歴史的なマイルストーンであったことを確信しています。
エコシステムの成熟
RBSの登場により、大規模なRailsアプリケーションでも型安全なリファクタリングが一般的になりました。
また、Ractorの安定化により、非同期IOだけでなく、CPUリソースを大量に消費するタスクもRubyで完結させる事例が増えています。
継承される進化
Ruby 3.0で導入された基礎は、その後の3.1から3.5に至るアップデートでさらに洗練されました。
YJITによる飛躍的なパフォーマンス向上や、より直感的なパターンマッチングの拡張などは、すべてRuby 3.0という強固な土台があったからこそ実現できたものです。
まとめ
Ruby 3.0は、パフォーマンス、並列性、型安全性という3つの大きな柱を掲げ、Rubyという言語を次の次元へと引き上げました。
Ractorによる真の並列処理、RBSによる静的型解析、そしてパターンマッチングによる直感的な記述は、今やRubyエンジニアにとって標準的な武器となっています。
2026年の開発環境においても、これらの機能は色褪せることなく、むしろその重要性を増しています。
Ruby 3.0の新機能を深く理解し、適切に活用することは、高品質でメンテナンス性の高いアプリケーションを構築するための第一歩です。
もしいまだに古いスタイルの記述に留まっている部分があれば、ぜひRuby 3.0から始まった「モダンRuby」の力を積極的に取り入れてみてください。
Rubyはこれからも、書きやすさと楽しさを維持しながら、進化を続けていくことでしょう。
その進化の出発点として、Ruby 3.0が果たした役割は極めて大きいのです。