
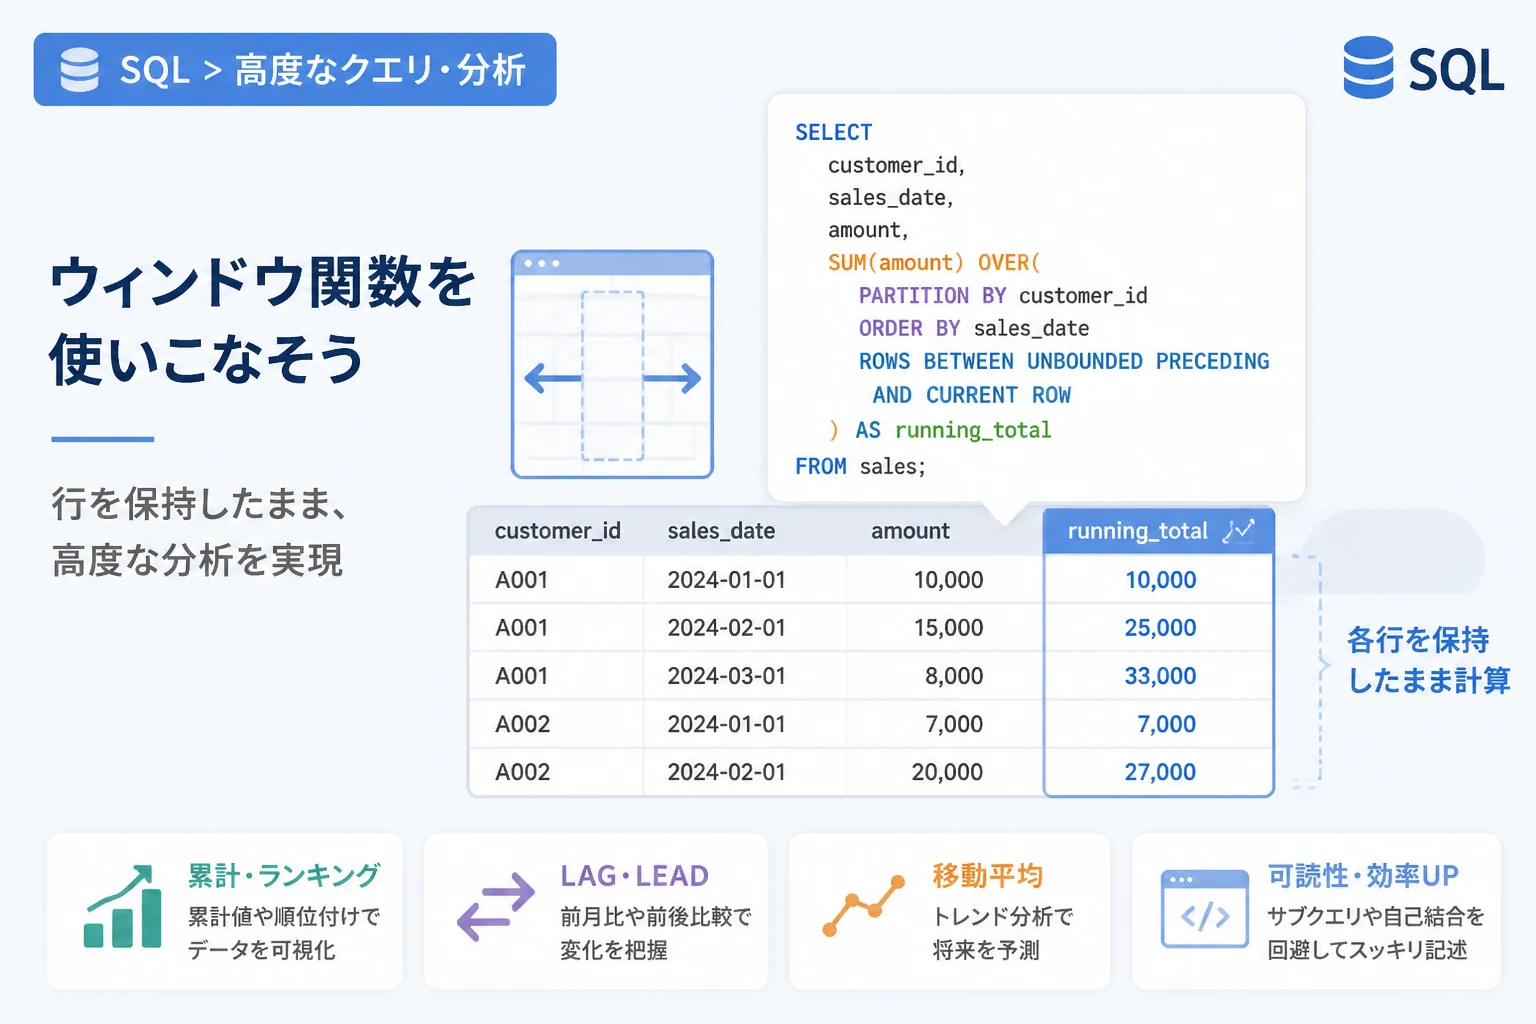
SQLを用いたデータ分析の現場において、多くのエンジニアやデータアナリストが直面する課題の一つに「行をまたいだ計算」があります。
従来のGROUP BY句では行が集約されてしまい、詳細なデータを保持したまま計算を行うことが困難でした。
この問題をスマートに解決し、SQLの表現力を飛躍的に高めてくれるのが「ウィンドウ関数」です。
本記事では、ウィンドウ関数の基礎概念から実務で即戦力となる活用パターンまでを詳しく解説します。
SQLウィンドウ関数とは?
SQLウィンドウ関数(Window Functions)は、結果セットを「ウィンドウ」と呼ばれる特定の範囲に分割し、その範囲内で計算を行う機能です。
最大の特徴は、「各行の情報を維持したまま、他の行との比較や計算ができる」という点にあります。
集約関数との違い
ウィンドウ関数を理解する上で最も重要なのは、一般的な集約関数(GROUP BY)との違いを明確にすることです。
通常の集約関数では、指定したカラムに基づいてデータがまとめられ、元の行数は減少します。
例えば、部署ごとの平均給与を出す場合、結果は部署の数と同じ行数になります。
一方で、ウィンドウ関数を使用すると、個々の社員のデータ(行)を保持したまま、その横に部署の平均給与を表示させることが可能です。
この特性により、詳細データと集計値を同一行に並べて比較するような処理が、サブクエリを使わずに簡潔に記述できるようになります。
ウィンドウ関数のメリット
ウィンドウ関数を習得することで、以下のようなメリットが得られます。
- SQLコードの簡略化:複雑な自己結合(Self-Join)や多段のサブクエリを回避でき、可読性が向上します。
- 高度な分析の実現:累計、移動平均、前後の行との差分取得など、実務で頻出する分析が容易になります。
- パフォーマンスの最適化:多くのデータベースエンジンにおいて、ウィンドウ関数は内部的に最適化されており、自己結合を繰り返すよりも高速に動作する傾向があります。
ウィンドウ関数の基本構文
ウィンドウ関数の基本的な書き方は、関数名の後ろにOVER句を記述する形式をとります。
-- 基本的な構文
関数名(引数) OVER (
  PARTITION BY カラム名 -- グループ化の指定
  ORDER BY カラム名     -- 並び替えの指定
  ROWS/RANGE 指定       -- 計算範囲(フレーム)の指定
)
それぞれの要素がどのような役割を持つのか、詳しく見ていきましょう。
OVER句の役割
OVER句は、その関数を「ウィンドウ関数として実行する」ことを宣言するためのキーワードです。
この句が存在することで、SQLエンジンは集約ではなくウィンドウ処理として解釈します。
OVER()のようにカッコ内を空にした場合は、テーブル全体のすべての行を一つのウィンドウとして扱います。
PARTITION BYによるグループ化
PARTITION BYは、データを特定のグループに分割するために使用します。
GROUP BY句と似ていますが、前述の通り「行をまとめない」点が異なります。
例えば、PARTITION BY categoryと指定すれば、商品カテゴリごとに独立した計算範囲が作られます。
これにより、カテゴリ内での順位付けや、カテゴリ内での合計値算出が可能になります。
ORDER BYによる並び替え
ウィンドウ内での処理順序を決定するのがORDER BYです。
ランキング関数(ROW_NUMBERなど)を使用する場合や、時系列で累計を計算する場合には必須となります。
この並び替えはあくまでウィンドウ内での計算順序を定義するものであり、最終的な結果セットの出力順を保証するものではない点に注意してください。
ROWS/RANGEによる範囲指定 (Window Frame)
より詳細な計算範囲を指定したい場合に用いるのがフレーム指定(Window Frame)です。
現在行から見て「前何行から後何行まで」を計算対象にするかを定義します。
| 指定方法 | 意味 |
|---|---|
ROWS BETWEEN 2 PRECEDING AND CURRENT ROW | 現在行と、その前の2行を含む計3行 |
ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW | ウィンドウの先頭から現在行まで(累計によく使われる) |
ROWS BETWEEN 1 PRECEDING AND 1 FOLLOWING | 前の一行、現在行、次の一行の計3行 |
代表的なウィンドウ関数の種類
ウィンドウ関数は、その機能によって大きく3つのカテゴリに分類されます。
ランキング関数
行に順位や番号を付与する関数です。
ROW_NUMBER():重複に関係なく、一意の連番を振ります。RANK():同じ値がある場合に同順位をつけ、次の順位を飛ばします(例:1位、2位、2位、4位)。DENSE_RANK():同じ値がある場合に同順位をつけますが、次の順位を飛ばしません(例:1位、2位、2位、3位)。
集計用ウィンドウ関数
通常の集約関数(SUM, AVG, COUNT, MAX, MIN)をウィンドウ関数として利用します。
例えば、SUM(sales) OVER(PARTITION BY region)と記述すれば、各行に所属リージョンの総売上を表示させることができます。
これは、個人の売上がリージョン全体の中でどの程度の割合を占めているかを計算する際に非常に便利です。
前後行の参照関数 (LAG, LEAD)
現在行を基準に、別の行の値を取得する特殊な関数です。
LAG(カラム名, オフセット):指定した行数分「前」の行の値を取得します。LEAD(カラム名, オフセット):指定した行数分「後」の行の値を取得します。
これらは、「前日の売上との比較」や「ログデータにおけるセッション間の時間差計算」などに頻繁に利用されます。
実務で役立つ活用パターン
理論を学んだところで、実際のビジネスシーンを想定した具体的な活用例を紹介します。
売上の累計 (Running Total) を計算する
日次の売上データから、その月やその年における「現時点までの合計」を算出するパターンです。
SELECT
  order_date,
  amount,
  -- 日付順に並べて、先頭から現在行までの合計を算出
  SUM(amount) OVER (ORDER BY order_date ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW) AS running_total
FROM
sales_data;| order_date | amount | running_total |
| :--- | :--- | :--- |
| 2026-01-01 | 1000 | 1000 |
| 2026-01-02 | 1500 | 2500 |
| 2026-01-03 | 1200 | 3700 |このように、UNBOUNDED PRECEDING(無制限の遡り)を使用することで、簡単に累計を求めることができます。
カテゴリ別のランキングと上位抽出
各商品カテゴリの中で売上の高い上位3件のみを取得したい、といったケースです。
WITH RankedProducts AS (
  SELECT
    category,
    product_name,
    sales_amount,
    -- カテゴリごとに売上の高い順にランク付け
    DENSE_RANK() OVER (PARTITION BY category ORDER BY sales_amount DESC) AS rnk
  FROM
    products
)
SELECT
  *
FROM
  RankedProducts
WHERE
  rnk <= 3; -- 各カテゴリのトップ3のみ抽出
この処理をウィンドウ関数なしで行おうとすると、相関サブクエリなどを用いた非常に複雑な記述が必要になりますが、ウィンドウ関数とCTE(共通テーブル式)を組み合わせれば非常にスッキリと記述できます。
前月比・前年比の成長率を算出する
昨今のデータ分析において「成長率」の可視化は必須です。
LAG関数を使用することで、自己結合なしで前月の値を取得できます。
SELECT
  target_month,
  monthly_sales,
  -- 1ヶ月前の売上を取得
  LAG(monthly_sales, 1) OVER (ORDER BY target_month) AS prev_month_sales,
  -- 成長率の計算
  (monthly_sales - LAG(monthly_sales, 1) OVER (ORDER BY target_month))
    / LAG(monthly_sales, 1) OVER (ORDER BY target_month) * 100 AS growth_rate
FROM
monthly_summary;| target_month | monthly_sales | prev_month_sales | growth_rate |
| :--- | :--- | :--- | :--- |
| 2026-01 | 500000 | NULL | NULL |
| 2026-02 | 550000 | 500000 | 10.0 |
| 2026-03 | 522500 | 550000 | -5.0 |移動平均を用いたトレンド分析
売上データなどは日々の変動が激しいため、トレンドを把握するために「直近7日間の平均(移動平均)」を算出することがよくあります。
SELECT
  order_date,
  daily_revenue,
  -- 現在行を含む直近7日間の平均を算出
  AVG(daily_revenue) OVER (
    ORDER BY order_date
    ROWS BETWEEN 6 PRECEDING AND CURRENT ROW
  ) AS rolling_avg_7d
FROM
daily_sales;このようにフレーム指定を使いこなすことで、ノイズを除去した滑らかなトレンドラインをSQLだけで生成することが可能になります。
ウィンドウ関数を使用する際の注意点
非常に強力なウィンドウ関数ですが、実務で利用する際にはいくつか注意すべきポイントがあります。
パフォーマンスへの影響
ウィンドウ関数は非常に効率的ですが、膨大なデータに対して複数のウィンドウ関数を一度に適用すると、計算リソース(メモリやCPU)を消費します。
特にORDER BYを伴う処理はデータのソートが発生するため、対象行数が多い場合は実行計画を確認し、適切なインデックスが貼られているかを確認することが重要です。
WHERE句での直接使用不可
ウィンドウ関数はSQLの実行順序において、WHERE句やGROUP BY句よりも後に評価されます。
そのため、以下のような記述はエラーになります。
-- NGな例
SELECT * FROM sales WHERE RANK() OVER(ORDER BY amount DESC) <= 10;ランキングの上位で絞り込みたい場合は、前述の「カテゴリ別ランキング」の例で示したように、CTE(WITH句)やサブクエリを使用して、一度関数を計算してから外部でフィルタリングする必要があります。
データベース製品による差異
主要なRDBMS(PostgreSQL, MySQL, Oracle, SQL Server, BigQueryなど)の多くはウィンドウ関数をサポートしていますが、一部の高度な関数やフレーム指定のオプション(RANGEとROWSの挙動の違いなど)については、製品ごとに細かな仕様の差異が存在します。
利用している環境の公式ドキュメントを一度確認しておくことを推奨します。
まとめ
SQLウィンドウ関数は、現代のデータエンジニアリングやビジネスインテリジェンスにおいて、もはや必須のスキルと言っても過言ではありません。
行をまとめずに高度な集計を行うという特性を理解すれば、「累計」「ランキング」「前月比較」「移動平均」といった複雑な分析クエリを驚くほどシンプルに記述できるようになります。
まずは最も使用頻度の高いROW_NUMBERやSUM() OVERから使い始め、徐々にフレーム指定などの応用的なテクニックを取り入れてみてください。
ウィンドウ関数を自在に操れるようになれば、あなたのSQLによるデータ分析能力は一段上のレベルへと引き上げられるはずです。
日々の業務におけるレポート作成やデータ加工のプロセスを、より効率的で洗練されたものへと進化させていきましょう。