
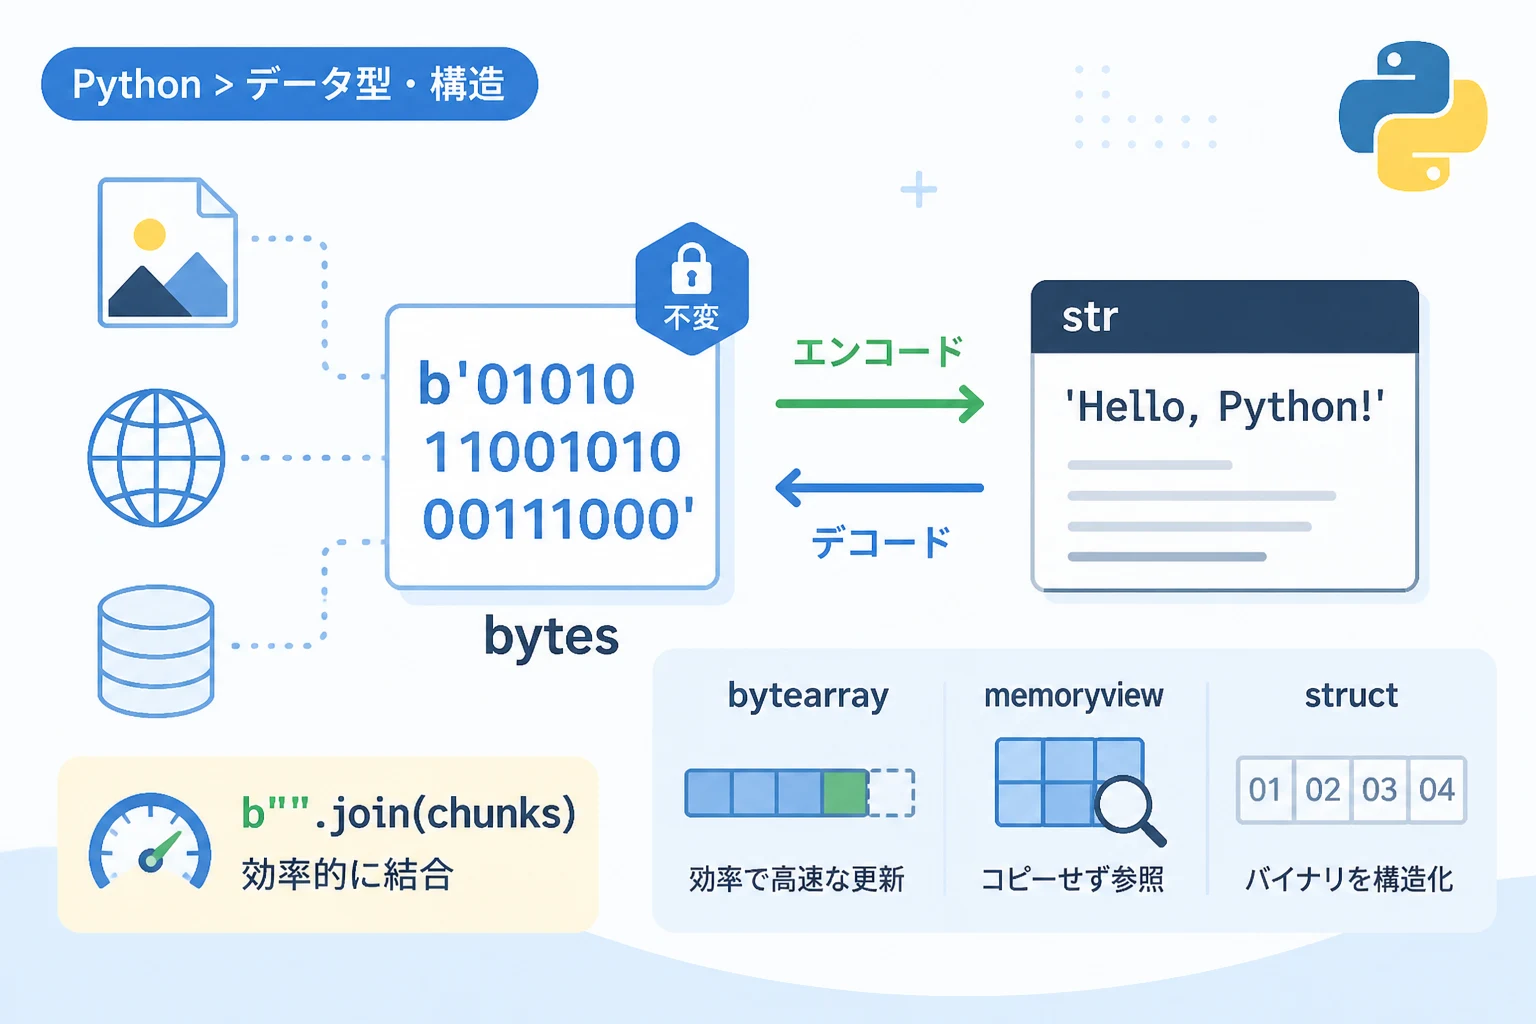
Pythonにおけるバイナリデータの扱いは、Web開発からAIモデルのデータ処理、ネットワーク通信まで、現代のプログラミングにおいて避けては通れない重要な要素です。
bytes型を正しく理解し使いこなすことは、システムのパフォーマンスを向上させ、文字化けやデータ破損といった深刻なバグを未然に防ぐことにつながります。
この記事では、bytes型の基礎から応用、そして最新のPython環境における効率的な活用方法までを詳しく解説していきます。
bytes型の基礎知識とstr型との決定的な違い
Pythonでデータを扱う際、最も頻繁に利用するのがstr型(文字列型)とbytes型(バイト列型)の2種類です。
str型は人間が読み書きするためのUnicode文字のシーケンスであり、抽象化されたテキストデータを保持します。
一方でbytes型は、コンピューターが直接理解できる0から255までの整数(8ビット)のシーケンスです。
画像ファイルや音声データ、ネットワーク経由で送信される生データなどは、すべてこのbytes型として処理されます。
Python 3以降、これらの型は厳格に区別されており、暗黙的な変換は行われないという点に注意が必要です。
例えば、文字列をファイルに保存したりソケットで送信したりする場合、必ず特定のエンコーディングを用いてバイナリデータに変換しなければなりません。
bytes型のリテラル表記とコンストラクタ
bytesオブジェクトを生成する最も簡単な方法は、文字列の前に b プレフィックスを付けるリテラル表記です。
この表記法では、ASCII文字の範囲内であればそのまま記述でき、それ以外はエスケープシーケンスを使用して表現します。
# bytes型のリテラル表記
data = b"Hello Python"
print(data)
print(type(data))

# 16進数による表記
hex_data = b"\x48\x65\x6c\x6c\x6f"
print(hex_data)b'Hello Python'
<class 'bytes'>
b'Hello'また、bytes() コンストラクタを使用することで、数値のリストや指定したサイズの空のバイト列を生成することも可能です。
特定のサイズのバッファを事前に確保したい場合など、プログラムの用途に応じて最適な生成方法を選択しましょう。
bytes型の基本操作とイミュータブルな特性
bytes型は「イミュータブル(不変)」なデータ型であり、一度作成するとその中身を直接変更することはできません。
この特性は、ハッシュ値の計算やディクショナリのキーとしての利用を安全にするための重要な仕様です。
もし内容を頻繁に変更する必要がある場合は、後述する bytearray 型を検討する必要があります。
インデックスアクセスとスライス
bytes型の要素にインデックスでアクセスすると、その位置にある0から255までの整数が返されます。
一方で、スライスを用いて範囲指定した場合は、新しい bytes オブジェクトが返されるという違いがあります。
data = b"Python"

# インデックスアクセス(整数が返る)
print(data[0])

# スライスアクセス(bytes型が返る)
print(data[0:1])112
b'P'112という数値は、ASCIIコードにおける「P」の値に対応しています。
このように、bytes型を扱う際は「文字」ではなく「数値の集合」を扱っているという意識を持つことが、正確なプログラミングへの第一歩となります。
エンコードとデコード:str型との相互変換
テキストデータとバイナリデータを相互に変換するプロセスを、それぞれエンコード(符号化)とデコード(復号)と呼びます。
この処理を正しく理解していないと、マルチバイト文字を扱う際に「UnicodeDecodeError」などのエラーに直面することになります。
文字列からバイナリへの変換(encode)
str オブジェクトを bytes オブジェクトに変換するには、encode() メソッドを使用します。
現代の標準的な開発環境では、文字エンコーディングとして UTF-8 を指定するのが最も一般的です。
text = "こんにちは"
# UTF-8でエンコード
binary_data = text.encode("utf-8")
print(binary_data)b'\xe3\x81\x93\xe3\x82\x93\xe3\x81\xab\xe3\x81\xa1\xe3\x81\xaf'日本語の1文字はUTF-8では通常3バイトで表現されるため、上記の結果のように16進数の並びとして出力されます。
バイナリから文字列への変換(decode)
受信したバイナリデータをテキストとして処理するには、decode() メソッドを使用して str 型に戻します。
デコード時には、エンコード時と同じ文字コードを指定しなければなりません。
binary_data = b'\xe3\x81\x93\xe3\x82\x93\xe3\x81\xab\xe3\x81\xa1\xe3\x81\xaf'
# デコードして文字列に戻す
text = binary_data.decode("utf-8")
print(text)こんにちはエラーハンドリングの重要性
外部からの入力データは必ずしも期待通りのエンコーディングであるとは限りません。
不正なバイト列が含まれていた場合にプログラムを停止させないよう、errors 引数を活用して柔軟に対応することが推奨されます。
| エラー処理モード | 動作内容 |
|---|---|
| strict | デフォルト設定。エラーが発生すると例外を送出する。 |
| ignore | 不正なバイトを無視して処理を続行する。 |
| replace | 不正なバイトを「?」などの置換文字に置き換える。 |
| backslashreplace | 不正なバイトをバックスラッシュによるエスケープ形式に変換する。 |
bytearray型によるミュータブルなバイナリ操作
bytes 型は変更不能であるため、データの結合や置換を繰り返すと新しいオブジェクトが都度生成され、メモリ効率が悪化することがあります。
そこで活用したいのが、ミュータブル(変更可能)なバイト列である bytearray 型です。
bytearray はリストのように要素を直接書き換えたり、append() メソッドでデータを追加したりすることが可能です。
# bytearrayの生成と変更
ba = bytearray(b"Python")
ba[0] = ord("C") # 'P'を'C'に変更
print(ba)

ba.extend(b" 3.x")
print(ba)bytearray(b'Cython')
bytearray(b'Cython 3.x')大量のデータをストリームとして受信し、順次バッファに蓄積していくような処理では、bytes よりも bytearray の方が圧倒的に高いパフォーマンスを発揮します。
高度なバイナリ操作:memoryviewとstructモジュール
近年のPythonでは、大規模なデータ処理や低レイヤーの通信を高速化するために、より高度な機能が提供されています。
これらを使いこなすことで、余分なメモリコピーを排除し、効率的なデータ処理を実現できます。
memoryviewによるゼロコピー操作
memoryview オブジェクトを使用すると、元のデータをコピーすることなく、その一部をスライスとして参照できます。
通常のスライス操作ではデータの複製が発生しますが、memoryview は「データの窓」として機能するため、メモリ消費を抑えられます。
data = bytearray(b"Large Binary Data Content")
view = memoryview(data)

# データのコピーを行わずにスライスを取得
sub_view = view[6:12]
print(sub_view.tobytes())

# viewを通じて元のデータを書き換えることも可能
sub_view[0] = ord("B")
print(data)b'Binary'
bytearray(b'Large Binary Data Content')数GB単位のファイルをメモリマップして処理する場合や、高頻度なネットワークパケットの解析において、このゼロコピーの特性は決定的な差を生みます。
structモジュールによるデータのパッキング
C言語の構造体のような形式でバイナリデータを扱いたい場合、struct モジュールが不可欠です。
整数や浮動小数点数を特定のバイトオーダー(エンディアン)で bytes 型に変換したり、その逆を行ったりすることができます。
import struct

# 整数(I)と浮動小数点数(f)をバイナリにパック
packed_data = struct.pack(">If", 1024, 3.14)
print(packed_data)

# バイナリからアンパック
unpacked_data = struct.unpack(">If", packed_data)
print(unpacked_data)b'\x00\x00\x04\x00@I\x0f\xdb'
(1024, 3.140000104904175)> はビッグエンディアンを意味しており、通信プロトコルの仕様に基づいた正確なデータ生成をサポートします。
実践的な活用例:ファイルI/Oとネットワーク
bytes型の知識が最も試されるのは、外部リソースとのやり取りを行う場面です。
ここでは、代表的な2つのケースにおける実装パターンを見ていきましょう。
バイナリファイルの読み書き
画像や実行ファイルなどを扱う際は、open() 関数のモードに "b" を指定することが必須です。
テキストモード(”r”, “w”)とは異なり、エンコーディングの自動変換が行われないため、データの整合性が保たれます。
# バイナリデータの書き込み
with open("sample.dat", "wb") as f:
    f.write(b"\xff\xd8\xff\xe0\x00\x10JFIF")

# バイナリデータの読み込み
with open("sample.dat", "rb") as f:
    header = f.read(4)
print(f"File Header: {header.hex()}")File Header: ffd8ffe0hex() メソッドを使用すると、バイナリデータを人間が読みやすい16進文字列として表示できるため、デバッグに非常に便利です。
最新のPythonにおけるパフォーマンス最適化
2026年現在のPython環境では、bytes 型の結合に関する内部最適化がさらに進んでいます。
しかし、それでもなお大量の bytes オブジェクトを + 演算子で結合する手法はアンチパターンとされています。
複数のバイト列を効率的に結合するには、b"".join() メソッドを使用するのがベストプラクティスです。
chunks = [b"Part 1", b"Part 2", b"Part 3"]
# 効率的な結合
combined = b" ".join(chunks)
print(combined)b'Part 1 Part 2 Part 3'この手法は、一度のメモリ確保で全データを格納するため、ループ内での逐次的な結合に比べて計算量が大幅に削減されます。
まとめ
Pythonにおける bytes 型の操作は、単なるデータの型変換以上の意味を持っています。
str型との明確な使い分けを意識し、用途に応じて bytearray や memoryview を選択することが、高品質なプログラムを書くための鍵となります。
特にエンコーディングの適切な指定や struct モジュールによるパッキングは、システム間の連携においてトラブルを防ぐための必須知識です。
本記事で紹介した基本操作と効率的な手法を、ぜひ日々の開発に取り入れてみてください。
バイナリデータを自在に操れるようになることで、Pythonプログラミングの幅は大きく広がるはずです。