
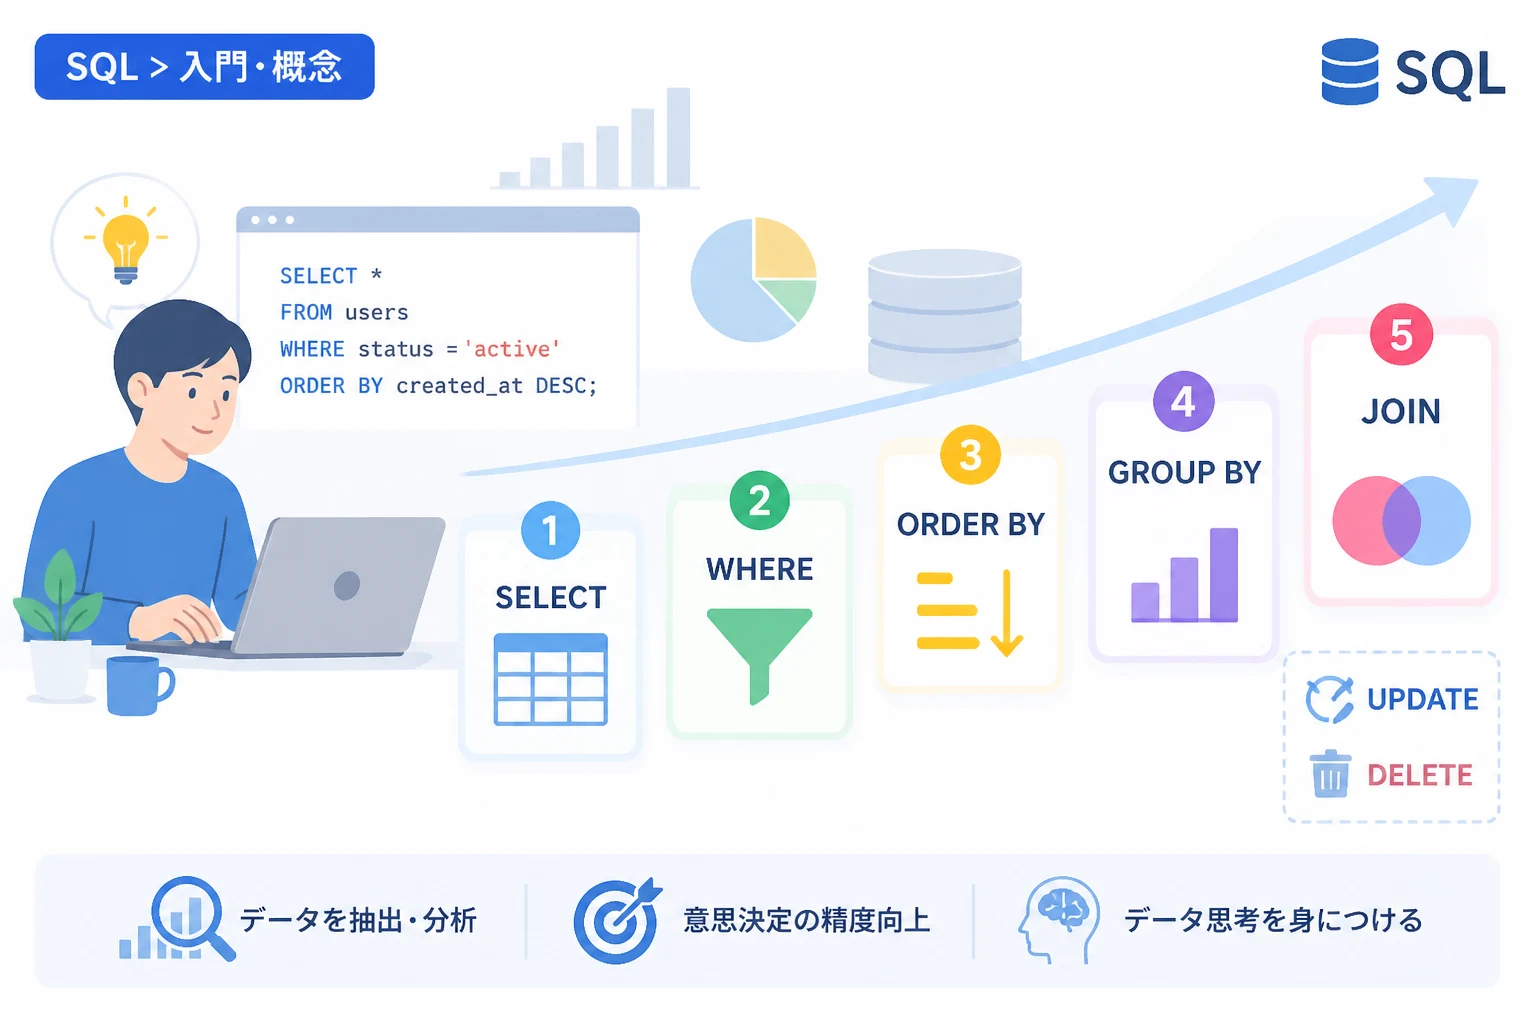
データ活用が企業の競争力を左右する2026年において、SQLはエンジニアだけでなく、ビジネス職の方にとっても必須のスキルとなりました。
データベースから必要な情報を自由に取り出すことができれば、業務の効率化や意思決定の精度は飛躍的に向上します。
本記事では、プログラミング初心者の方でもSQLの使い方が理解できるように、基本構文から実践的なクエリ作成までをステップ別に解説します。
まずはSQLの概要を理解し、実際にコードを書くための準備を整えていきましょう。
SQLとは何か?データベースを操作するための共通言語
SQLは(Structured Query Language)の略称で、リレーショナルデータベース(RDBMS)に蓄積されたデータを操作するための言語です。
私たちが普段利用しているWebアプリやスマートフォンアプリの裏側では、膨大なデータがデータベースに保存されています。
SQLを使うことで、それらのデータの中から特定の条件に合うものだけを抽出したり、新しく情報を追加したりすることが可能になります。
SQLは国際標準規格として定義されているため、一度基本を身につければ、MySQLやPostgreSQL、Oracleなど、多くのデータベース製品で共通して利用できるのが大きなメリットです。
2026年現在は、AIによるクエリの自動生成も進化していますが、生成されたコードの正誤を判断し、最適化するためには依然として人間がSQLの構造を理解している必要があります。
リレーショナルデータベース(RDBMS)の仕組み
SQLを学ぶ前に、データの格納形式であるリレーショナルデータベースの仕組みを理解しておきましょう。
データは「テーブル」と呼ばれる、Excelのシートのような表形式で管理されます。
テーブルは「カラム(列)」と「レコード(行)」で構成されており、各カラムには特定のデータ型(数値、文字列、日付など)が定義されています。
複数のテーブル同士を、特定のIDなどの共通項目で関連付けて(リレーション)管理するのがRDBMSの特徴です。
SQLを学ぶ前の準備
SQLを実践するためには、データベースを操作できる環境が必要です。
現在では、ブラウザ上で手軽にSQLを実行できるオンライン実行環境や、クラウド上のデータベースサービスが数多く提供されています。
学習を始めるにあたっては、以下のいずれかのRDBMSをインストールするか、オンライン学習サイトを利用することをおすすめします。
- MySQL:世界中で広く利用されているオープンソースのデータベースです。
- PostgreSQL:高度な機能を持ち、複雑なデータ処理にも向いているデータベースです。
- SQLite:設定不要でファイルとしてデータベースを扱えるため、入門に最適です。
【ステップ1】データの取得(SELECT)
SQLの中で最も頻繁に使われるのが、データを取得するためのSELECT文です。
このセクションでは、テーブルから特定のカラムを抽出する基本的な使い方を学びましょう。
基本のSELECT構文
データを取得する際の基本形は、SELECT カラム名 FROM テーブル名;という記述になります。
全てのカラムを取得したい場合は、アスタリスク(*)を使用します。
-- 全てのカラムを取得する例
SELECT * FROM users;

-- 特定のカラム(氏名、年齢)のみを取得する例
SELECT user_name, age FROM users;user_name | age
----------|----
田中太郎 | 25
佐藤花子 | 30
鈴木一郎 | 22別名の付与(AS)
取得するカラムに、一時的な別名をつけることができます。
これにはAS句を使用し、出力結果をわかりやすく調整する際に役立ちます。
-- カラム名に別名を付ける
SELECT user_name AS 顧客名, age AS 年齢 FROM users;
【ステップ2】条件による絞り込み(WHERE)
膨大なデータの中から、必要なデータだけを抽出するためにはWHERE句を使用します。
WHERE句を使いこなすことで、高度なデータ分析が可能になります。
比較演算子を用いた絞り込み
数値の大小比較や、文字列の完全一致による絞り込みを行うことができます。
-- 25歳以上のユーザーを取得する
SELECT * FROM users WHERE age >= 25;
論理演算子(AND, OR, NOT)
複数の条件を組み合わせる場合には、ANDやORを使用します。
-- 20歳以上、かつ30歳未満のユーザーを取得
SELECT * FROM users WHERE age >= 20 AND age < 30;

-- 住所が「東京」または「大阪」のユーザーを取得
SELECT * FROM users WHERE address = '東京' OR address = '大阪';
あいまい検索(LIKE)
特定の文字列を含むデータを検索したい場合には、LIKE演算子とワイルドカード(%)を使用します。
%は「0文字以上の任意の文字列」を表します。
-- 名前が「田中」で始まるユーザーを検索(前方一致)
SELECT * FROM users WHERE user_name LIKE '田中%';

-- メールアドレスに「@example.com」を含むユーザーを検索(部分一致)
SELECT * FROM users WHERE email LIKE '%@example.com';
注意点として、LIKE演算子で%を先頭に付けると検索速度が低下することがあります。
【ステップ3】データの並べ替えと取得数の制限
取得した結果を特定の順序に並べ替えたり、必要な件数だけを取り出したりする方法を解説します。
データのソート(ORDER BY)
ORDER BY句を使うことで、昇順(ASC)または降順(DESC)でデータを並べ替えることができます。
デフォルトでは昇順(小さい順)になります。
-- 年齢が若い順(昇順)に並べ替える
SELECT * FROM users ORDER BY age ASC;

-- 登録日が新しい順(降順)に並べ替える
SELECT * FROM users ORDER BY created_at DESC;
取得件数の制限(LIMIT)
大量のデータを一度に取得すると処理に時間がかかるため、LIMITを使って取得件数を制限することが一般的です。
-- 年齢が高い上位5名のみを取得
SELECT * FROM users ORDER BY age DESC LIMIT 5;
【ステップ4】集計関数とグループ化
SQLの強力な機能の一つに、データの合計や平均を算出する集計機能があります。
主要な集計関数
よく使われる集計関数には以下の5つがあります。
| 関数名 | 説明 |
|---|---|
| COUNT | 行数を数える |
| SUM | 数値の合計を算出する |
| AVG | 数値の平均を算出する |
| MAX | 最大値を求める |
| MIN | 最小値を求める |
データのグループ化(GROUP BY)
GROUP BY句を使用すると、特定のカラムごとにデータをまとめて集計を行うことができます。
-- 都道府県ごとにユーザー数を集計する
SELECT address, COUNT(*) AS ユーザー数
FROM users
GROUP BY address;address | ユーザー数
--------|---------
東京 | 150
大阪 | 85
福岡 | 42集計結果に対する絞り込み(HAVING)
WHERE句は集計前のデータに適用されますが、集計後の結果に対して条件をつけたい場合はHAVING句を使用します。
-- ユーザー数が100人以上の都道府県のみを表示
SELECT address, COUNT(*) AS ユーザー数
FROM users
GROUP BY address
HAVING COUNT(*) >= 100;
【ステップ5】複数テーブルの結合(JOIN)
実務で扱うデータベースでは、データが複数のテーブルに分散して保存されています。
それらを結合して一つの結果として表示するためにJOINを使います。
内部結合(INNER JOIN)
両方のテーブルに存在する共通のデータのみを取得する方法です。
-- 注文テーブルとユーザーテーブルを結合して、誰が何を注文したかを表示
SELECT orders.order_id, users.user_name, orders.product_name
FROM orders
INNER JOIN users ON orders.user_id = users.user_id;
左外部結合(LEFT JOIN)
左側のテーブルにある全てのデータを取得し、右側のテーブルに一致するデータがあればそれを結合します。
一致するデータがない場合は、右側のテーブルのカラムはNULLになります。
-- 全ユーザーと、もしあればその注文履歴を表示(注文がないユーザーも含まれる)
SELECT users.user_name, orders.order_id
FROM users
LEFT JOIN orders ON users.user_id = orders.user_id;
【ステップ6】データの登録・更新・削除(DML)
ここまではデータの取得方法を見てきましたが、実際のシステム運用ではデータの追加や変更も不可欠です。
データの挿入(INSERT)
新しいレコードをテーブルに追加するにはINSERT文を使用します。
-- usersテーブルに新しいユーザーを追加
INSERT INTO users (user_name, age, address)
VALUES ('佐藤健二', 28, '神奈川');
データの更新(UPDATE)
既存のデータを修正するにはUPDATE文を使用します。
WHERE句を忘れると、全てのデータが更新されてしまうため、非常に危険です。
-- 特定のユーザーの住所を変更する
UPDATE users
SET address = '千葉'
WHERE user_id = 5;
データの削除(DELETE)
不要なレコードを削除するにはDELETE文を使用します。
こちらもWHERE句による指定が必須と言えます。
-- 退会したユーザーのデータを削除
DELETE FROM users
WHERE user_id = 10;
【ステップ7】テーブルの作成と管理(DDL)
データの入れ物となるテーブル自体の構造を定義するためのSQLを学びます。
テーブルの作成(CREATE TABLE)
カラム名とデータ型を指定してテーブルを作成します。
-- 商品管理テーブルの作成
CREATE TABLE products (
    product_id INT PRIMARY KEY,
    name VARCHAR(100) NOT NULL,
    price INT,
    stock_quantity INT DEFAULT 0
);
テーブル構造の変更(ALTER TABLE)
運用開始後にカラムを追加したり、データ型を変更したりする場合に使用します。
-- productsテーブルにカテゴリIDカラムを追加
ALTER TABLE products ADD category_id INT;
テーブルの削除(DROP TABLE)
テーブルそのものを完全に削除します。
中のデータも全て消えるため注意が必要です。
-- 古いバックアップテーブルを削除
DROP TABLE old_users_backup;
実践的なクエリ作成のコツ
SQLの使い方に慣れてきたら、より効率的でミスの少ないクエリ作成を心がけましょう。
ここでは、現場で役立ついくつかのテクニックを紹介します。
サブクエリ(副問合せ)の活用
SQLの中に別のSQLをネスト(入れ子)させることができます。
これにより、集計した結果をもとにさらに絞り込むといった複雑な処理が可能になります。
-- 平均価格よりも高い商品の一覧を取得
SELECT * FROM products
WHERE price > (SELECT AVG(price) FROM products);
CASE式による条件分岐
取得結果の中で、特定の条件に応じて表示内容を変えることができます。
-- 年齢に応じて年代ラベルを付与する
SELECT user_name,
    CASE
        WHEN age < 20 THEN '10代'
        WHEN age < 30 THEN '20代'
        ELSE '30代以上'
    END AS 年代
FROM users;
実行計画の確認
2026年のデータ活用シーンでは、データ量がテラバイト級になることも珍しくありません。
クエリが重いと感じたときは、EXPLAINコマンドを使って実行計画を確認し、適切にインデックスが使われているかチェックしましょう。
まとめ
SQLは、データの抽出から管理までを柔軟に行える非常に強力な言語です。
まずはSELECT文でデータを取得するところから始め、徐々にWHERE句やJOINを組み合わせた複雑なクエリに挑戦してみてください。
SQLの書き方を身につけることは、単なるスキル習得にとどまらず、論理的にデータを捉える「データ思考」を養うことにも繋がります。
実際に手を動かしてデータベースを操作することが、上達への一番の近道です。
本記事で紹介した基本構文を参考に、ぜひ日々の業務や学習に役立ててください。