
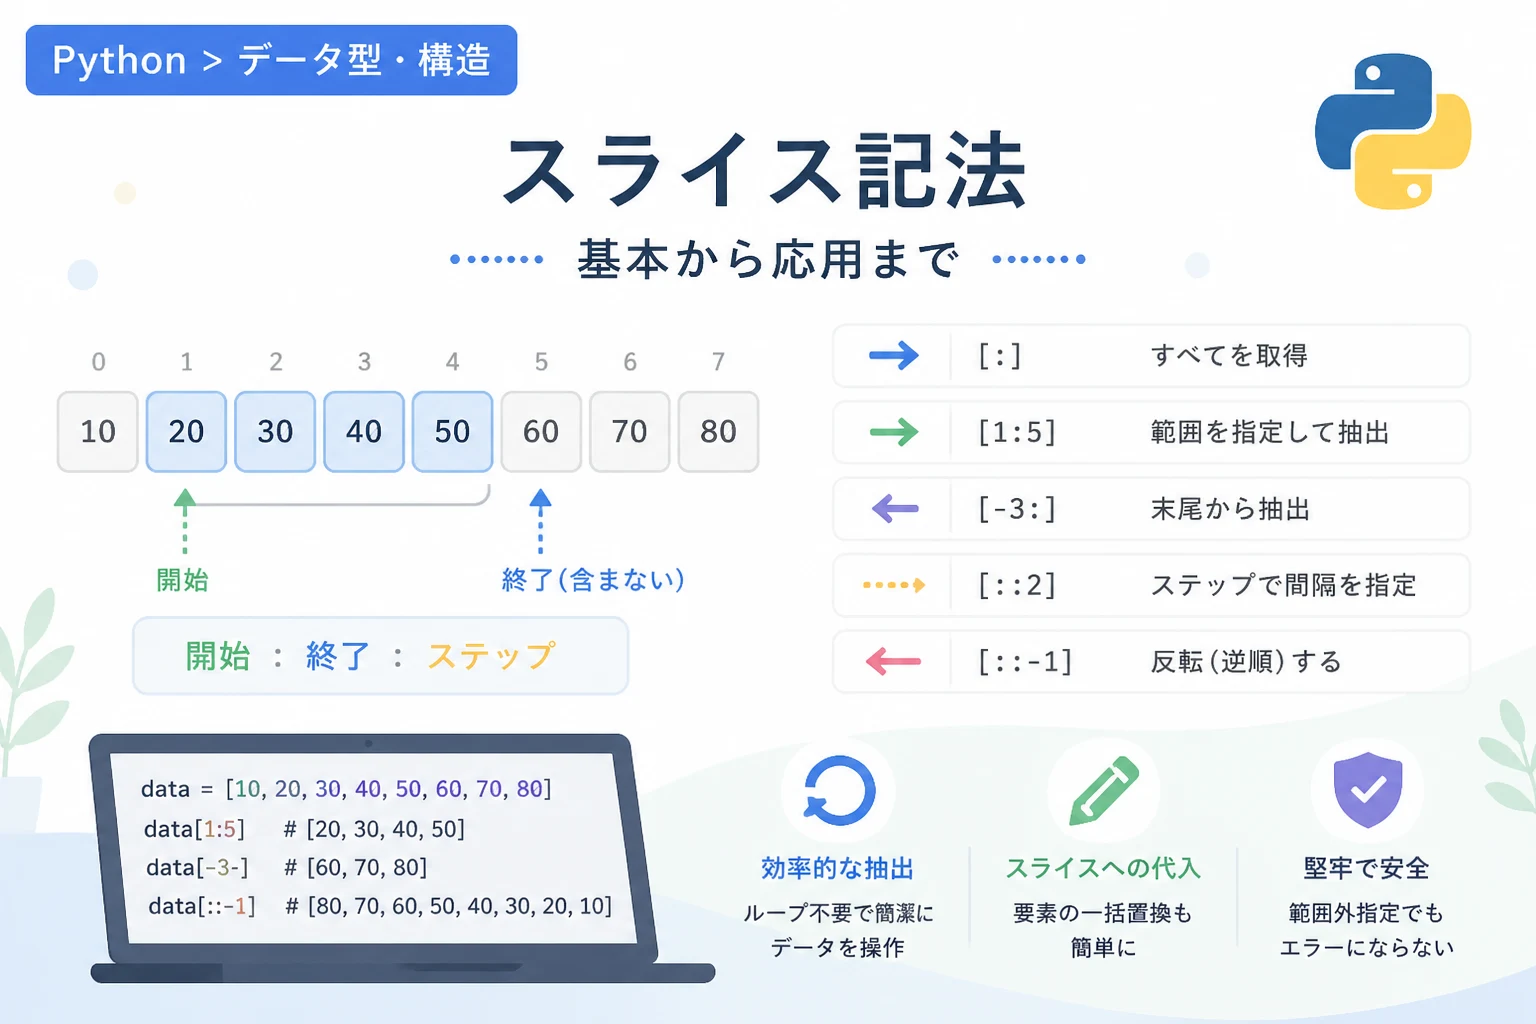
Pythonのプログラミングにおいて、リストや文字列といったシーケンス型のデータから必要な部分を抽出する「スライス記法」は、最も基本的かつ強力な機能の一つです。
2026年の現在、AI開発やデータサイエンスの現場では膨大なデータを効率的に処理することが求められており、スライスを正しく使いこなすことはコードの可読性とパフォーマンスを向上させるために不可欠なスキルと言えます。
本記事では、スライスの基本的な書き方から、実務で役立つ応用的なテクニック、さらにはスライスオブジェクトを活用した高度な操作まで、初心者の方にも分かりやすく順を追って解説していきます。
Pythonのスライス記法とは何か
Pythonのスライスとは、リストやタプル、文字列などの要素を、インデックスの範囲を指定して一括で取り出すための仕組みです。
通常、要素を一つだけ取り出すには list[0] のように単一のインデックスを指定しますが、スライスを使えば特定の範囲を新しいオブジェクトとして生成することができます。
スライス記法の最大の特徴は、独自の簡潔な構文を用いることで、ループ処理を書くことなく効率的に部分抽出が可能になる点にあります。
スライスの基本構文
スライスの基本的な書き方は、[開始インデックス:終了インデックス] という形をとります。
ここで非常に重要なルールは、終了インデックスに指定した位置の要素は含まれないということです。
例えば、[1:4] と指定した場合、インデックス1から3までの要素が取り出され、インデックス4の要素は含まれません。
以下のサンプルコードで、リストにおける基本的なスライス操作を確認してみましょう。
# 0から9までの数値を持つリストを作成
numbers = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]

# インデックス2から4まで(5は含まない)を抽出
sub_list = numbers[2:5]
print(sub_list)[2, 3, 4]開始位置と終了位置の省略
スライスでは、開始インデックスや終了インデックスを省略することが可能です。
開始インデックスを省略した場合、自動的に先頭(インデックス0)から抽出が始まります。
逆に終了インデックスを省略した場合は、指定した位置からリストの末尾まですべてが抽出対象となります。
両方を省略して [:] と記述すると、元のリストのすべての要素が含まれる「浅いコピー(shallow copy)」を作成することができます。
data = [10, 20, 30, 40, 50]

# 先頭からインデックス3の手前まで
print(data[:3])

# インデックス2から最後まで
print(data[2:])

# リスト全体のコピー
print(data[:])[10, 20, 30]
[30, 40, 50]
[10, 20, 30, 40, 50]マイナスインデックスを活用した抽出
Pythonでは、リストの末尾から数える「マイナスインデックス」を利用することができます。
末尾の要素は -1、その一つ前は -2 というように指定します。
このマイナスインデックスをスライスと組み合わせることで、「最後の3要素を取得したい」といった要望を非常にシンプルに記述できます。
リストの長さが動的に変わるプログラムにおいて、末尾からの相対位置で指定できるメリットは極めて大きいです。
items = ["A", "B", "C", "D", "E"]

# 最後の2つの要素を取得
print(items[-2:])

# 最初から「最後から2番目の手前」までを取得
print(items[:-2])['D', 'E']
['A', 'B', 'C']ステップ(増分)を指定する高度なスライス
スライス記法のフル形式は [開始:終了:ステップ] という3つの引数を持っています。
ステップを指定することで、「1つ飛ばしで要素を取得する」といった複雑な抽出が可能になります。
デフォルトのステップは 1 ですが、これを 2 に設定すれば偶数番目の要素だけを抜き出すといった操作が簡単に行えます。
ステップを利用した逆順の取得
ステップに負の値を指定すると、要素を逆順にたどることができます。
特に [::-1] という記述は、リストや文字列を反転させる最も一般的なテクニックとして知られています。
これはアルゴリズムの試験やデータ変換の際に頻出するパターンですので、覚えておくと非常に便利です。
chars = ["a", "b", "c", "d", "e", "f"]

# 2つ飛ばしで取得
print(chars[::2])

# 全体を逆順にする
print(chars[::-1])

# インデックス4から1までを逆順に取得(0は含まない)
print(chars[4:1:-1])['a', 'c', 'e']
['f', 'e', 'd', 'c', 'b', 'a']
['e', 'd', 'c']スライスへの代入によるリストの更新
スライスはデータの抽出だけでなく、既存のリストの一部を書き換える際にも活用できます。
これはミュータブル(変更可能)なオブジェクトであるリスト特有の操作です。
特定の範囲を指定して別のリストを代入することで、その範囲を新しい要素で一括置換したり、削除したり、割り込ませたりすることができます。
この際、代入するリストの長さは元のスライスの長さと一致している必要はありません。
nums = [1, 2, 3, 4, 5]

# インデックス1から3までを別のリストで置換
nums[1:4] = [20, 30]
print(nums)

# スライスを使って要素を削除(空のリストを代入)
nums[1:2] = []
print(nums)[1, 20, 30, 5]
[1, 30, 5]sliceオブジェクトによる再利用可能なスライス
通常は [start:stop:step] というリテラル表記を使いますが、Pythonには slice() という組み込み関数が存在します。
slice(start, stop, step) を実行すると、スライス情報を保持する「スライスオブジェクト」が生成されます。
同じ範囲の切り出しを複数のデータソースに対して行いたい場合、このオブジェクトを変数に格納しておくことでコードの重複を避け、メンテナンス性を向上させることができます。
# スライス条件を定義
TOP_THREE = slice(0, 3)

list_a = [10, 20, 30, 40, 50]
list_b = ["apple", "banana", "cherry", "date"]

# 同じ条件でスライスを適用
print(list_a[TOP_THREE])
print(list_b[TOP_THREE])[10, 20, 30]
['apple', 'banana', 'cherry']文字列におけるスライスの実用例
スライスはリストだけでなく、文字列(str型)に対しても全く同じように機能します。
文字列はイミュータブル(変更不可)であるため、スライスへの代入はできませんが、抽出操作は非常に頻繁に行われます。
例えば、ログファイルの日付部分だけを取り出したり、ファイルの拡張子を判定したりする際に重宝します。
filename = "2026_report_data.csv"

# 先頭の4文字(年)を取得
year = filename[:4]
print(year)

# 拡張子を除いたファイル名を取得
name_without_ext = filename[:-4]
print(name_without_ext)2026
2026_report_data実務で差がつくスライス活用のポイント
ここからは、実務の現場でスライスをより効果的に使うための知識を深掘りしていきましょう。
スライスを単なる「部分取得」としてだけでなく、データ構造の操作として捉えることが重要です。
安全なエラーハンドリング
スライスの非常に便利な特徴の一つに、範囲外のインデックスを指定してもエラー(IndexError)にならないという点があります。
単一要素へのアクセスである list[100] は、要素数が足りなければエラーになりますが、list[:100] はリストが空であっても空のリストを返すだけで済みます。
この性質を利用することで、データの長さを事前にチェックするコードを省略し、堅牢で簡潔なプログラムを書くことができます。
多次元配列(NumPyやPandas)への応用
データサイエンスにおいて多用されるNumPyやPandasでも、このスライスの概念は継承・拡張されています。
例えば、2次元配列(行列)に対して array[:5, 2:4] のように記述することで、行と列の両方を同時にスライスすることができます。
標準のPythonリストではこのような多次元指定はできませんが、基本のスライス記法を理解していれば、これらのライブラリの習得も非常にスムーズになります。
メモリ効率とパフォーマンス
大量のデータを扱う際、スライスがどのようにメモリを使用するかを知ることは重要です。
Pythonの標準リストに対するスライスは、常に新しいリストを作成します。
そのため、非常に大きなリストをループ内で繰り返しスライスすると、メモリ消費量が増加する可能性があります。
もしコピーを作成せずに参照だけを行いたい場合は、memoryview オブジェクトや、イテレータを利用する itertools.islice などの使用を検討しましょう。
スライス操作の比較表
これまで解説した主なスライス操作を、以下の表にまとめました。
用途に合わせて、適切な記法を選択してください。
| 記法 | 動作の説明 | 活用シーン |
|---|---|---|
[start:stop] | 指定範囲の抽出 | 標準的な部分抽出 |
[:stop] | 先頭から指定位置まで | データの冒頭部分の確認 |
[start:] | 指定位置から末尾まで | ヘッダーを除去したデータの取得 |
[::step] | 一定間隔での抽出 | データのサンプリング |
[::-1] | 要素の反転 | 文字列やリストの逆順処理 |
[:] | 全体の浅いコピー | 元のリストを破壊したくない時 |
よくある間違いと注意点
スライスを使い始めたばかりの時に陥りやすい罠がいくつかあります。
まず、[start:stop] の stop は「その番号まで」ではなく「その番号の手前まで」である点は、何度強調してもしすぎることはありません。
次に、ステップにマイナスを指定した際の挙動です。
逆順スライスを行う場合、start には stop よりも大きなインデックスを指定する必要があります。
例えば [1:4:-1] と記述しても、空のリストが返ってくるだけで、意図した結果は得られません。
# 間違った例:空の結果になる
invalid_slice = [0, 1, 2, 3, 4][1:4:-1]
print(f"Result: {invalid_slice}")

# 正しい例:大きい方から小さい方へ指定
valid_slice = [0, 1, 2, 3, 4][4:1:-1]
print(f"Result: {valid_slice}")Result: []
Result: [4, 3, 2]まとめ
Pythonのスライス記法は、単なるデータの切り出し機能にとどまらず、コードの抽象度を高め、Pythonらしい美しく効率的なプログラムを書くための鍵となります。
基本の [開始:終了] をマスターした後は、ステップ指定による逆順操作や、スライスオブジェクトによる再利用、さらにはミュータブルな特性を活かした代入操作など、活用の幅を広げていきましょう。
範囲外指定に強いという特性を活かせば、予期せぬエラーを防ぎつつ柔軟なデータ処理を実装することが可能です。
2026年においても、このスライス記法の重要性は変わらず、むしろデータ処理の高速化が求められる中でその価値は高まり続けています。
日々のコーディングの中で意識的にスライスを取り入れ、一歩進んだPythonプログラミングを実践してください。