
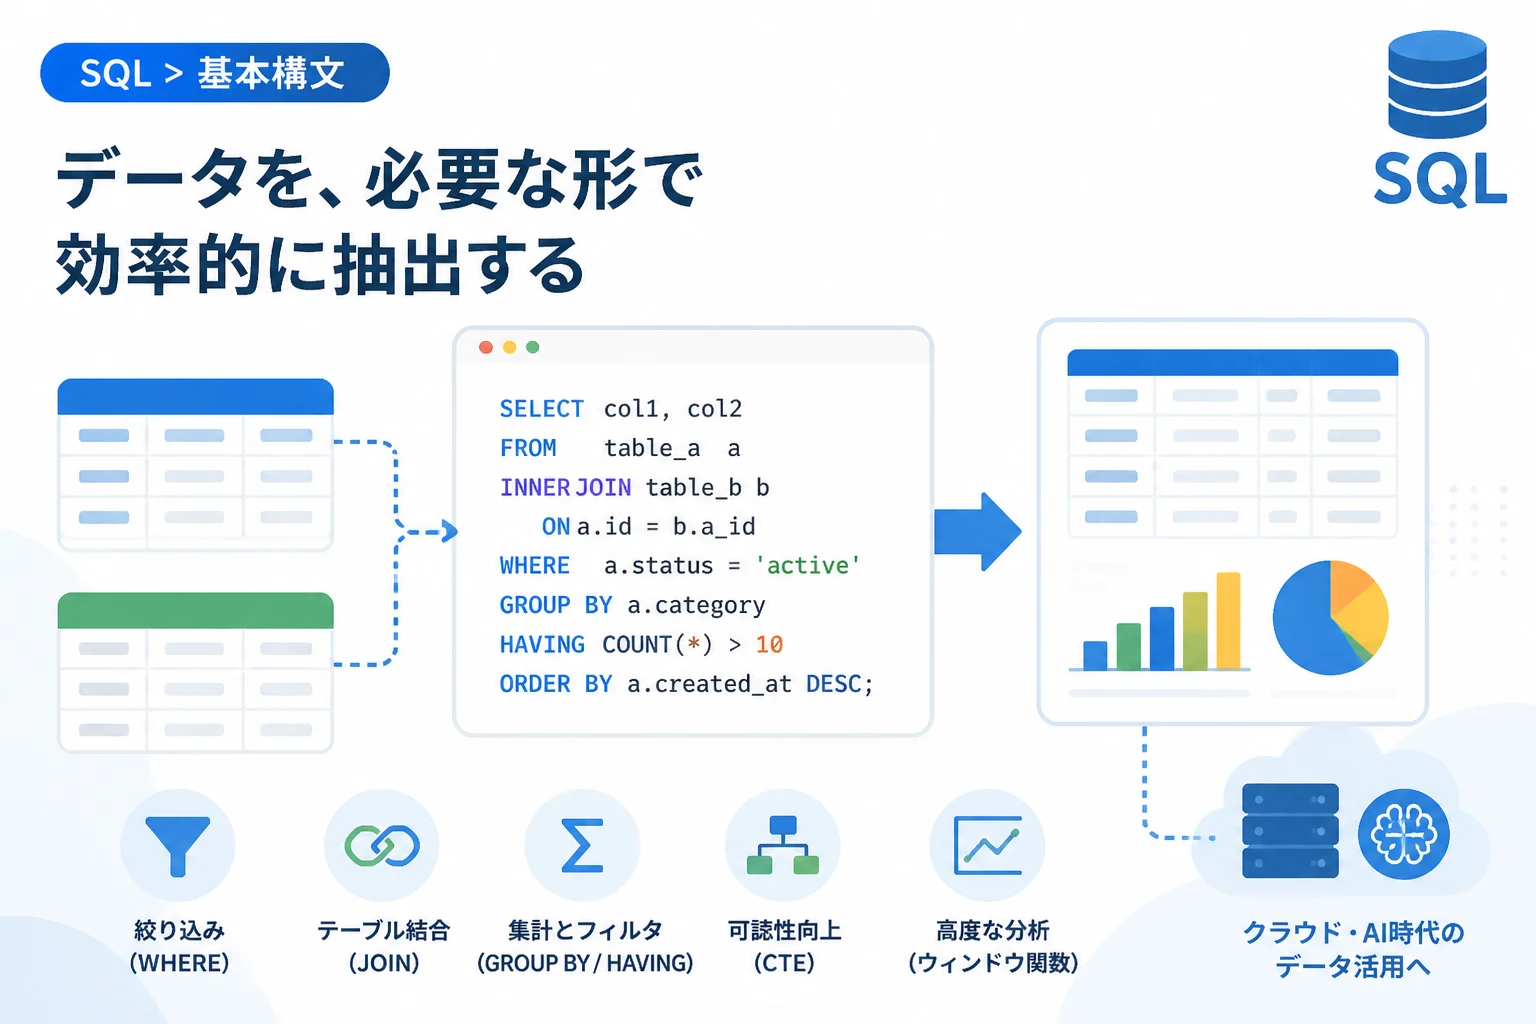
現代のビジネスにおいて、データは「21世紀の石油」とも称されるほど重要な資産となっています。
特にSQLを用いたデータ抽出技術は、蓄積された膨大な情報から価値あるインサイトを引き出すための基本的なスキルです。
2026年の現在、クラウドネイティブなデータ基盤が一般化したことで、SQLの役割はかつてないほど高まっています。
本記事では、実務で即戦力として役立つSQLデータ抽出の基本から、パフォーマンスを劇的に改善する効率的なクエリ作成ルールまでを解説します。
SQLデータ抽出の基礎となるSELECT文の構造
データ抽出の第一歩は、SQLの基本であるSELECT文を正しく理解することから始まります。
データベースに対して「どのテーブルから」「どの列を」「どのような条件で」取得するかを明確に指示する必要があります。
基本となるSELECTとFROM句
最もシンプルなクエリは、特定のテーブルからすべての列を取得する形式です。
しかし、実務においてすべての列を抽出することは避けるべきだとされています。
必要な列名だけを明示することで、ネットワークの負荷を軽減し、処理速度を向上させることができます。
-- ユーザーテーブルからIDと名前のみを抽出する例
SELECT
    user_id,
    user_name
FROM
users;user_id | user_name
--------+----------
1 | 佐藤 太郎
2 | 鈴木 一郎
3 | 高橋 花子WHERE句によるデータのフィルタリング
膨大なデータの中から、特定の条件に合致するレコードのみを抽出するためにWHERE句を使用します。
実務では、日付範囲の指定やステータスの絞り込みなどで頻繁に利用されます。
条件式には、比較演算子 (=, <, >, <>) や論理演算子 (AND, OR, NOT) を組み合わせて複雑なフィルタリングを行うことが可能です。
-- 2026年1月1日以降に登録された有効なユーザーを抽出
SELECT
    user_id,
    user_name,
    registration_date
FROM
    users
WHERE
    registration_date >= '2026-01-01'
    AND status = 'active';
実務で差がつくテーブル結合 (JOIN) のテクニック
実務的なデータベース設計では、データは複数のテーブルに正規化されて保存されています。
そのため、複数のテーブルを結合して必要な情報を一つの結果セットとして抽出する技術が不可欠です。
INNER JOINとLEFT JOINの使い分け
最も多用されるのが INNER JOIN (内部結合) です。
これは、結合する両方のテーブルに存在するデータのみを抽出します。
一方で、LEFT JOIN (左外部結合) は、左側のテーブルにある全データを保持しつつ、右側のテーブルに一致するデータがあれば結合します。
「注文データがある顧客だけを表示したい」のか「注文の有無に関わらず全顧客を表示したい」のかによって、これらを使い分ける必要があります。
-- 注文情報と顧客名を結合して抽出する例
SELECT
    o.order_id,
    c.customer_name,
    o.order_amount
FROM
    orders AS o
INNER JOIN
    customers AS c ON o.customer_id = c.customer_id;
複数テーブルの結合とパフォーマンスへの影響
実務では、3つ以上のテーブルを結合することも珍しくありません。
しかし、結合するテーブルが増えるほど、データベースエンジンの計算コストは増大します。
結合を行う際には、インデックスが貼られている列を結合条件 (ON句) に指定することが鉄則です。
集計とグループ化によるデータ分析
単なるレコードの抽出だけでなく、合計値や平均値を算出する「集計処理」もSQLの得意分野です。
経営指標の算出やレポート作成において、GROUP BY句の活用は避けて通れません。
GROUP BYによるデータの要約
特定のカテゴリごとに数値をまとめたい場合にGROUP BY句を使用します。
例えば、日別の売上合計や部署ごとの平均給与などを算出する際に便利です。
-- カテゴリごとの商品数と平均価格を抽出
SELECT
    category_id,
    COUNT(*) AS product_count,
    AVG(price) AS average_price
FROM
    products
GROUP BY
    category_id;
HAVING句による集計結果のフィルタリング
WHERE句は「集計前」のデータに対してフィルタをかけますが、HAVING句は「集計後」の結果に対してフィルタをかけます。
「売上合計が100万円以上の店舗のみを抽出したい」といったケースでは、HAVING句を使用する必要があります。
-- 売上合計が50,000円を超える顧客を抽出
SELECT
    customer_id,
    SUM(amount) AS total_spent
FROM
    sales
GROUP BY
    customer_id
HAVING
    SUM(amount) > 50000;
可読性と再利用性を高めるCTE (共通テーブル式)
複雑なクエリを作成していると、サブクエリが何重にもなり、自分でも内容を把握できなくなることがあります。
2026年現在のモダンな開発現場では、サブクエリの代わりに CTE (Common Table Expressions) を使用することが推奨されています。
WITH句によるクエリの構造化
WITH句を使用すると、一時的な結果セットに名前を付けて、後続のメインクエリで参照できるようになります。
これにより、クエリを上から下に順番に読み進めることが可能になり、メンテナンス性が劇的に向上します。
-- CTEを使用して、高額注文を行った顧客のリストを抽出する
WITH high_value_orders AS (
    SELECT
        customer_id,
        SUM(amount) AS total_amount
    FROM
        orders
    GROUP BY
        customer_id
    HAVING
        SUM(amount) > 100000
)
SELECT
    c.customer_name,
    hvo.total_amount
FROM
    high_value_orders AS hvo
JOIN
    customers AS c ON hvo.customer_id = c.customer_id;
高度なデータ抽出を実現するウィンドウ関数
行と行の間の関係を計算に用いる「ウィンドウ関数」は、データ分析において非常に強力なツールです。
通常のGROUP BY句と異なり、個々の行を保持したまま、集計値を計算できるのが特徴です。
RANK関数やROW_NUMBER関数の活用
「売上の高い順に順位をつけたい」といったニーズに対して、ウィンドウ関数は簡潔な記述で応えてくれます。
また、PARTITION BY を組み合わせることで、カテゴリ内での順位付けも容易に行えます。
-- 部門ごとに給与が高い順にランキングを付与
SELECT
    employee_name,
    department_id,
    salary,
    RANK() OVER (PARTITION BY department_id ORDER BY salary DESC) AS salary_rank
FROM
    employees;
移動平均や累計の算出
過去数日間の売上の移動平均や、月初の初日からの累計値を算出する場合にもウィンドウ関数が活躍します。
実務におけるトレンド分析やKPI推移のモニタリングには欠かせない技術です。
実務で役立つクエリ作成の最適化ルール
データ抽出のクエリが正しく動くだけでは不十分です。
特にクラウド型データウェアハウス (Snowflake, BigQuery等) を使用している場合、不効率なクエリは高い実行コストと待ち時間をもたらします。
SELECT * を避けるべき真の理由
「とりあえず全部の列を取ってくる」という SELECT * は、実務において最も避けるべきアンチパターンの一つです。
列指定を行うことで、データベースエンジンがスキャンするデータ量を劇的に減らすことができます。
これにより、クエリのレスポンスタイムが短縮されるだけでなく、課金対象となるデータスキャン量を抑制できるメリットがあります。
インデックスを意識したWHERE句の書き方
検索条件に指定する列にインデックスが貼られていても、書き方次第でインデックスが効かなくなることがあります。
例えば、条件式の左辺で関数を使用したり、型変換を行ったりすると、フルスキャンが発生する可能性が高まります。
「列に対する加工は極力避け、定数側を加工する」のがSQL最適化の基本ルールです。
-- NG例:インデックスが効かない可能性がある
SELECT * FROM sales WHERE DATE_FORMAT(sale_date, '%Y-%m') = '2026-01';

-- OK例:インデックスが活用される書き方
SELECT * FROM sales WHERE sale_date >= '2026-01-01' AND sale_date < '2026-02-01';
EXPLAIN文による実行計画の確認
複雑なクエリのパフォーマンスが上がらない場合は、EXPLAIN コマンドを使用して、データベースがどのようにクエリを実行しようとしているかを確認しましょう。
どの結合アルゴリズムが選択されているかや、インデックスが適切に使われているかを視覚的に把握することができます。
2026年における最新のSQLトレンドとデータ抽出
SQLは長い歴史を持つ言語ですが、現在も進化を続けています。
特にAIとの統合が進んでおり、自然言語からSQLを生成するツールも一般的になりました。
ベクトルデータとSQL
近年の生成AIブームにより、ベクトルデータをSQLで扱う機会が増えています。
pgvector などの拡張機能を用いることで、類似画像検索や文書検索をSQLクエリ内で完結させることが可能になっています。
リアルタイムデータストリーミングへの対応
バッチ処理によるデータ抽出だけでなく、ストリーミングデータに対するクエリ実行も重要視されています。
「今この瞬間に何が起きているか」を抽出するためのSQL構文は、今後のデータ分析においてさらに重要度を増すでしょう。
まとめ
SQLを用いたデータ抽出は、単なる命令の記述ではなく、データの構造を理解し、効率的に目的の情報を導き出すプロセスです。
基本的なSELECT文から始め、JOINやGROUP BYをマスターし、さらにはCTEやウィンドウ関数を駆使することで、実務で求められる複雑な要求に応えることができます。
クエリを作成する際は、単に結果を得るだけでなく、可読性、保守性、そしてパフォーマンスの3点を常に意識してください。
正しいルールに基づいたクエリ作成を習慣化することで、データ駆動型の意思決定を支える強力なエンジニア・アナリストへと成長できるはずです。
2026年以降も進化し続けるデータ基盤において、SQLという共通言語を深く理解していることは、あなたのキャリアにとって最大の武器となるでしょう。