
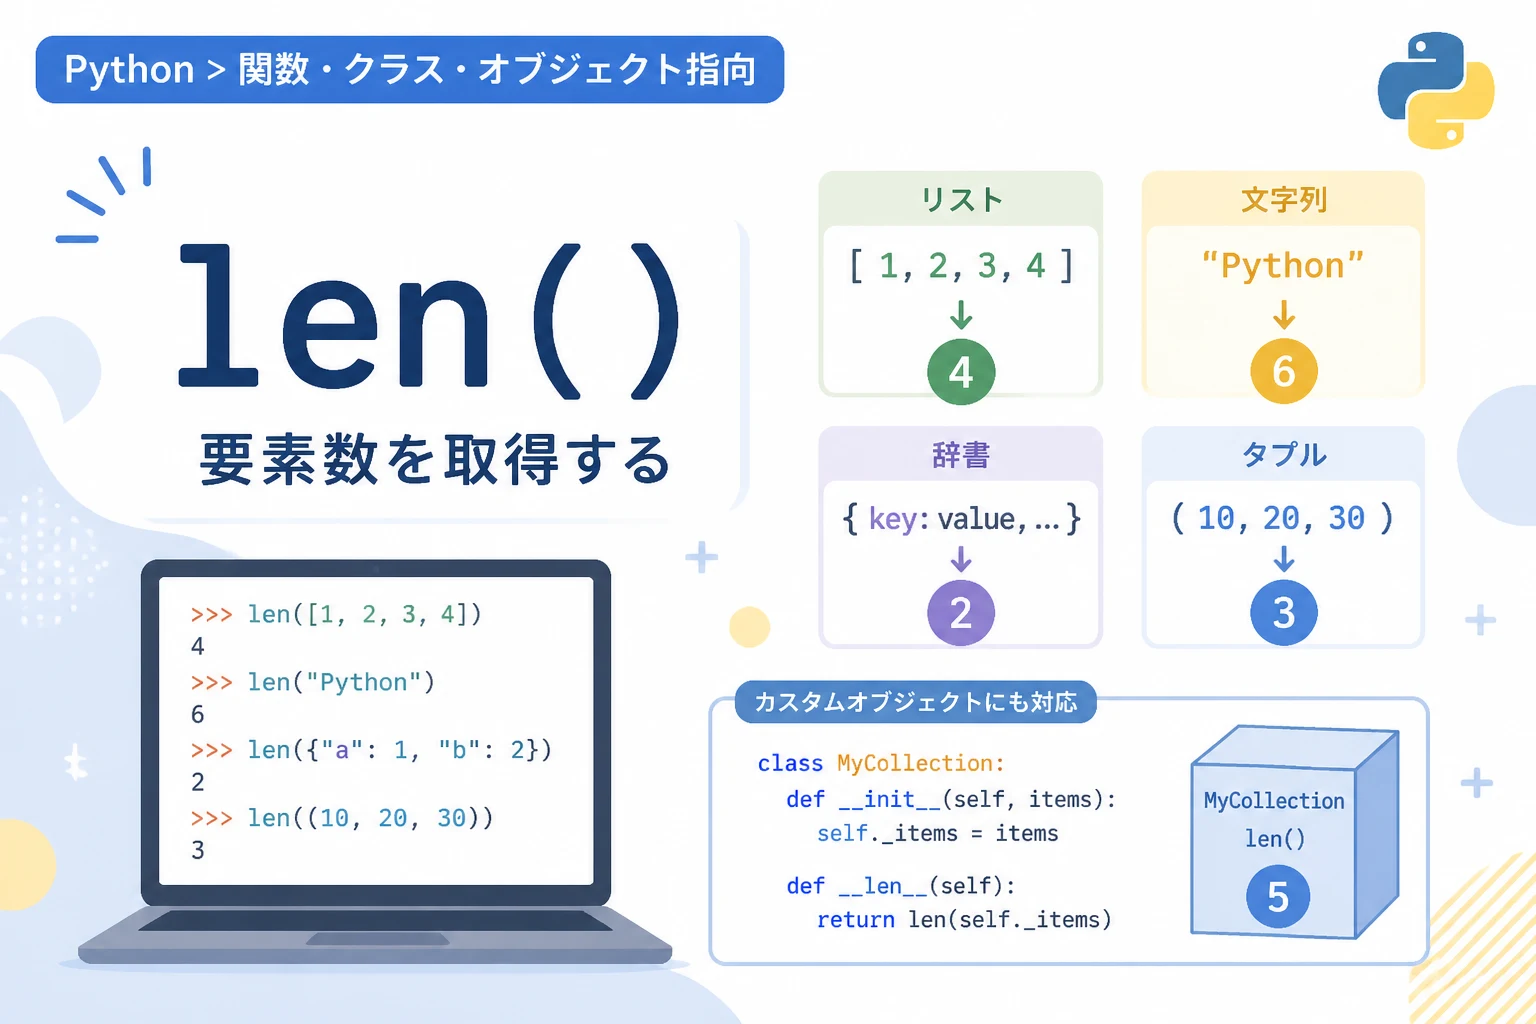
Pythonプログラミングにおいて、データの個数や長さを把握することは非常に頻繁に行われる操作の一つです。
その中心的な役割を担うのが、組み込み関数である len() です。
この関数は、リストや文字列、辞書といったさまざまなデータ型に対して共通のインターフェースで要素数を提供します。
初心者から上級者まで、Pythonを扱う上では避けて通れない非常に重要な関数と言えるでしょう。
本記事では、len() 関数の基本的な使い方から、内部的な仕組み、さらには自作クラスにおけるカスタマイズ方法まで詳しく紹介します。
Pythonのlen関数の基本的な役割
Pythonの len() 関数は、オブジェクトの中に含まれる要素の総数を取得するために使用されます。
関数の名前は「length(長さ)」の略称に由来しており、直感的で覚えやすい名称となっています。
この関数はPythonの組み込み関数として提供されているため、事前のインポート作業などは一切必要ありません。
どのようなデータ構造に対しても同じ len(オブジェクト名) という構文で記述できる点が、Pythonの設計思想である一貫性を表しています。
データ処理の現場では、ループの回数を決定したり、データが空でないかを確認したりする際に頻繁に利用されます。
まずは、最も基本的なデータ型での動作を確認していきましょう。
シーケンス型でのlen関数の活用
Pythonにおけるシーケンス型とは、要素が順番に並んでいるデータ型のことを指します。
リスト、タプル、文字列などがこれに該当し、len() 関数を適用することでその要素数を返します。
リストとタプルの要素数を取得する
リストはPythonで最も多用される動的配列であり、len() を使うことで格納されているアイテムの数を即座に知ることができます。
タプルについても同様で、イミュータブル(変更不能)な性質を持ちながら、リストと同じように要素数を取得可能です。
# リストの要素数を取得する
fruits = ["apple", "banana", "cherry", "orange"]
print(len(fruits))

# タプルの要素数を取得する
numbers = (10, 20, 30)
print(len(numbers))4
3このように、リストの中にいくつのデータが入っているかを数える際に重宝します。
多次元リスト(リストの中にリストがある場合)であっても、len関数が返すのは直下の要素数のみである点に注意してください。
文字列の長さを取得する
文字列に対して len() を使用すると、その文字列に含まれる文字数を返します。
半角文字だけでなく、全角文字や絵文字も1文字としてカウントされるのがPython 3の仕様です。
# 英数字のカウント
text_en = "Hello World"
print(len(text_en))

# 日本語のカウント
text_jp = "こんにちは、Python"
print(len(text_jp))11
10空白(スペース)や記号も、それぞれ1文字として計算に含まれます。
バイト数ではなく文字数を取得するため、多言語対応のアプリケーション開発でも混乱が少ないのが特徴です。
コレクション型でのlen関数の活用
順序を持たないデータ構造である集合(set)や辞書(dict)においても、len() 関数は有効です。
辞書の要素数を取得する
辞書型に len() を適用すると、格納されているキーと値のペアの数が返されます。
キーのリストを取得してから数える必要はなく、直接辞書オブジェクトを渡すだけで十分です。
# 辞書のペア数をカウント
user_info = {
    "name": "Alice",
    "age": 25,
    "email": "alice@example.com"
}
print(len(user_info))3特定のキーが存在するかどうかだけでなく、全体としてどれだけの属性が定義されているかを知るのに役立ちます。
集合の要素数を取得する
集合(set)は、重複した値を保持しないデータ型です。
len() を使うことで、一意な要素がいくつ存在するかを確認できます。
# 重複を含むリストを集合に変換してカウント
raw_data = [1, 2, 2, 3, 3, 3, 4]
unique_data = set(raw_data)
print(len(unique_data))4データのクレンジング作業などで、ユニークな項目の種類を把握する際に非常に便利な手法です。
len関数の内部的な仕組みとパフォーマンス
なぜ len() 関数は、巨大なリストに対しても一瞬で結果を返すことができるのでしょうか。
その理由は、Pythonの組み込みオブジェクトが自身の要素数を内部メモリに保持しているからです。
len() 関数が呼び出された際、Pythonは要素を一つずつ数え上げるようなことはしません。
実際には、オブジェクトが持つ __len__() という特殊メソッドを直接呼び出して、保存されている数値を参照しているだけなのです。
これを計算量の観点で見ると、時間計算量は O(1)、つまり定数時間で動作することを意味します。
要素が10個であっても、1億個であっても、処理にかかる時間はほぼ変わりません。
そのため、パフォーマンスを気にすることなく、ループ内などの頻繁に実行される箇所でも安心して使用できます。
len関数を使用する際の注意点
非常に便利な len() 関数ですが、いくつかの注意点や「使えないケース」が存在します。
イテレータやジェネレータには使用できない
len() は、メモリ上にすべての要素が展開されている、あるいは要素数が確定しているオブジェクトに対してのみ機能します。
一方で、イテレータやジェネレータのように、「次の値を逐次生成する」タイプのオブジェクトには使用できません。
# ジェネレータ式の場合
gen = (x for x in range(10))
# print(len(gen))  # これはTypeErrorを発生させます
ジェネレータは最後まで実行してみるまで全体の個数がわからないため、Pythonはあえて len() をサポートしていません。
もし個数を知る必要がある場合は、一度 list(gen) のようにリストへ変換する必要があります。
ただし、その場合はジェネレータの利点であるメモリ節約の効果が失われる点に留意してください。
Noneや数値型には適用できない
len() 関数に数値(int型やfloat型)や None を渡すと、TypeError が発生します。
数値には「長さ」という概念が存在しないためです。
value = 123
# print(len(value))  # TypeError: object of type 'int' has no len()
プログラムの中で変数が None になる可能性がある場合は、事前にチェックを行うか、例外処理を組み込む必要があります。
カスタムオブジェクトでlen関数を実装する方法
自分自身で定義したクラス(カスタムオブジェクト)に対しても、len() 関数を使えるようにすることができます。
そのためには、クラス内で「__len__」という特殊メソッドを定義します。
これにより、自作のデータ構造であっても、Python標準の関数と親和性の高いコードが書けるようになります。
__len__ メソッドの基本実装
以下の例では、学生のリストを管理するクラスを作成し、その学生数を len() で取得できるようにしています。
class SchoolClass:
    def __init__(self, students):
        self.students = students

    def __len__(self):
        # 内部で保持しているリストの長さを返す
        return len(self.students)

# インスタンス化
my_class = SchoolClass(["Taro", "Hanako", "Jiro"])

# 自作クラスに対してlen()を実行
print(len(my_class))3このように、__len__ を定義するだけで、外部からは標準のリストと同じ感覚で操作できるようになります。
__len__ 実装時の制約
__len__ メソッドは、必ず 0 以上の整数(int)を返さなければなりません。
負の値を返そうとしたり、文字列などを返そうとしたりすると、実行時にエラーとなります。
また、Pythonの内部的な仕様により、返り値は一定の範囲内(通常はシステム上の最大整数値)に収まる必要があります。
実戦的な活用:条件分岐でのlen関数
Pythonでは、len() を使ってコンテナが空かどうかを判定するコードをよく見かけます。
しかし、Pythonの「真偽値テスト」の性質を理解すると、より洗練された記述が可能になります。
明示的な比較と暗黙的な評価
以下の二つのコードは、論理的には同じ動作をします。
my_list = []

# 方法1: len()を使う
if len(my_list) == 0:
    print("リストは空です")

# 方法2: Python的な書き方(推奨)
if not my_list:
    print("リストは空です")
Pythonにおいて、空のリストや辞書、文字列は False と見なされ、要素がある場合は True と見なされます。
公式のスタイルガイド(PEP 8)では、空かどうかの判定には方法2の「暗黙的な真偽値評価」を使用することが推奨されています。
ただし、コードの可読性やチームの規約によっては、あえて len() を使って明示的に 0 と比較することもあります。
データ分析や加工におけるlen関数の応用
データサイエンスの分野でも、len() は基本的なデータ確認ステップで多用されます。
例えば、大規模なテキストデータを処理する際、極端に短い文章や長い文章を除外するフィルタリング処理などが挙げられます。
フィルタリングの例
comments = [
    "最高でした!",
    "よかった",
    "ありがとうございます。非常に参考になりました。また読みます。",
    "ok"
]

# 10文字以上のコメントだけを抽出
long_comments = [c for c in comments if len(c) >= 10]
print(long_comments)['ありがとうございます。非常に参考になりました。また読みます。']このように、リスト内包表記と組み合わせることで、データの質を制御するロジックが簡潔に記述できます。
よくある質問とエラーへの対処法
len() に関して、エンジニアが直面しやすい疑問点を整理しました。
Q: 辞書のネストされた要素も数えられますか?
A: いいえ、len() は直下の階層しかカウントしません。
ネストされた辞書のすべての要素(子要素の合計)を数えたい場合は、再帰的な関数を自作する必要があります。
Q: len()を使わずに要素数を数えるのは非効率ですか?
A: はい、非常に非効率です。
for ループでカウンター変数をインクリメントして数える手法は、Pythonでは避けるべきです。
前述の通り、len() は O(1) で動作するため、これを使わない手はありません。
Q: NumPyの配列やPandasのDataFrameでも使えますか?
A: はい、使用可能です。
ただし、多次元配列を扱うライブラリでは、len() は「最初の次元(行数)」のサイズのみを返します。
全要素数を知りたい場合は、オブジェクトが持つ .size プロパティを使用するのが一般的です。
まとめ
Pythonの len() 関数は、シンプルながらも強力で、言語の根幹を支える機能の一つです。
リストや文字列といった標準的な型から、自作のクラスに至るまで、共通の構文でアクセスできる点は非常に優れています。
また、内部的に __len__ メソッドを呼び出す仕組みによって、高いパフォーマンスが維持されています。
「データの個数を知りたいときは、まず len() を考える」という原則を覚えておけば、効率的なコーディングが可能になります。
ただし、イテレータや特定の型に対する制約があることも忘れずに、適切な場面で使用するようにしましょう。
今回学んだ基礎知識と応用テクニックを活用して、より堅牢なPythonプログラムを構築してください。