
Pythonプログラミングにおいて、データの中に特定の要素が何個含まれているかを正確に把握することは、データ分析やアプリケーション開発の基礎となります。
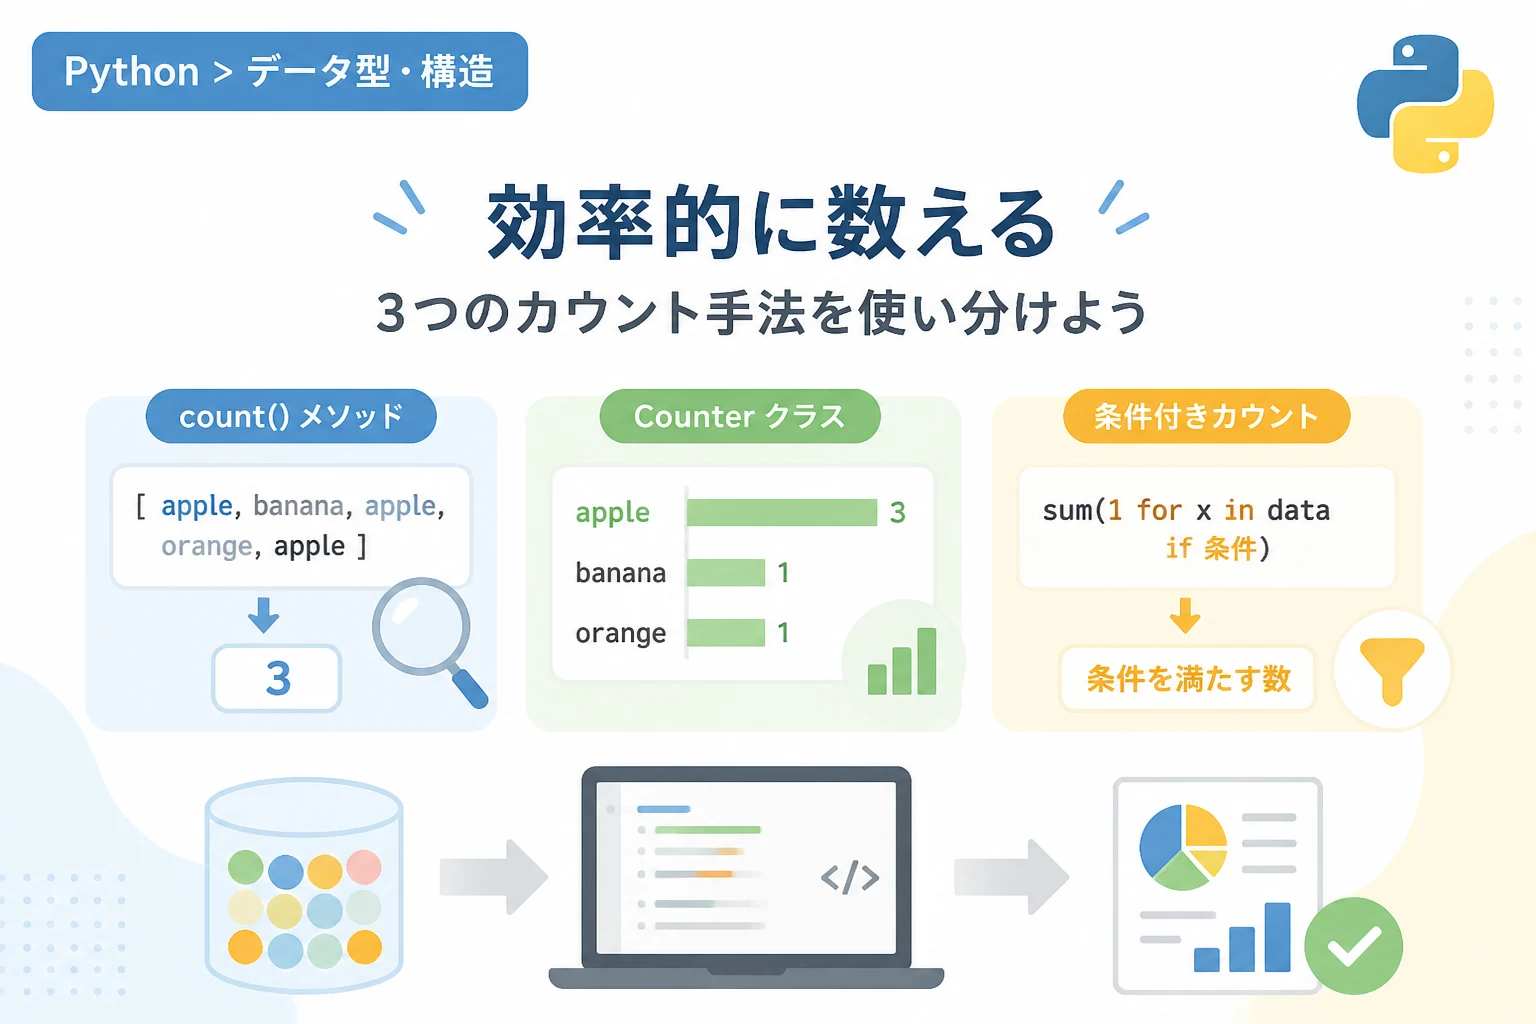
Pythonには、リストや文字列などのシーケンス型に備わっている標準のcountメソッドから、大量のデータを効率的に集計するためのcollections.Counterクラスまで、用途に応じた多彩なツールが用意されています。
本記事では、初心者から実務レベルまで役立つ、Pythonでの要素カウント手法を詳細に解説します。
Pythonのcountメソッドの基本と使い方
Pythonの基本的なデータ型であるリストや文字列には、count()という便利なメソッドが組み込まれています。
このメソッドを使用すると、特定の要素がオブジェクト内にいくつ存在するかを簡単に取得できます。
リスト(list)で要素を数える
リスト型におけるcount()メソッドは、引数に指定した値と一致する要素の数を返します。
以下のサンプルコードでは、リスト内に含まれる数値や文字列の個数を数える方法を示しています。
# リストの定義
numbers = [1, 2, 3, 4, 1, 2, 1, 5, 6, 1]

# 「1」がいくつ含まれているかカウント
count_of_ones = numbers.count(1)

print(f"1の個数: {count_of_ones}")

# 存在しない要素を数えた場合
count_of_ten = numbers.count(10)

print(f"10の個数: {count_of_ten}")1の個数: 4
10の個数: 0リストのcount()メソッドは、完全一致する要素のみをカウントする点に注意してください。
例えば、数値の1をカウントする際に、文字列の"1"が混ざっていても、それらは別物として扱われます。
また、リストの中に別のリストが含まれているネスト構造の場合、count()は直下の要素しか探索しません。
文字列(str)で部分文字列を数える
文字列型のcount()メソッドは、指定した部分文字列(サブストリング)が何回出現するかを数えるために使用されます。
文字列の場合、リストとは異なり「開始位置」と「終了位置」を指定するオプション引数が存在します。
text = "python programming is popular. python is easy to learn."

# 「python」という単語をカウント
word_count = text.count("python")

print(f"pythonの出現回数: {word_count}")

# 範囲を指定してカウント(インデックス0から20の間)
partial_count = text.count("python", 0, 20)

print(f"指定範囲内の出現回数: {partial_count}")pythonの出現回数: 2
指定範囲内の出現回数: 1文字列のcount()で重要な仕様は、重複する部分はカウントされないという点です。
例えば、"aaaaa"という文字列に対して"aaa"をカウントした場合、結果は1となります。
これは、最初の"aaa"を数えた後、探索位置がその次の文字へ移動するためです。
タプル(tuple)でのカウント
タプルもリストと同様にイミュータブル(変更不可)なシーケンス型であり、count()メソッドを保持しています。
使い方はリストと全く同じですが、タプルはデータの書き換えが発生しない場面で使用されるため、静的なデータの集計に適しています。
data_tuple = (10, 20, 30, 10, 40, 10)
print(data_tuple.count(10))3多機能な集計を実現するcollections.Counterクラス
標準のcount()メソッドは単一の要素を数えるのには適していますが、データ全体の頻度分布を調べたい場合には非効率です。
そのような場面で真価を発揮するのが、collectionsモジュールに含まれるCounterクラスです。
Counterクラスの基本的な使い方
Counterクラスは、辞書(dict)のサブクラスとして定義されており、要素をキーに、その出現回数を値として保持します。
イテラブルなオブジェクト(リストや文字列など)を渡すだけで、一括で全要素の個数を集計できます。
from collections import Counter

items = ["apple", "banana", "apple", "cherry", "banana", "apple"]

# Counterオブジェクトの作成
counter = Counter(items)

print(counter)
# 特定の要素の数にアクセス
print(f"appleの数: {counter['apple']}")Counter({'apple': 3, 'banana': 2, 'cherry': 1})
appleの数: 3Counterの大きなメリットは、存在しないキーを指定してもエラーにならず、0を返すという特性にあります。
通常の辞書型であればKeyErrorが発生しますが、Counterなら安全にコードを記述できます。
出現頻度の高い要素を取得する(most_common)
データセットの中で、どの要素が頻繁に現れるかを知りたいことは非常に多いです。
Counter.most_common()メソッドを使用すると、出現回数が多い順に要素を並べたリストを取得できます。
from collections import Counter

text_data = "abracadabra"
char_counter = Counter(text_data)

# 上位3つの要素を取得
top_three = char_counter.most_common(3)

print(top_three)[('a', 5), ('b', 2), ('r', 2)]引数を指定しない場合は、すべての要素を降順で返します。
これはランキング作成や、テキストマイニングにおける頻出語の抽出に極めて有効な手法です。
Counter同士の演算
Counterオブジェクトは、算術演算子を使って加算や減算を行うことが可能です。
複数のデータセットの結果を合算したり、差分を抽出したりする処理が直感的に記述できます。
from collections import Counter

c1 = Counter(a=3, b=1)
c2 = Counter(a=1, b=2)

# 加算(各要素の個数を足す)
print(f"加算結果: {c1 + c2}")

# 減算(各要素の個数を引く、結果が0以下は除外される)
print(f"減算結果: {c1 - c2}")

# 積集合(共通する要素の最小値を保持)
print(f"積集合: {c1 & c2}")

# 和集合(各要素の最大値を保持)
print(f"和集合: {c1 | c2}")加算結果: Counter({'a': 4, 'b': 3})
減算結果: Counter({'a': 2})
積集合: Counter({'a': 1, 'b': 1})
和集合: Counter({'a': 3, 'b': 2})このように、集合論的なアプローチで集計データを操作できるのは、標準のcount()にはない強力な機能です。
効率的なカウント手法の比較と使い分け
プログラミングにおいて、どの手法を選択するかはパフォーマンスに大きく影響します。
ここでは、count()メソッドとCounterクラスの使い分けについて、アルゴリズムの観点から解説します。
計算量の違いに注目する
リストのcount()メソッドをループの中で繰り返し呼び出すと、実行速度が著しく低下する恐れがあります。
なぜなら、list.count(x)を呼び出すたびに、リストの最初から最後まで全要素をチェックする必要があるからです。
これを計算量で表すと、リストの長さをNとしたとき、1回のカウントにO(N)の時間がかかります。
もし、M種類の要素すべてを数えようとしてループ内でcount()を使うと、全体でO(N×M)という非常に重い処理になってしまいます。
大量データにはCounterが最適な理由
一方で、Counterクラスはデータを一度走査するだけで、すべての要素をハッシュテーブル(辞書)に記録します。
この場合の計算量は、データ量Nに対してO(N)で完了します。
要素の種類が多ければ多いほど、Counterを使用した方が劇的に高速になります。
| 手法 | 適した場面 | メリット | デメリット |
|---|---|---|---|
list.count() | 特定の1要素だけを数えたいとき | 手軽、追加インポート不要 | ループ内での使用は非常に遅い |
collections.Counter | 全要素の頻度を調べたいとき | 高速(O(N))、演算が可能 | 標準ライブラリのインポートが必要 |
forループ + dict | 特殊な集計ロジックが必要なとき | 柔軟な処理が可能 | コードが冗長になりやすい |
応用:辞書や条件式を用いた柔軟なカウント
単純な一致だけでなく、特定の条件を満たす要素だけをカウントしたい場合もあります。
そのようなケースでは、ジェネレータ式やsum()関数を組み合わせる手法が有効です。
条件付きカウントのテクニック
例えば、「リストの中から50より大きい数値の個数を知りたい」といった場合には、以下のように記述します。
scores = [45, 88, 72, 90, 56, 30]

# 60点以上の人数をカウント
passing_count = sum(1 for s in scores if s >= 60)

print(f"合格者数: {passing_count}")合格者数: 4これは、条件式が真(True)になるたびに1を生成し、それを合計するという仕組みです。
PythonではTrueは数値の1として扱われるため、sum(s >= 60 for s in scores)と書くことも可能です。
辞書のsetdefaultやdefaultdictの活用
Counterを使わずに、自作のロジックで集計を行いたい場合は、defaultdictが便利です。
これは、存在しないキーにアクセスした際の初期値を自動的に生成してくれる辞書です。
from collections import defaultdict

colors = ["red", "blue", "red", "green", "blue", "red"]
color_counts = defaultdict(int) # 初期値を0に設定

for color in colors:
    color_counts[color] += 1

print(dict(color_counts)){'red': 3, 'blue': 2, 'green': 1}特定の複雑な集計(例:ネストした辞書へのカウントなど)を行いたい場合には、この手法がよく用いられます。
実戦で役立つカウント手法の具体的なユースケース
ここからは、実際の開発現場でよく遭遇するシチュエーションを例に、カウント手法をどう適用するかを見ていきましょう。
ログファイルからのエラー発生回数の抽出
大量のログメッセージから特定のキーワード(”ERROR”など)を数える処理は、システム運用で欠かせません。
ファイルオブジェクトはイテラブルであるため、そのままCounterに渡したり、ループでカウントしたりできます。
# ダミーのログデータ
logs = [
    "INFO: System started",
    "ERROR: Connection failed",
    "INFO: Retrying...",
    "ERROR: Connection failed",
    "WARNING: Slow response"
]

# ERRORを含む行を数える
error_count = sum(1 for line in logs if "ERROR" in line)
print(f"エラー行数: {error_count}")
テキストデータ内の単語出現頻度の分析
自然言語処理の初期段階として、文章を単語に分割し、それぞれの出現回数を集計することがよくあります。
split()メソッドとCounterを組み合わせることで、簡単に単語ランキングを作成できます。
from collections import Counter
import re

text = "Python is great. Python is fast. Learning Python is fun."

# 記号を除去して小文字化し、単語に分割
words = re.findall(r'\w+', text.lower())

# 単語の出現回数を集計
word_freq = Counter(words)

print(word_freq.most_common(2))[('python', 3), ('is', 3)]パフォーマンスを最大化するためのアドバイス
大規模なデータを扱う際には、メモリ消費量と実行速度のバランスを考慮する必要があります。
Counterは非常に便利ですが、要素の種類が数千万件に及ぶ場合、それらすべてをメモリ上に保持するため、メモリ不足を引き起こす可能性があります。
そのような場合は、外部ライブラリのPandasやNumPyを活用することを検討してください。
例えば、Pandasのvalue_counts()メソッドは、非常に高速かつ効率的にデータの集計を行うことができます。
しかし、標準ライブラリだけで完結させたい場合や、比較的小規模なデータの処理であれば、今回紹介したCounterやcount()で十分対応可能です。
プログラミングの学習初期では、まずcount()で「正しく数える」ことを覚え、次にCounterで「効率的に集計する」ことを目指すと良いでしょう。
特にCounterのmost_commonや演算機能は、コードを簡潔にするだけでなく、意図が伝わりやすい「Pythonic」な記述を実現します。
まとめ
Pythonで要素の個数を数える方法は多岐にわたりますが、状況に応じた最適な選択が重要です。
リストや文字列に含まれる単一の要素を数えるなら、手軽なcount()メソッドが最適です。
一方で、データセット全体の分布を調査したり、複数の集計結果を計算したりする場合には、collections.Counterが非常に強力な武器となります。
また、複雑な条件が必要な際はsum()関数とジェネレータ式を組み合わせることで、柔軟なカウントが可能になります。
本記事で紹介したテクニックを使い分け、効率的で読みやすいPythonコードを作成していきましょう。
集計処理の効率化は、プログラム全体のパフォーマンス向上に直結するため、ぜひ積極的に活用してください。