
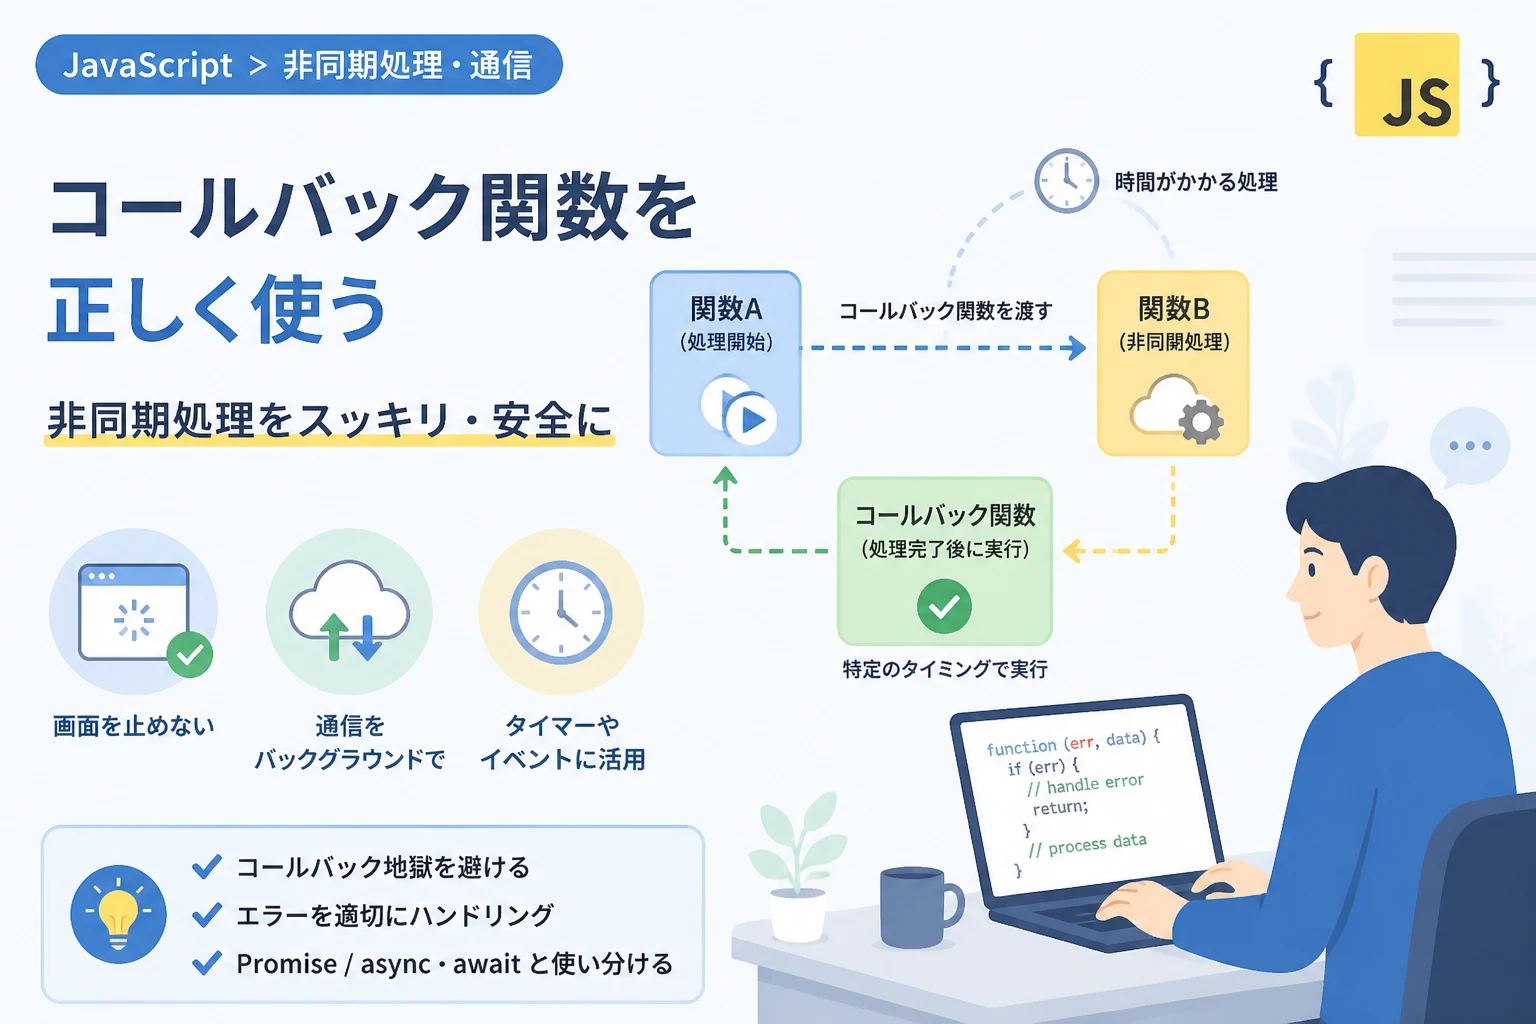
JavaScriptを学ぶ上で、避けて通れない重要な概念の一つが「コールバック関数」です。
モダンなJavaScript開発においては、Promiseやasync/awaitが主流となっていますが、その根底にある仕組みを理解するためにはコールバックの知識が欠かせません。
この記事では、JavaScriptにおけるコールバック関数の基本から実戦的な活用方法、さらには混乱を防ぐための設計指針までを詳しく解説します。
コールバック関数の定義と基本的な仕組み
コールバック関数とは、他の関数に引数として渡される関数のことを指します。
JavaScriptでは関数が「第一級オブジェクト」として扱われるため、数値や文字列と同じように変数に代入したり、関数の引数として受け渡したりすることが可能です。
引数として渡された関数は、受け取り側の関数内で特定のタイミングに到達した際に「呼び出し(コールバック)」されます。
この仕組みを利用することで、処理の順序を制御したり、特定の処理が終わった後に別の処理を実行させたりすることができます。
まずは、最もシンプルなコールバック関数の記述例を見てみましょう。
// コールバック関数として渡される関数
function greet(name) {
    console.log("こんにちは、" + name + "さん!");
}

// 他の関数を引数に受け取る関数(高階関数)
function processUserInput(callback) {
    const name = "ユーザー";
    // 受け取った関数を実行する
    callback(name);
}

// 実行時に関数名を渡す
processUserInput(greet);こんにちは、ユーザーさん!この例では、processUserInput関数が引数としてgreet関数を受け取り、内部で実行しています。
このように、関数を引数に取る関数を高階関数と呼びます。
コールバック関数は、特定のイベントが発生したときや、データの処理が完了したときに実行される「予約された処理」のような役割を果たします。
なぜJavaScriptでコールバックが必要なのか
JavaScriptにおいてコールバックが必要とされる最大の理由は、この言語がシングルスレッドで動作するという特性を持っているからです。
シングルスレッドとは、一度に一つの処理しか実行できない仕組みのことを指します。
もし通信処理やファイルの読み込みといった時間のかかる処理を同期的に実行してしまうと、その処理が終わるまでブラウザの画面がフリーズしてしまいます。
このような問題を回避するために、JavaScriptでは「非同期処理」が多用されます。
非同期処理では、時間のかかる処理の完了を待たずに次のコードを実行し、処理が終わったタイミングでコールバック関数を呼び出します。
これにより、ユーザーインターフェースをブロックすることなく、背後で重い処理を進めることが可能になります。
同期処理と非同期処理の違い
同期処理と非同期処理におけるコールバックの挙動の違いを理解するために、以下の表を参考にしてください。
| 処理方式 | 特徴 | メリット | デメリット |
|---|---|---|---|
| 同期処理 | コードが上から順に一つずつ実行され、完了するまで次へ進まない。 | 流れが予測しやすく、デバッグが容易。 | 重い処理があると、全体の動作が停止(ブロック)する。 |
| 非同期処理 | 重い処理をバックグラウンドで実行し、完了後に通知を受け取る。 | ユーザー体験を損なわず、効率的にリソースを使える。 | 実行順序が複雑になりやすく、エラーハンドリングに工夫が必要。 |
現代のウェブアプリケーションでは、APIからのデータ取得やタイマー処理、ユーザーのクリック操作への反応など、至る所で非同期処理が使われています。
これらすべての動作を支えているのが、コールバックという基本的な仕組みなのです。
実戦で役立つコールバック関数の記述パターン
コールバック関数には、いくつかの記述パターンが存在します。
開発の現場では、用途に応じて適切な書き方を選択することが求められます。
アノニマス関数(匿名関数)による記述
名前を持たない関数を直接引数に記述する方法です。
一度しか使わない処理を記述する場合に非常に便利で、コードを簡潔に保つことができます。
setTimeout(function() {
    console.log("3秒経過しました");
}, 3000);
アロー関数による記述
ES6以降で導入されたアロー関数は、コールバックを記述する際のスタンダードとなっています。
functionキーワードを省略できるだけでなく、thisの拘束に関する挙動が異なるため、クラス内でのメソッド利用時などにも多用されます。
setTimeout(() => {
    console.log("アロー関数での実行です");
}, 2000);
特に引数が一つの場合は括弧を省略できるなど、さらに短く書くことが可能です。
配列操作におけるコールバックの活用
JavaScriptの配列操作メソッドの多くは、コールバック関数を引数に取ります。
これらを使いこなすことで、複雑なデータの加工を宣言的に記述できるようになります。
Array.prototype.forEach
配列の各要素に対して、順番にコールバック関数を実行します。
const fruits = ["りんご", "バナナ", "オレンジ"];

fruits.forEach((item, index) => {
    console.log(`${index + 1}番目の果物は${item}です`);
});1番目の果物はりんごです
2番目の果物はバナナです
3番目の果物はオレンジですArray.prototype.map
各要素に対してコールバックを実行し、その結果から新しい配列を生成します。
元の配列を変更しない(イミュータブルな)操作として、Reactなどのモダンフレームワークで頻繁に使用されます。
const numbers = [1, 2, 3];
const doubleNumbers = numbers.map(num => num * 2);

console.log(doubleNumbers);[2, 4, 6]Array.prototype.filter
コールバック関数がtrueを返した要素だけを抽出して新しい配列を作成します。
const scores = [45, 80, 60, 90, 30];
const passingScores = scores.filter(score => score >= 60);

console.log(passingScores);[80, 60, 90]非同期処理におけるコールバックの課題:コールバック地獄
コールバック関数は非常に強力ですが、複数の非同期処理を連続して行う場合に大きな課題に直面することがあります。
それがコールバック地獄(Callback Hell)と呼ばれる現象です。
例えば、「ユーザー情報を取得し、その後に投稿一覧を取得し、さらにその投稿へのコメントを取得する」という処理を考えてみましょう。
getUser(userId, (user) => {
    getPosts(user.id, (posts) => {
        getComments(posts[0].id, (comments) => {
            console.log(comments);
            // さらに処理が続くと右側にネストが深まっていく
        });
    });
});
このように、関数の中にさらに関数を入れ子にしていくと、コードの可読性が著しく低下します。
また、各ステップでのエラーハンドリングを個別に行う必要があり、バグの原因にもなりやすいのが欠点です。
この問題を解決するために、現在のJavaScriptではPromiseやasync/awaitといった構文が導入されました。
しかし、これらの新しい仕組みも、内部的にはコールバックの概念を洗練させたものであることを忘れてはいけません。
コールバック関数を安全に使うための実戦テクニック
実務でコールバック関数を設計・利用する際には、混乱を避けるためにいくつかのルールを守る必要があります。
1. エラー優先コールバック(Error-First Callback)
Node.jsの慣習として広く知られているパターンです。
コールバック関数の第一引数に必ず「エラーオブジェクト」を渡し、第二引数以降に「成功時のデータ」を渡します。
function fetchData(id, callback) {
    if (!id) {
        // 失敗時は第一引数にエラーを渡す
        callback(new Error("IDが必要です"), null);
        return;
    }
    // 成功時は第一引数をnullにする
    const data = { id: id, name: "サンプルデータ" };
    callback(null, data);
}

fetchData(1, (error, data) => {
    if (error) {
        console.error("エラーが発生しました:", error.message);
        return;
    }
    console.log("成功:", data.name);
});
このルールを徹底することで、非同期処理におけるエラーの見落としを劇的に減らすことができます。
2. コールバックが「一度だけ」呼ばれることを保証する
自作の関数にコールバックを渡す場合、条件分岐によってコールバックが二回呼ばれたり、逆に一度も呼ばれなかったりすることがないよう注意が必要です。
特にif文の分岐内でコールバックを呼び出した後は、returnを忘れないようにしましょう。
一回の処理に対してコールバックが一回だけ実行される設計は、プログラムの予測可能性を高めます。
3. `this`のコンテキストに注意する
オブジェクトのメソッドをコールバックとして渡す際、thisが意図しない値を指してしまうことがあります。
これを防ぐためには、.bind(this)を使用するか、アロー関数を使ってコンテキストを固定する必要があります。
const user = {
    name: "田中",
    sayHello: function() {
        console.log("こんにちは、" + this.name + "です");
    }
};

// 誤った使い方:thisが失われる
setTimeout(user.sayHello, 1000);

// 正しい使い方:アロー関数でラップする
setTimeout(() => user.sayHello(), 1000);
現代のJavaScriptにおける使い分け:コールバック vs Promise
2026年現在の開発現場において、コールバック関数とPromise(およびasync/await)をどのように使い分けるべきでしょうか。
基本的には、「一度きりの非同期処理」にはPromiseやasync/awaitを使い、「繰り返し発生するイベント」にはコールバックを使うのがベストプラクティスです。
| 用途 | 推奨される手法 | 理由 |
|---|---|---|
| API通信・ファイル読み込み | async / await | 処理の流れが直線的で読みやすいため。 |
| クリック・スクロールなどのイベント | コールバック関数 | イベントが発生するたびに実行する必要があるため。 |
| 配列の繰り返し処理 | コールバック関数 | 高階関数の引数として簡潔に記述できるため。 |
| リアルタイム通信(WebSocket等) | コールバック関数 | メッセージ受信のたびに処理を走らせるため。 |
このように、コールバック関数は決して「古い技術」ではなく、適材適所で使い分けるべき現役の仕組みです。
パフォーマンスとメモリ管理の観点
コールバック関数、特にイベントリスナーとして使用する場合には、メモリ管理に気を配る必要があります。
大量のコールバック関数を登録したままにすると、メモリリークの原因となり、アプリケーションの動作が重くなる可能性があるからです。
例えば、ページ遷移時に不要になったイベントリスナーは、適切に削除することが推奨されます。
function onScroll() {
    console.log("スクロールされました");
}

// 登録
window.addEventListener("scroll", onScroll);

// 不要になったら削除(登録時と同じ関数参照を渡す必要がある)
window.removeEventListener("scroll", onScroll);
匿名関数をリスナーに直接渡してしまうと、後から削除することができなくなるため、永続的に監視が必要な場合を除き、関数に名前を付けて定義することが実戦的なテクニックと言えます。
まとめ
JavaScriptのコールバック関数は、言語の核となる非同期処理や柔軟な関数操作を支える重要な仕組みです。
関数を引数として渡すというシンプルながらも強力なこの機能により、開発者は多様なロジックを効率的に組み立てることができます。
一方で、ネストが深くなるコールバック地獄やエラーハンドリングの難しさ、thisの参照問題など、注意すべき点も少なくありません。
現代のJavaScript開発では、以下のポイントを意識してコールバックを活用しましょう。
- 配列操作メソッドでは積極的に活用し、宣言的なコードを目指す。
- 非同期処理の連鎖が必要な場合は、Promiseやasync/awaitへの書き換えを検討する。
- エラー優先コールバックのパターンを守り、堅牢なエラーハンドリングを行う。
- イベントリスナーとしての利用時には、メモリリークを防ぐために適切な解除を行う。
これらの基礎と応用をしっかりとマスターすることで、非同期処理に強い、高品質なJavaScriptプログラムを書くことができるようになるはずです。
コールバック関数を正しく理解し、2026年以降のモダンな開発シーンにおいても、混乱のないスマートなコーディングを実践していきましょう。