
Rustは、メモリ安全性を保証しながら高パフォーマンスなソフトウェアを開発できる言語として、2026年現在もシステム開発の最前線で活用されています。
Rustの学習を進める上で、多くの開発者が最初に直面する壁の一つが、所有権(Ownership)とデータの複製に関する概念です。
特にCloneトレイトは、データのコピーを明示的に行うための重要な仕組みであり、その性質を正しく理解することはプログラムの効率に直結します。
本記事では、Cloneトレイトの基本的な使い方から、Copyトレイトとの決定的な違い、そしてメモリ効率を意識した実践的な実装方法までを詳しく解説します。
Rustにおけるデータの複製とCloneトレイト
Rustにおける「複製」は、他のプログラミング言語に比べて非常に厳格に管理されています。
デフォルトの状態では、代入操作を行うとデータの所有権が移動(Move)するため、元の変数を利用することはできなくなります。
この挙動を防ぎ、同じ内容を持つ別のインスタンスを生成するために用意されているのがCloneトレイトです。
Cloneトレイトの定義と役割
Cloneトレイトは、オブジェクトのディープコピー(Deep Copy)を行うための共通インターフェースを提供します。
標準ライブラリで提供されており、clone()メソッドを呼び出すことで、その型の新しいインスタンスが作成されます。
このプロセスでは、ヒープ領域に確保されたメモリも新しく割り当てられ、中身のデータが物理的にコピーされます。
したがって、複製された後の二つのオブジェクトは、メモリ上の異なるアドレスを指し、互いに独立した存在となります。
明示的な呼び出しの必要性
Rustのデザイン哲学において、コストのかかる操作は明示的に記述するという原則があります。
メモリの再確保やデータの走査を伴うディープコピーは、パフォーマンスに影響を与える可能性があるため、暗黙的に行われることはありません。
開発者がコード内で.clone()と記述することで、意図的にリソースを消費して複製を作っていることを示すことができます。
これにより、コードレビューの際にもパフォーマンスのボトルネックを特定しやすくなるというメリットがあります。
CloneとCopyの決定的な違い
Cloneと混同されやすい概念にCopyトレイトがありますが、これらは性質が大きく異なります。
この違いを正しく理解していないと、不必要なメモリ消費やコンパイルエラーの原因となります。
Copyトレイトによる暗黙的な複製
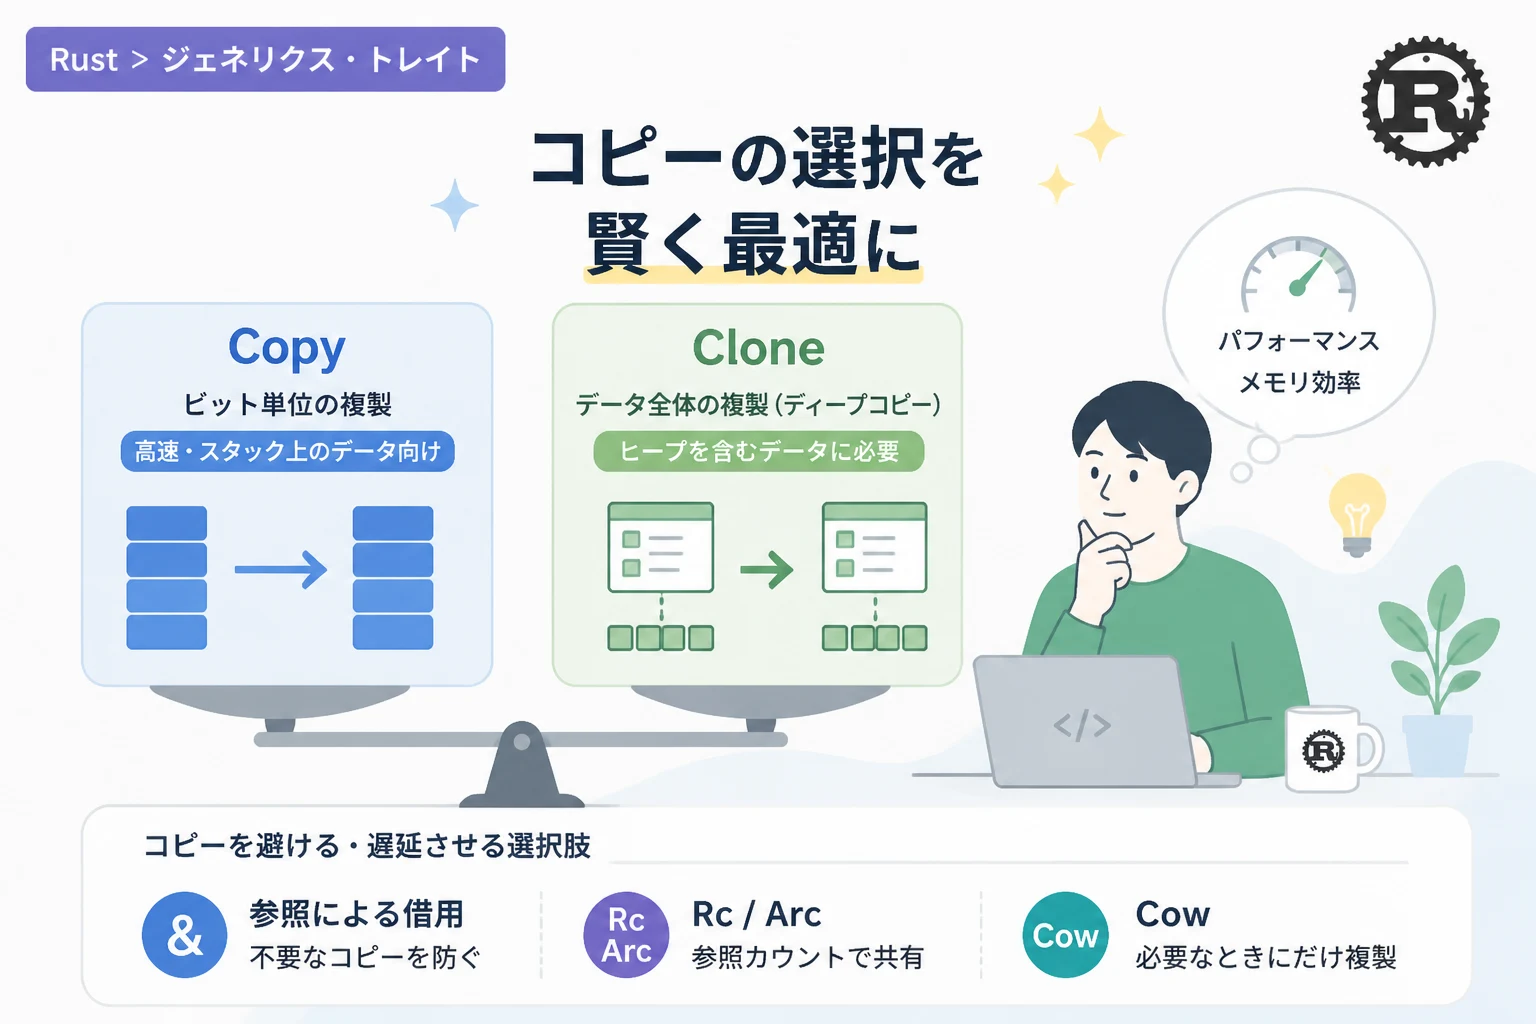
Copyトレイトは、スタック上のデータをビット単位でコピー(Bitwise Copy)することを意味します。
整数型(i32、u64など)や浮動小数点型、ブール型などのプリミティブ型は、このCopyトレイトを実装しています。
これらの型はサイズが小さく固定されているため、コピーのコストが極めて低く、代入時に所有権が移動せずに自動的に複製が行われます。
一方で、ヒープメモリを管理するStringやVec<T>はCopyトレイトを実装することができません。
所有権の移動(Move)と複製の挙動
Copyを実装していない型の場合、代入は「移動」として扱われます。
以下のコード例で、Cloneが必要になる具体的な場面を確認してみましょう。
// String型はCopyではないため、移動が発生する
let s1 = String::from("Hello");
let s2 = s1; // ここでs1の所有権がs2に移動する

// println!("{}", s1); // s1はもう有効ではないためコンパイルエラー

// clone()を使用すれば、独立した複製が作られる
let s3 = String::from("World");
let s4 = s3.clone();

println!("s3: {}, s4: {}", s3, s4); // 両方利用可能s3: World, s4: Worldこの例では、s1をs2に代入した時点で、s1は無効な状態となります。
しかし、s3に対して.clone()を呼び出すことで、新しいメモリ領域に”World”という文字列がコピーされ、s3とs4が共存できるようになります。
スタックとヒープのメモリ構造から見る違い
メモリ構造の観点から見ると、Copyはスタック上の固定長データを複製するだけで完了します。
対してCloneは、スタック上のポインタ情報だけでなく、ポインタが指し示しているヒープ領域のデータ本体まで複製します。
この「深さ」の違いが、実行時のオーバーヘッドの差となって現れます。
表にまとめると以下のようになります。
| 特徴 | Cloneトレイト | Copyトレイト |
|---|---|---|
| 複製の仕組み | 任意の処理(通常はディープコピー) | ビット単位の単純コピー |
| 呼び出し方法 | 明示的(.clone()) | 暗黙的(代入のみ) |
| 実装可能な型 | ほぼ全ての型 | スタックのみで完結する型 |
| パフォーマンス | 低速(ヒープ再確保を伴う場合) | 高速(CPU命令レベル) |
メモリ効率を最大化するCloneの実装手法
Rustでは「何でもclone()すれば解決する」という考え方は、パフォーマンスの低下を招きます。
効率的なプログラムを書くためには、いつクローンし、いつ回避すべきかを見極める設計能力が求められます。
不要なclone()を避けるための設計思想
最も基本的な最適化は、借用(Borrowing)を活用することです。
関数の引数としてデータを渡す際、所有権が必要ない場合は&T(不変の参照)を使用します。
これにより、データを複製することなく、メモリ上の同じ場所にアクセスさせることが可能になります。
特に大規模な構造体や長いリストを扱う場合、参照渡しにするだけで劇的に速度が改善されます。
スマートポインタを活用した共有
どうしても複数の場所で同じデータを所有したいが、重いクローンは避けたいというケースがあります。
そのような場面では、Rc<T>やArc<T>といったスマートポインタが有効です。
これらの型に対してclone()を呼び出すと、データ本体はコピーされず、参照カウントが増加するだけになります。
use std::sync::Arc;

// 重いデータをArcで包む
let massive_data = Arc::new(vec![0; 1000000]);

// clone()を呼んでも、参照カウントが増えるだけでデータはコピーされない
let data_ref1 = Arc::clone(&massive_data);
let data_ref2 = Arc::clone(&massive_data);

println!("Reference Count: {}", Arc::strong_count(&massive_data));Reference Count: 3マルチスレッド環境であればArcを、シングルスレッドであればRcを選択することで、安全かつ低コストでデータを共有できます。
Cow(Copy-on-Write)による動的な最適化
std::borrow::Cow(Copy-on-Write)は、「必要になるまでクローンを遅延させる」ための優れた仕組みです。
通常は読み取り専用の参照として振る舞い、書き込み操作が必要になった瞬間だけデータをクローンして自身のものにします。
これにより、変更が不要なケースではメモリを節約し、変更が必要なケースでは安全にデータを操作するという柔軟な実装が可能になります。
Cloneトレイトをカスタマイズする高度な実装
Rustの多くの型では、アトリビュートを使用することで簡単にCloneを実装できますが、時には手動での実装が必要になることもあります。
派生(derive)による自動実装の仕組み
構造体や列挙型の定義の前に #[derive(Clone)] を記述することで、コンパイラが自動的にCloneトレイトを実装してくれます。
この自動実装は、構造体の各フィールドに対して再帰的にclone()を呼び出すという内容になります。
したがって、全てのフィールドがCloneを実装している必要があります。
#[derive(Clone, Debug)]
struct User {
    id: u64,
    username: String,
    active: bool,
}

fn main() {
    let user1 = User {
        id: 1,
        username: String::from("rust_user"),
        active: true,
    };

    let user2 = user1.clone();
    println!("{:?}", user2);
}
手動実装が必要なケースとその手法
特定のフィールドだけを複製したくない場合や、複製時に独自のロジック(ログ出力やIDの再発行など)を挟みたい場合は、手動で実装します。
以下の例では、Clone時に必ず新しいIDを割り振る特別な挙動を定義しています。
#[derive(Debug)]
struct Session {
    id: u32,
    data: String,
}

impl Clone for Session {
    fn clone(&self) -> Self {
        // IDは複製せず、新しい値を設定する
        println!("Custom cloning logic executed for session {}", self.id);
        Session {
            id: self.id + 1000,
            data: self.data.clone(),
        }
    }
}

fn main() {
    let session1 = Session { id: 1, data: String::from("Secret") };
    let session2 = session1.clone();

    println!("Original: {:?}, Cloned: {:?}", session1, session2);
}Custom cloning logic executed for session 1
Original: Session { id: 1, data: "Secret" }, Cloned: Session { id: 1001, data: "Secret" }このように、impl Clone for 型名という形でcloneメソッドを定義することで、ビジネスロジックに基づいた柔軟な複製処理を記述できます。
実践的なコード例で学ぶCloneの挙動
実際のアプリケーション開発において、Cloneがどのようにメモリに影響を与えるかをより深く掘り下げます。
例えば、大規模なベクタを扱う関数の戻り値でclone()を使用すると、実行時間に目に見える変化が生じることがあります。
fn process_data(input: &Vec<i32>) -> Vec<i32> {
    // 内部でフィルタリングなどの処理を行う
    // 戻り値として新しいベクタを返す必要がある場合、cloneが必要になることがある
    let mut result = input.clone();
    result.push(999);
    result
}

fn main() {
    let original = vec![1, 2, 3, 4, 5];
    let modified = process_data(&original);

    println!("Original: {:?}", original);
    println!("Modified: {:?}", modified);
}上記のコードは正しく動作しますが、もしoriginalが数百万要素を含んでいる場合、input.clone()は非常に重い処理となります。
このような場合、可能であればイテレータを介して遅延評価を行うか、所有権を直接渡して破壊的に変更するといった設計の変更を検討すべきです。
パフォーマンスチューニングとCloneの関係
Rustのプロファイリングツール(cargo flamegraphなど)を使用すると、ボトルネックの多くがclone()呼び出しに集中していることが判明することがあります。
特にループ内でのclone()は避けるべきアンチパターンです。
「なぜここでクローンが必要なのか?」という問いを常に自分に投げかけることが、高品質なRustコードを書くための第一歩となります。
多くの場合、構造体の設計を見直したり、ライフタイムアノテーションを適切に使用したりすることで、クローンを排除できる可能性があります。
また、2026年の最新のコンパイラ最適化技術をもってしても、明示的なディープコピーのコストを完全にゼロにすることは不可能です。
そのため、ゼロコスト抽象化を追求するRustプログラマにとって、Cloneの制御は永遠のテーマとも言えます。
まとめ
RustのCloneトレイトは、データの独立性を保つための強力なツールですが、その利便性の裏にはメモリ消費と計算コストが隠れています。
Copyトレイトがスタック上の単純な複製を担うのに対し、Cloneはヒープ領域を含む完全な複製を担うという役割分担を明確に意識しましょう。
開発の初期段階では、コンパイルを通すためにclone()を多用してしまうこともありますが、慣れてきたら参照やスマートポインタ、Cowを駆使して最適化を図ることが重要です。
正しい複製の知識を身につけることで、Rustの持つポテンシャルを最大限に引き出した、堅牢で高速なアプリケーションを構築できるようになります。
本記事で紹介した実装例や最適化の手法を、ぜひ日々の開発に役立ててください。