
Pythonは、データ分析やWebスクレイピング、業務効率化など幅広い分野で活用されているプログラミング言語です。
膨大なテキストデータの中から、特定のパターンに一致する文字列を抽出する作業は、日常的なプログラミングにおいて欠かせないプロセスといえます。
このような文字列操作において強力な武器となるのが、Pythonの標準ライブラリであるreモジュールに含まれるfindall関数です。
正規表現を自在に操ることができれば、複雑な検索条件であっても、驚くほど短時間で正確に目的の情報を手に入れることが可能になります。
本記事では、初心者の方から実務でさらに効率化を図りたい方までを対象に、findallの基本的な使い方から応用テクニックまで詳しく解説します。
Pythonにおける正規表現とfindallの役割
正規表現とは、特定の文字の組み合わせをパターンとして表現するための記述方法です。
Pythonで正規表現を扱うには、標準で提供されているreモジュールをインポートして使用する必要があります。
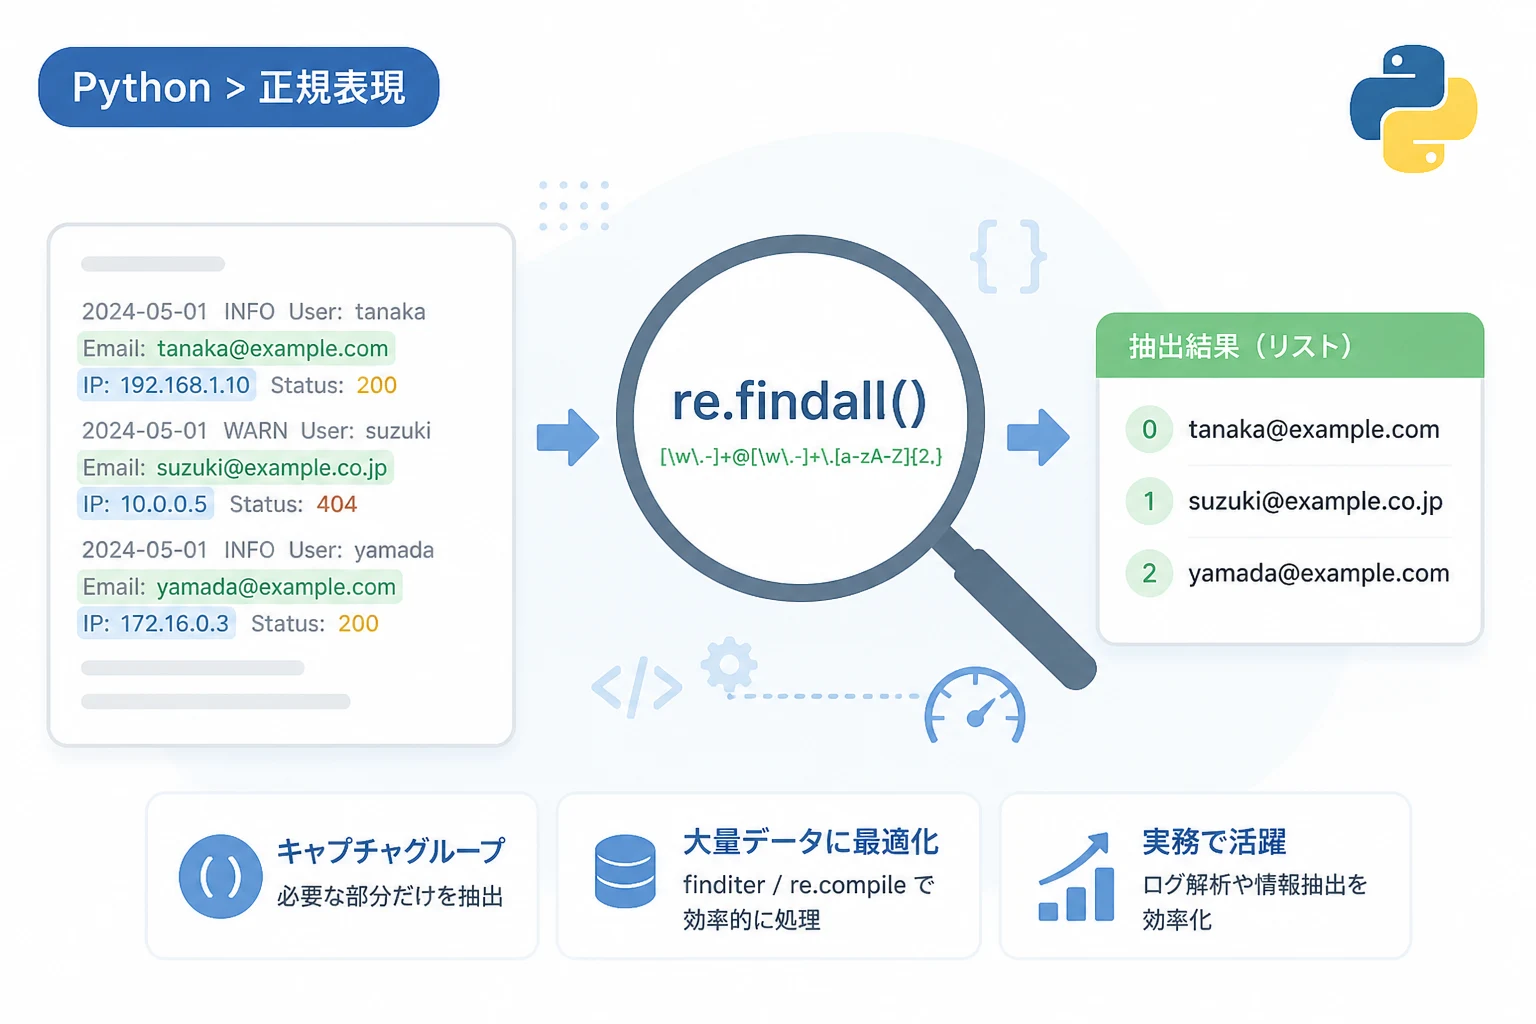
数ある正規表現メソッドの中でも、findallは「一致するすべての部分」をリスト形式で取得するという特徴を持っています。
他のメソッドであるsearchやmatchは、最初に見つかった箇所のみを返しますが、findallはテキスト全体をスキャンしてくれます。
そのため、ログファイルからすべてのエラーメッセージを抽出したり、文書内のすべてのメールアドレスをリストアップしたりする際に非常に重宝します。
現代のデータ駆動型の開発においては、非構造化データから必要な情報を整理するために、このfindallを使いこなすスキルが必須といえるでしょう。
re.findall関数の基本的な使い方と構文
re.findallを使用するには、まず関数のシグネチャを理解することが重要です。
基本的な構文は、re.findall(pattern, string, flags=0)という形式で記述します。
第一引数のpatternには、検索したい正規表現パターンを文字列として指定します。
第二引数のstringには、検索対象となる元の文字列を指定します。
第三引数のflagsは、大文字小文字を区別しないなどの特殊なオプションを指定する際に使用する、省略可能な引数です。
この関数を実行すると、一致したすべての箇所が文字列のリストとして返されます。
もし一致する箇所が一つも見つからなかった場合は、空のリスト [] が返されるため、その後の処理でエラーが発生しにくい設計になっています。
最もシンプルなfindallの例
まずは、具体的なコードを通じて、findallがどのように動作するのかを確認してみましょう。
以下の例では、文章の中から「Python」という文字列をすべて抽出しています。
import re

text = "Pythonは学びやすく、Pythonは非常に汎用性が高い言語です。"
result = re.findall("Python", text)

print(result)['Python', 'Python']このように、指定した文字列がテキスト内に複数存在する場合、そのすべてを要素に持つリストが得られます。
正規表現パターンを活用した効率的な抽出
findallの真の真価は、単なる文字列検索ではなく、正規表現のメタ文字を組み合わせたパターンマッチングにあります。
メタ文字を使用することで、「数字だけを抽出したい」あるいは「特定の文字で始まる単語だけを抽出したい」といった複雑な要望に応えられます。
ここでは、実務でよく利用される基本的な正規表現パターンをいくつか紹介します。
| メタ文字 | 意味 |
|---|---|
\d | 任意の数字 (0-9) に一致します。 |
\w | 英数字およびアンダースコアに一致します。 |
+ | 直前のパターンが1回以上繰り返される場合に一致します。 |
* | 直前のパターンが0回以上繰り返される場合に一致します。 |
. | 改行を除く任意の1文字に一致します。 |
数値データの抽出例
例えば、請求書データやレポートの中から価格や個数などの数値だけを取り出したい場合があります。
その場合は、\d+ というパターンを使用することで、連続した数字をひとまとまりとして抽出できます。
import re

item_text = "リンゴが150円、バナナが200円、オレンジが80円です。"
# \d+ は1文字以上の数字の連続を意味する
prices = re.findall(r"\d+", item_text)

print(prices)['150', '200', '80']正規表現の前に r を付けることで「生の文字列 (raw string)」として扱い、バックスラッシュがエスケープ文字として誤認されるのを防ぐのが一般的です。
メールアドレスの抽出例
より実用的な例として、テキストからメールアドレスの形式に一致する部分をすべて抽出してみましょう。
メールアドレスのパターンは複雑ですが、簡略化した形であれば以下のように記述できます。
import re

contact_info = "お問い合わせは support@example.com または info@test.jp までお送りください。"
# 英数字や記号の組み合わせ + @ + 英数字や記号の組み合わせ
email_pattern = r"[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}"
emails = re.findall(email_pattern, contact_info)

print(emails)['support@example.com', 'info@test.jp']このように、findallを使用すれば、テキスト内に点在する情報を一気にリスト化し、その後のデータクレンジング作業を大幅に効率化できます。
キャプチャグループを使用した詳細な抽出
正規表現には、丸括弧 () を使用して特定の部分だけをグループ化する「キャプチャグループ」という機能があります。
re.findall にこのグループが含まれている場合、戻り値の挙動が変わるため注意が必要です。
パターン全体ではなく、丸括弧で囲まれた部分だけが抽出対象としてリストに返されます。
もし複数のグループが指定されている場合、結果は「タプルのリスト」になります。
単一グループの挙動
以下のコードでは、日付の形式から「月」の部分だけを抽出しています。
import re

dates = "2026/01/01, 2026/05/15, 2026/12/25"
# 月の部分(2桁の数字)を括弧で囲む
months = re.findall(r"\d{4}/(\d{2})/\d{2}", dates)

print(months)['01', '05', '12']パターン全体 \d{4}/\d{2}/\d{2} には一致していますが、リストには括弧内の \d{2} だけが格納されていることがわかります。
複数グループの挙動
次に、年、月、日をそれぞれ個別に取得したい場合の例を見てみましょう。
import re

dates = "2026/01/01, 2026/05/15"
# 年、月、日をそれぞれ括弧で囲む
date_parts = re.findall(r"(\d{4})/(\d{2})/(\d{2})", dates)

print(date_parts)[('2026', '01', '01'), ('2026', '05', '15')]このように、一つのマッチに対して複数の情報が必要な場合、findallは非常に強力なデータ構造を自動的に構築してくれます。
findallとfinditerの違いと使い分け
re.findallとよく比較されるメソッドに、re.finditerがあります。
これら二つの最大の違いは、戻り値の型とメモリ効率にあります。
findallは、一致したすべての文字列をメモリ上のリストとして一度に生成します。
一方で、finditerは「マッチオブジェクト」を返すイテレータを返します。
巨大なテキストファイルを処理する場合、findallではすべての結果をメモリに展開するため、メモリ不足を引き起こす可能性があります。
そのようなケースでは、必要なときに一つずつマッチ結果を取り出せる finditer を使用するのが最適です。
また、マッチした文字列の開始位置や終了位置(インデックス情報)が必要な場合も、finditerで取得できるマッチオブジェクトが不可欠です。
import re

text = "Python Python Python"
iterator = re.finditer("Python", text)

for match in iterator:
print(f"見つかった文字列: {match.group()}, 開始位置: {match.start()}")見つかった文字列: Python, 開始位置: 0
見つかった文字列: Python, 開始位置: 7
見つかった文字列: Python, 開始位置: 14小規模なデータや単純なリストが必要な場合は findall、大規模データや詳細なメタデータが必要な場合は finditer と使い分けるのがプロのテクニックです。
正規表現フラグで検索をカスタマイズする
検索条件をより柔軟にするために、re.findallの第三引数である flags を活用しましょう。
よく使われるフラグの一つに、大文字と小文字を区別せずに検索する re.IGNORECASE (または re.I) があります。
import re

text = "PYTHON and python are the same."
result = re.findall("python", text, re.IGNORECASE)

print(result)['PYTHON', 'python']また、ドット . メタ文字を改行コードにも一致させる re.DOTALL (または re.S) も便利です。
デフォルトではドットは改行で止まってしまいますが、このフラグを使うことで複数行にわたるテキストブロックを一気に抽出できるようになります。
複数のフラグを同時に適用したい場合は、パイプ記号 | を使って re.I | re.S のように記述します。
コンパイルによるパフォーマンスの向上
同じ正規表現パターンを何度も繰り返し使用する場合、re.compile 関数を使用して正規表現オブジェクトを事前に生成しておくことを推奨します。
コンパイルを行うことで、実行時に毎回パターンを解析するオーバーヘッドが削減され、処理速度が向上します。
import re

# 正規表現パターンをコンパイルする
pattern = re.compile(r"\d+")
text = "サンプル123, テスト456"

# コンパイル済みのオブジェクトからfindallを呼び出す
result = pattern.findall(text)

print(result)['123', '456']特にループ処理の中で findall を呼び出すようなケースでは、このコンパイルの有無がアプリケーション全体のパフォーマンスに大きな影響を与えることがあります。
大規模なテキストマイニングを行う際は、必ず検討すべき最適化手法の一つです。
findall利用時の注意点とエラー回避
非常に便利な findall ですが、いくつかの注意点も存在します。
一つ目は、先述した「キャプチャグループ」による戻り値の変化です。
意図せず丸括弧を使用してしまうと、パターン全体の結果が得られなくなるため、グループ化を目的としない括弧が必要な場合は (?:...) という非キャプチャグループを使用してください。
二つ目は、正規表現の「欲張りマッチ (Greedy match)」です。
デフォルトでは * や + は可能な限り長い文字列に一致しようとします。
最短一致にしたい場合は、*? や +? のようにクエスチョンマークを付け加える工夫が必要です。
三つ目は、特殊文字の扱いです。
例えば . や ? 自体を検索したい場合は、バックスラッシュでエスケープして \. や \? と記述しなければなりません。
これらの基本を押さえておくことで、デバッグに費やす時間を大幅に削減できるはずです。
まとめ
本記事では、Pythonの re.findall 関数を使用して文字列を効率的に抽出する方法を解説しました。
findall は、シンプルでありながら強力なテキストスキャン能力を持つ非常に優れた関数です。
基本的な使い方から、メタ文字を活用した高度な検索、キャプチャグループによるデータの構造化、そしてパフォーマンス最適化までを理解することで、文字列操作の幅は飛躍的に広がります。
正規表現は一見すると複雑で難解に感じるかもしれませんが、一つひとつの要素を組み合わせていけば、どんな複雑なテキストデータも自由自在に操ることができます。
まずは、今回紹介した数値やメールアドレスの抽出といった身近な例から、実際にコードを書いて試してみてください。
Pythonの持つ柔軟な文字列処理能力を最大限に引き出し、日々の開発業務やデータ解析に役立てていただければ幸いです。