
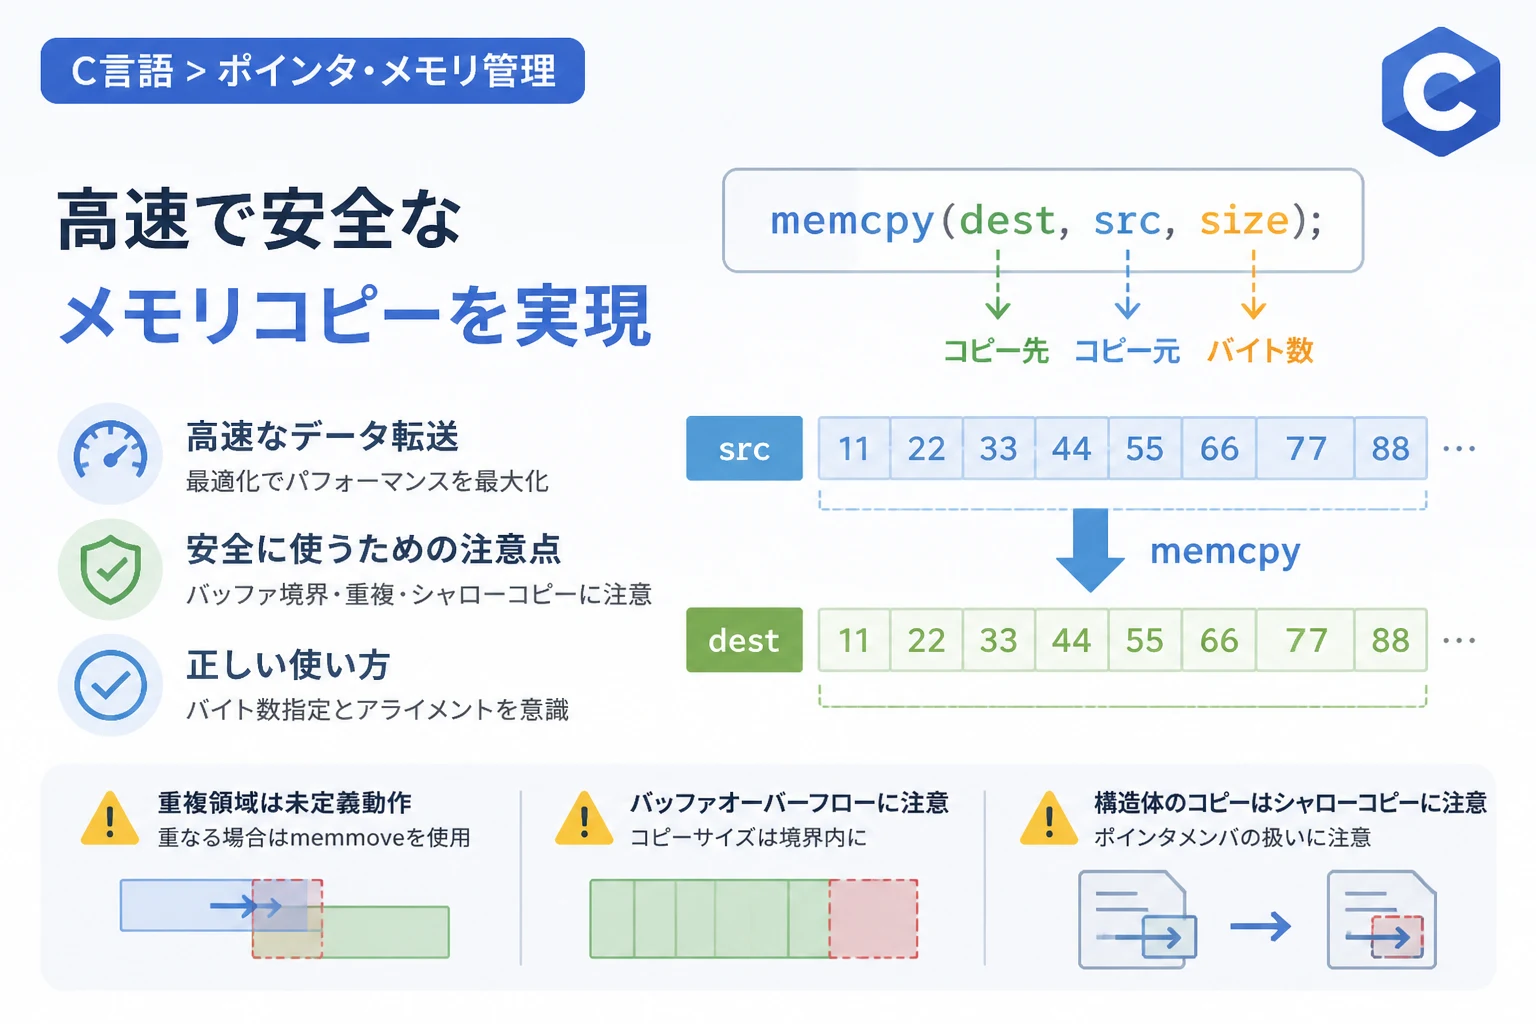
C言語においてメモリ操作を直接制御することは、プログラムの実行効率を最大化するための重要なスキルです。
その中でも「memcpy」関数は、メモリブロックをバイト単位でコピーするための最も基本的かつ強力なツールの一つです。
本記事では、memcpy関数の基本的な使い方から、開発現場で求められる高速化の仕組み、そして安全性を確保するための重要なポイントについて詳しく解説します。
組み込み開発からシステムプログラミングまで、C言語を扱うすべてのエンジニアが知っておくべき知識を整理していきましょう。
memcpy関数の基本概要と役割
C言語の標準ライブラリに含まれるmemcpy関数は、あるメモリ領域から別のメモリ領域へ、指定したバイト数分だけデータをコピーするために使用されます。
string.hヘッダーファイルをインクルードすることで利用可能となり、文字列だけでなく構造体や配列など、あらゆるデータ型を「生のデータ」として扱うことができます。
まずは、この関数の基本的な定義と、それぞれの引数が持つ意味について確認していきましょう。
プロトタイプ宣言と引数の詳細
memcpy関数のプロトタイプ宣言は以下の通りです。
void *memcpy(void *dest, const void *src, size_t n);この関数は3つの引数を取り、戻り値としてコピー先の先頭ポインタを返します。
各引数の役割を以下の表にまとめました。
| 引数名 | 型 | 役割 |
|---|---|---|
| dest | void * | コピー先のメモリ領域の先頭アドレスを指定します。 |
| src | const void * | コピー元のメモリ領域の先頭アドレスを指定します。 |
| n | size_t | コピーするデータのサイズを「バイト数」で指定します。 |
引数がvoid *型であるため、任意の型のポインタを渡すことが可能です。
ただし、第3引数の「n」は「要素数」ではなく「バイト数」であることに注意しなければなりません。
int型や構造体の配列をコピーする場合は、sizeof演算子を用いて正確なバイト数を算出することが推奨されます。
基本的な使用例
ここでは、int型の配列を別の配列へコピーする具体的なコード例を見てみましょう。
#include <stdio.h>
#include <string.h>

int main() {
    int source[] = {10, 20, 30, 40, 50};
    int destination[5];

    // 配列の要素数ではなく、全体のバイト数を指定する
    memcpy(destination, source, sizeof(source));

    // 結果の確認
    for(int i = 0; i < 5; i++) {
        printf("destination[%d] = %d\n", i, destination[i]);
    }

    return 0;
}destination[0] = 10
destination[1] = 20
destination[2] = 30
destination[3] = 40
destination[4] = 50この例では、sizeof(source)を使用することで、int型5要素分のメモリサイズ(通常は20バイト程度)を一度にコピーしています。
ループ処理(for文)を用いて1要素ずつ代入する方法に比べ、記述が簡潔になり、コンパイラの最適化も受けやすいというメリットがあります。
memcpyが高速である理由とその仕組み
なぜC言語のプログラマは、単純なループ処理ではなくmemcpyを好んで使用するのでしょうか。
その大きな理由の一つに、「ハードウェアレベルでの最適化」が挙げられます。
memcpyは単に1バイトずつデータを移しているわけではなく、実行環境のCPUアーキテクチャに合わせて最も効率的な命令が選択されるように実装されています。
CPUのレジスタサイズとバス幅の活用
現代のCPUは、32ビットや64ビットといった広いバス幅を持っています。
memcpyの実装では、可能な限り1バイト単位のコピーを避け、4バイトや8バイトといった大きな単位でまとめてデータを転送します。
さらに、最新のCPUではSIMD(SSE, AVXなど)と呼ばれる命令セットを使用し、一度に16バイト以上のデータを並列処理することもあります。
手書きのfor文による代入では、コンパイラが高度な最適化を行わない限り、このような極限のパフォーマンスを引き出すことは困難です。
メモリアライメントの影響
memcpyの性能を最大限に引き出すためには、「メモリアライメント(境界調整)」を意識することが重要です。
CPUは、特定の境界(例えば8バイト境界)に配置されたデータに対して、より高速にアクセスできる特性を持っています。
コピー先(dest)とコピー元(src)のアドレスが適切にアライメントされている場合、memcpyは内部的に高速なロード・ストア命令を連続して発行できます。
逆にアライメントがズレていると、余分な計算やメモリサイクルが発生し、実行速度が低下する可能性があります。
memcpy使用時の注意点と重大なリスク
memcpyは非常に強力ですが、C言語特有の「メモリの直接操作」を行うため、誤った使い方をすると致命的なバグやセキュリティ脆弱性を引き起こします。
特に注意すべきは、「メモリ領域の重複」と「バッファオーバーフロー」の2点です。
メモリ領域の重複とmemmoveの使い分け
memcpy関数の仕様上、コピー元とコピー先の領域が重なっている場合の動作は「未定義(Undefined Behavior)」とされています。
例えば、同じ配列内の一部を少し後ろにずらしてコピーするようなケースがこれに該当します。
もし領域が重なる可能性がある場合は、memcpyではなくmemmove関数を使用しなければなりません。
// 危険な例:領域が重なっている場合
char buffer[10] = "ABCDE";
memcpy(buffer + 1, buffer, 5); // 動作は保証されない

// 安全な例:memmoveを使用する
memmove(buffer + 1, buffer, 5); // 正しく "AABCD" のようになる
memmoveは、内部的に一時的なバッファを介するか、コピーの方向を調整することで、重なりがあっても正しくデータを転送することを保証します。
パフォーマンス面ではmemcpyが若干有利な場合が多いですが、安全性が優先される場面ではmemmoveの選択も検討してください。
バッファオーバーフローの防止
memcpyにおける最も一般的なミスは、コピー先のバッファサイズを超えたデータを書き込んでしまうことです。
これはバッファオーバーフローと呼ばれ、プログラムの異常終了(セグメンテーションフォールト)や、任意のコード実行を許すセキュリティホールに直結します。
コピーするサイズ(n)を決定する際は、常に以下の点を確認する習慣をつけましょう。
- コピー先のバッファサイズが「n」以上であるか。
- 「n」の計算に、型のサイズ(sizeof)が正しく反映されているか。
- 動的メモリ確保(malloc等)を使用している場合、確保したサイズと一致しているか。
安全性と信頼性を高める現代的な手法
2026年現在のソフトウェア開発においては、実行速度だけでなく、いかにバグを未然に防ぐかという「堅牢性」が重視されます。
memcpyに関連するリスクを最小限に抑えるための、より安全なプログラミング手法を紹介します。
C11標準のmemcpy_s関数の検討
C11規格以降では、セキュリティを強化した境界チェック付きの関数群が導入されました。
その一つがmemcpy_sです。
この関数は、コピー先のバッファサイズを引数として受け取り、コピー実行前にサイズチェックを行います。
// memcpy_s の例(環境によってサポート状況が異なります)
errno_t memcpy_s(void *dest, rsize_t destsz, const void *src, rsize_t n);もしnがdestszを超えている場合、関数はエラーを返し、コピーを中断します。
標準ライブラリのサポート状況に依存しますが、ミッションクリティカルなシステムでは、このようなセキュア関数の利用や、自作のラッパー関数によるチェックが一般的です。
静的解析ツールと動的解析ツールの活用
人間がすべてのバッファサイズを完璧に管理するのは困難です。
そこで、静的解析ツール(Clang-Tidy, Cppcheck等)をビルドプロセスに組み込み、memcpyの怪しい箇所を自動的に検出させることが有効です。
また、実行時にメモリ破壊を検知するAddressSanitizer (ASan)を利用すれば、開発段階でオーバーフローを確実に発見できます。
構造体とmemcpy:ディープコピーへの注意
memcpyは構造体の一括コピーにも非常に便利です。
しかし、構造体のメンバに「ポインタ」が含まれている場合は注意が必要です。
memcpyはあくまで「メモリの内容をそのままコピーする」ため、ポインタ変数が指しているアドレスの値だけがコピーされ、実体(データ本体)は共有されたままになります。
これを「シャローコピー(浅いコピー)」と呼びます。
struct Data {
    int id;
    char *name; // ポインタメンバ
};

struct Data d1, d2;
d1.id = 1;
d1.name = strdup("Sample");

// シャローコピーが発生する
memcpy(&d2, &d1, sizeof(struct Data));この場合、d1.nameとd2.nameは同じメモリ番地を指してしまいます。
一方がメモリを解放(free)すると、もう一方は無効な領域を指す「ダングリングポインタ」となり、クラッシュの原因となります。
ポインタを含む構造体をコピーする場合は、メンバごとにメモリを確保し直す「ディープコピー」を実装する必要があります。
memcpyと関連関数の使い分けまとめ
メモリ操作には、memcpy以外にも用途に応じた適切な関数が存在します。
以下の比較表を参考に、目的に最適な関数を選択してください。
| 関数名 | 主な用途 | 特徴 |
|---|---|---|
| memcpy | 一般的なメモリコピー | 最速だが、領域の重なりに弱い。 |
| memmove | 領域が重なる可能性があるコピー | 安全性が高く、重なりを考慮する。 |
| memset | メモリ領域の初期化 | 指定した値(0など)で全バイトを埋める。 |
| strcpy / strncpy | 文字列のコピー | 終端文字(\0)を考慮する。バイナリには不向き。 |
| memcmp | メモリ領域の比較 | 2つの領域の内容が等しいかをバイト単位で判定。 |
文字列の操作にはstrcpy等が使われますが、文字列長が既知の場合はmemcpyを使用するほうが高速な場合が多いです。
これは、strcpyが1文字ごとに終端文字のチェックを行うのに対し、memcpyは長さを指定して一気に転送するためです。
このように、「何が最善の選択か」を常に意識することが、優れたC言語エンジニアへの第一歩です。
まとめ
memcpy関数は、C言語におけるデータ操作の要であり、その背後にはCPUの性能を最大限に引き出すための工夫が詰まっています。
効率的なコピーを実現するためには、バイト単位でのサイズ指定やメモリアライメントの理解が不可欠です。
一方で、メモリ領域の重複やバッファオーバーフローといったリスクが常に隣り合わせであることを忘れてはなりません。
memmoveへの切り替えや、開発ツールの活用、そして構造体のコピー時におけるシャローコピーへの配慮など、安全性を担保する手法をセットで身につけることが重要です。
正しく安全にmemcpyを使いこなし、高速で堅牢なC言語プログラムを構築していきましょう。