Node.jsは非同期処理を主軸に置いたサーバーサイド実行環境であり、その中心的な役割を果たしてきたのがコールバック関数です。
近年のNode.js開発ではPromiseやasync/awaitが主流となりましたが、コールバックの仕組みを理解することは、ランタイムの内部動作を把握する上で欠かせません。
特にレガシーコードのメンテナンスや、低レイヤーのAPI、特定のイベント駆動ライブラリを利用する際には、現在でもコールバックの知識が必要とされます。
本記事では、Node.jsにおけるコールバックの基礎から、特有のルールであるエラーファースト・コールバック、そして適切なエラーハンドリングの方法について詳しく解説します。
非同期処理の原点を学び直すことで、より堅牢で効率的なアプリケーション開発のスキルを身につけていきましょう。
コールバック関数とは何か
コールバック関数とは、ある関数に引数として渡され、特定の処理が完了したタイミングで実行される関数のことを指します。
Node.jsにおいて非同期処理を実現するための最も基本的な仕組みであり、I/O操作の完了を待たずに次の処理を進めるために利用されます。
同期処理と非同期処理の違い
同期処理では、コードが記述された順番に一行ずつ実行され、一つの処理が終わるまで次の処理は開始されません。
大きなファイルの読み込みやネットワークリクエストを行う場合、同期処理ではプログラム全体が停止してしまうブロッキングが発生します。
一方で非同期処理は、重い処理をバックグラウンドで実行し、その結果を後で受け取るための予約票としてコールバック関数を利用します。
Node.jsはこの非同期I/Oの仕組みにより、単一のスレッドでありながら大量のリクエストを効率的に処理することが可能となっています。
イベントループとコールバックの関係
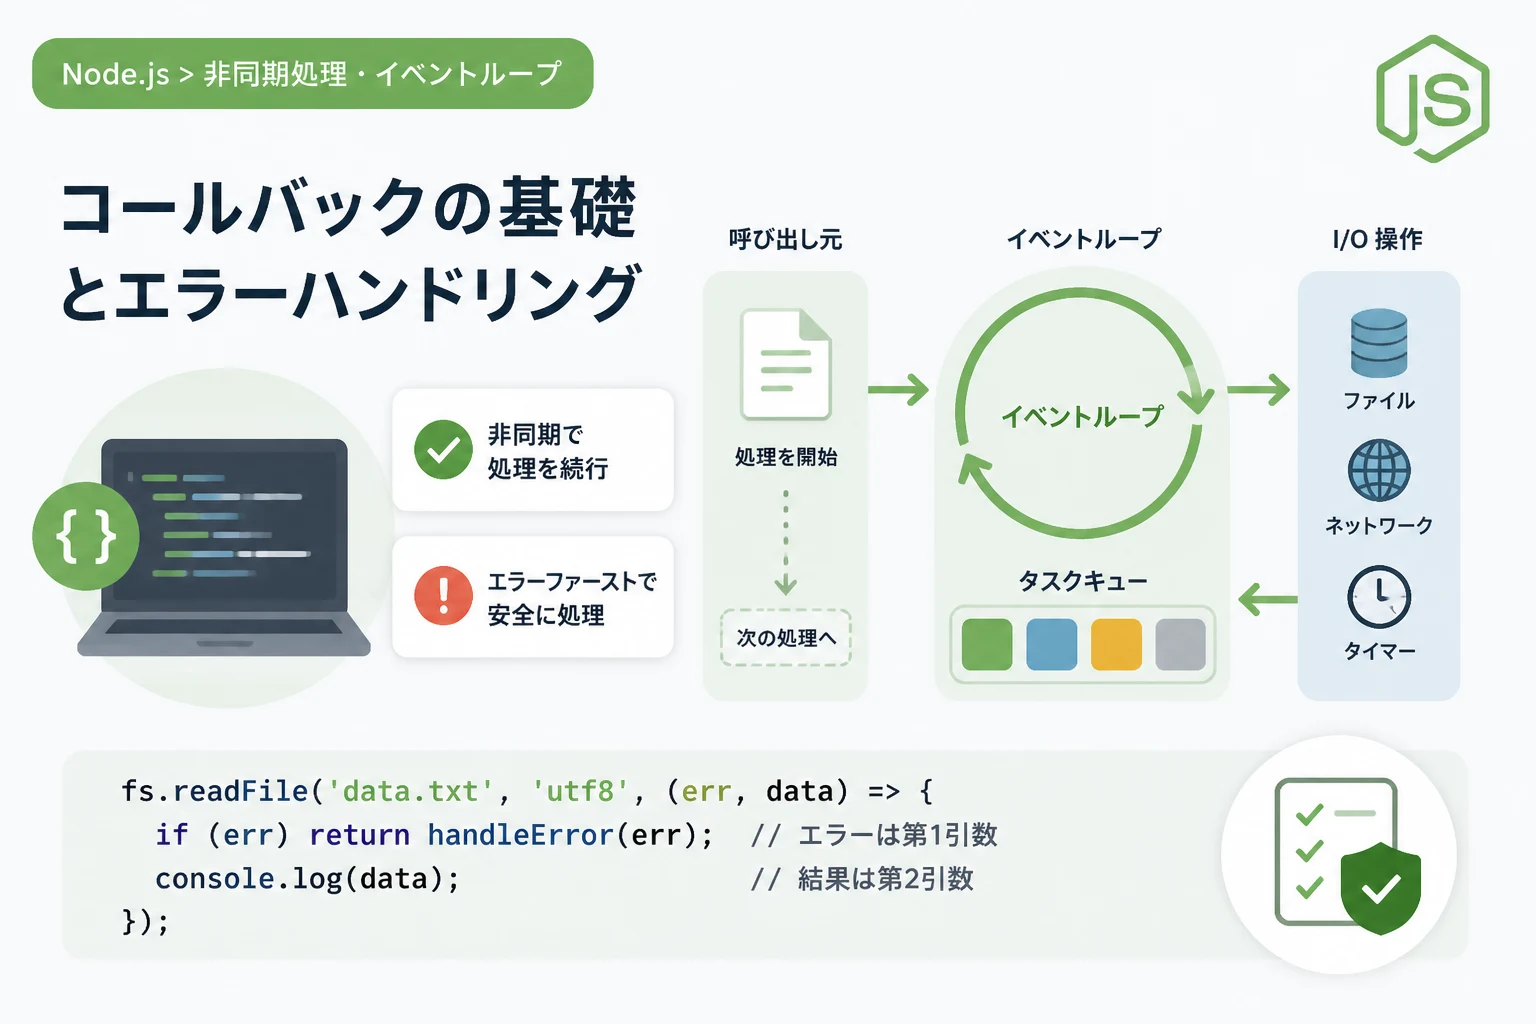
Node.jsの内部では「イベントループ」と呼ばれる仕組みが常に回転しており、実行可能なタスクがないか監視しています。
非同期操作が完了すると、その結果とともにコールバック関数がタスクキューに追加されます。
メインスレッドが空いたタイミングで、イベントループがキューからコールバックを取り出し、JavaScriptエンジンに実行を依頼します。
このように、コールバックは「後で実行される処理の定義」をカプセル化したものと言えます。
コールバックの基本構文と実装方法
Node.jsでコールバックを実装する際は、関数の最後の引数に関数を渡すというスタイルが一般的です。
まずはシンプルな自作関数の例を見て、コールバックがどのように呼び出されるかを確認しましょう。
// 名前を受け取って挨拶を表示する関数
function greet(name, callback) {
    console.log(`こんにちは、${name}さん。`);
    // 処理が完了した後にコールバックを実行する
    callback();
}

// コールバック関数として渡す処理
function afterGreet() {
    console.log('挨拶の処理が完了しました。');
}

// 関数を実行
greet('田中', afterGreet);こんにちは、田中さん。
挨拶の処理が完了しました。この例では、greet関数の処理が終わった直後に、引数として渡されたafterGreetが実行されています。
実務では、このように同期的なコールバックよりも、タイマーやファイル操作などの非同期的な場面で多用されます。
Node.js標準の「エラーファースト・コールバック」
Node.jsの多くの組み込みモジュールでは、「エラーファースト・コールバック」という共通のルールが採用されています。
これは、コールバック関数の第一引数に必ず「エラーオブジェクト」を配置し、第二引数以降に「成功時のデータ」を配置する設計パターンのことです。
なぜエラーファーストなのか
非同期処理では、例外がいつ発生するか予測できないため、従来のtry-catch構文でエラーを捕捉することができません。
そのため、処理の結果を受け取るコールバック自身が「エラーが起きたかどうか」を最初に判断する必要があります。
エラーが発生した場合は第一引数にErrorオブジェクトが渡され、成功した場合は第一引数がnullまたはundefinedになります。
ファイル読み込みの実装例
Node.jsのfsモジュールを使用して、テキストファイルを読み込む際の標準的な書き方を見てみましょう。
const fs = require('fs');

// ファイルの読み込み(非同期)
fs.readFile('example.txt', 'utf8', (err, data) => {
    // 最初にエラーの有無を確認する
    if (err) {
        console.error('ファイルの読み込み中にエラーが発生しました:', err.message);
        return;
    }

    // エラーがなければデータを使用する
    console.log('ファイルの内容:', data);
});
このパターンを守ることで、予期せぬエラーによるアプリケーションのクラッシュを防ぎ、一貫性のあるコードを記述できます。
非同期処理におけるエラーハンドリングの重要性
コールバックを利用する際、最も注意すべき点はエラーを無視しないことです。
もしerrのチェックを怠ると、未定義のデータにアクセスしようとして二次的なエラーを引き起こす可能性があります。
try-catchが効かない理由
以下のコードは、初心者が陥りやすい典型的な間違いです。
try {
    fs.readFile('non-existent.txt', (err, data) => {
        if (err) throw err; // ここでスローしても外部のcatchには届かない
    });
} catch (e) {
    console.log('エラーをキャッチしました'); // ここは実行されない
}fs.readFile自体は即座に終了し、コールバックが実行されるのはそのずっと後、メインスレッドがtry-catchブロックを抜けた後になります。
そのため、非同期処理の中での例外はその場で適切に処理するか、別のコールバックで上位に伝播させる必要があります。
エラーを伝播させる方法
独自の非同期関数を作成する場合も、エラーファーストの原則に従ってエラーを呼び出し元に伝えるべきです。
function processUserData(userId, callback) {
    if (!userId) {
        // IDがない場合はエラーを第一引数に渡す
        return callback(new Error('ユーザーIDが必要です'));
    }

    // 疑似的な非同期処理
    setTimeout(() => {
        const userData = { id: userId, name: 'Guest' };
        // 成功時は第一引数をnullにする
        callback(null, userData);
    }, 1000);
}

processUserData(null, (err, user) => {
    if (err) {
        console.log('処理失敗:', err.message);
        return;
    }
    console.log('処理成功:', user.name);
});
コールバック地獄とその回避策
コールバックは非常に強力ですが、複数の非同期処理を順番に行いたい場合に構造が複雑になりやすいという欠点があります。
これを「コールバック地獄(Callback Hell)」または「ピラミッド・オブ・ドゥーム」と呼びます。
コールバック地獄の例
例えば、ファイルAを読み込み、その内容を使ってファイルBを読み込み、さらにその結果をファイルCに書き込む処理を考えます。
fs.readFile('a.txt', 'utf8', (err, dataA) => {
    if (err) return console.error(err);
    fs.readFile('b.txt', 'utf8', (err, dataB) => {
        if (err) return console.error(err);
        const result = dataA + dataB;
        fs.writeFile('c.txt', result, (err) => {
            if (err) return console.error(err);
            console.log('すべての処理が完了しました');
        });
    });
});
入れ子が深くなるほどコードの可読性は低下し、どこでどのエラーを処理しているのかを把握するのが困難になります。
また、変数のスコープが入り乱れることで、バグの原因にもなりやすいです。
関数の分割による対策
コールバック地獄を回避する最も古典的で有効な方法は、匿名関数を使わずに名前付き関数として定義を分けることです。
function handleWrite(err) {
    if (err) return console.error(err);
    console.log('すべての処理が完了しました');
}

function handleReadB(err, dataB, dataA) {
    if (err) return console.error(err);
    const result = dataA + dataB;
    fs.writeFile('c.txt', result, handleWrite);
}

function handleReadA(err, dataA) {
    if (err) return console.error(err);
    fs.readFile('b.txt', 'utf8', (err, dataB) => handleReadB(err, dataB, dataA));
}

fs.readFile('a.txt', 'utf8', handleReadA);
このように処理をフラットに記述することで、ロジックの流れが追いやすくなります。
現代におけるコールバックの役割と使い分け
2026年現在のNode.js開発においては、Promiseやasync/awaitが標準となっています。
しかし、コールバックが完全に消え去ったわけではなく、依然として重要な役割を担っています。
イベントエミッターとの連携
Node.jsのEventEmitterクラスを利用したストリーム処理やイベント監視では、今でもコールバックが主役です。
HTTPリクエストの受信やWebSocketのデータ受信など、「いつ、何度発生するか分からないイベント」を扱うには、一度きりの解決を前提とするPromiseよりもコールバックの方が適しています。
パフォーマンスの観点
Promiseオブジェクトの生成にはわずかながらオーバーヘッドが伴います。
超高頻度で実行される非常に小さな処理など、極限のパフォーマンスが求められるライブラリの内部実装では、あえてコールバックが選択されるケースもあります。
util.promisifyによる変換
既存のコールバック形式のAPIをモダンな形式で使いたい場合は、util.promisifyを活用するのが一般的です。
const fs = require('fs');
const util = require('util');

// コールバック形式をPromise形式に変換
const readFile = util.promisify(fs.readFile);

async function main() {
    try {
        const data = await readFile('example.txt', 'utf8');
        console.log(data);
    } catch (err) {
        console.error(err);
    }
}

main();
これにより、コールバックの堅実な仕組みを利用しつつ、シンタックスシュガーによる恩恵を受けることができます。
まとめ
Node.jsにおけるコールバックは、非同期プログラミングの基礎であり、すべての高度な抽象化の土台となっている技術です。
本記事では、コールバックの基本的な概念から、Node.js特有のエラーファースト・パターンの重要性、そしてエラーハンドリングの注意点について解説しました。
コールバック地獄のような課題はありますが、適切な関数の分離や最新のPromise化技術を組み合わせることで、効率的に扱うことが可能です。
非同期処理の仕組みを深く理解することは、トラブルシューティングやライブラリ選定において強力な武器となります。
まずは標準モジュールの動作を確認しながら、安全で読みやすいコードを書く練習から始めてみてください。