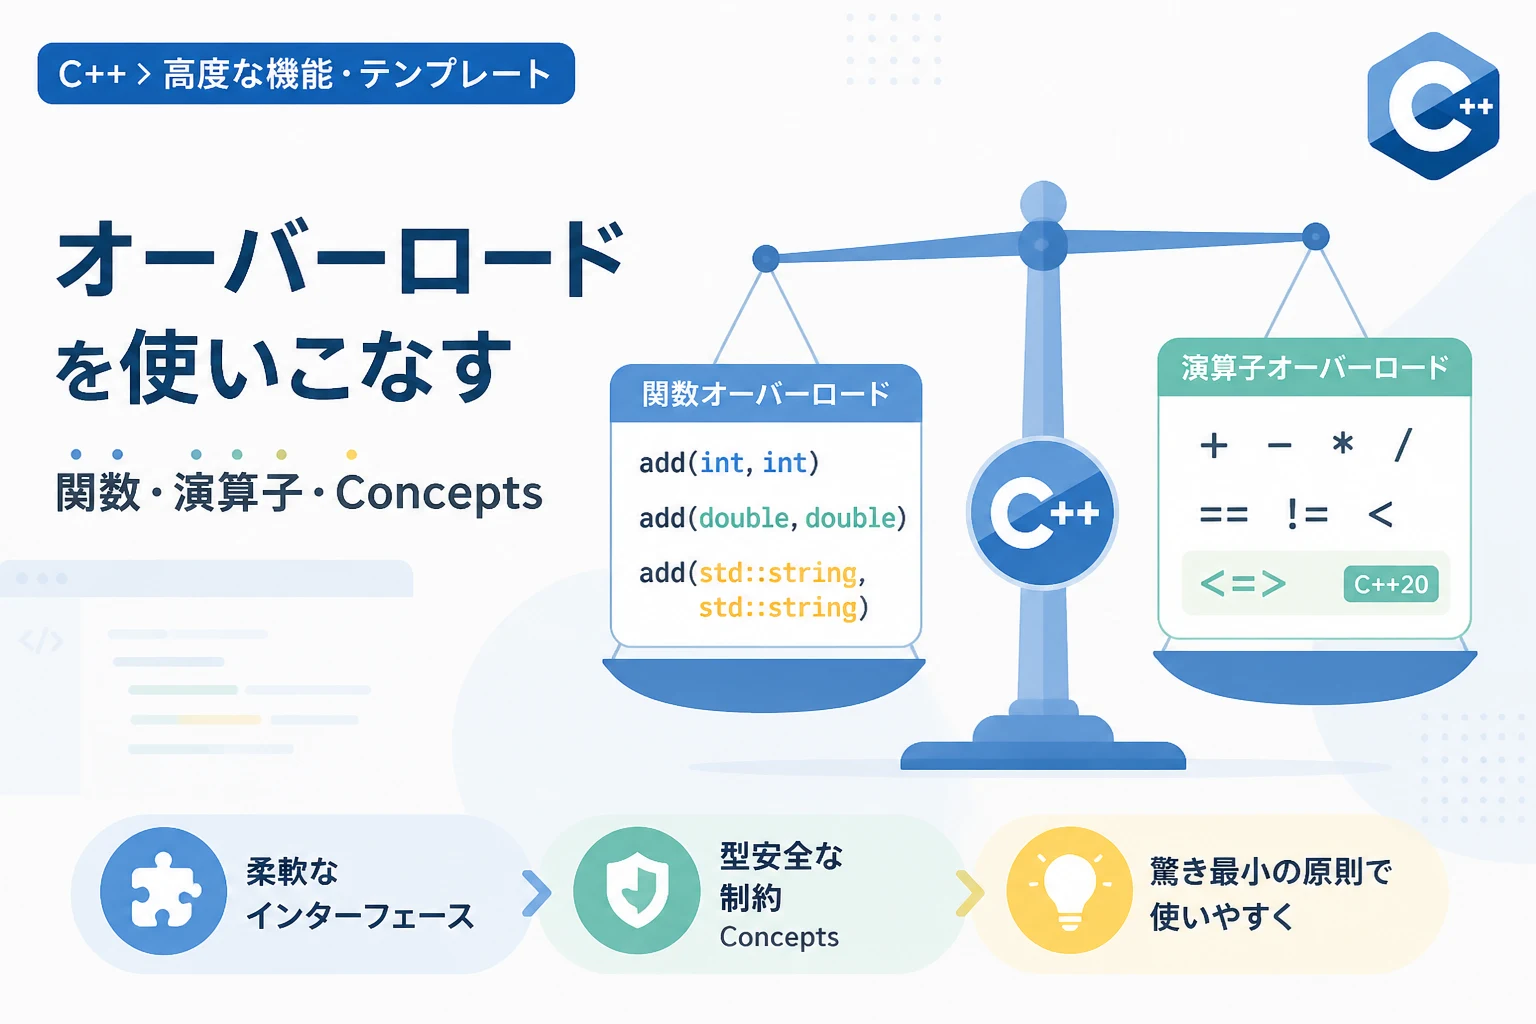
C++においてオーバーロードは、同じ名前の関数や演算子に複数の定義を持たせることで、直感的かつ柔軟なインターフェースを実現するための核心的な機能です。
モダンなC++開発においては、単なる名前の共有にとどまらず、テンプレートやConcepts(コンセプト)と組み合わせることで、型安全性を維持しながら高度な抽象化を行うことが求められます。
本記事では、関数オーバーロードの基礎から、演算子オーバーロードの実践的な設計、そして現代のC++20/23以降で主流となっているConceptsを用いた制約付きオーバーロードまでを詳しく掘り下げます。
関数オーバーロードの仕組みと解決プロセス
関数オーバーロードとは、引数の型や数が異なる場合に、同じ名前の関数を複数定義できる仕組みを指します。
コンパイラは、関数呼び出し時に渡された実引数と、定義されている各関数の仮引数を照合し、最も適切な関数を選択します。
このプロセスをオーバーロード解決(Overload Resolution)と呼びます。
オーバーロード解決には明確な優先順位が存在し、厳密な一致が最も優先されます。
オーバーロードの判定基準
関数の名前が同じであっても、引数のリスト(シグネチャ)が異なれば、それらは異なる関数として扱われます。
具体的には、引数の数、引数の型、引数の順番、そしてメンバ関数の場合はconst修飾の有無が判定基準に含まれます。
注意すべき点は、戻り値の型だけが異なる関数はオーバーロードできないという事実です。
なぜなら、関数呼び出し側で戻り値を利用しない場合、コンパイラはどの関数を呼び出すべきか判断できないからです。
// オーバーロードの例
#include <iostream>
#include <string>

void print(int i) {
    std::cout << "Integer: " << i << std::endl;
}

void print(double d) {
    std::cout << "Double: " << d << std::endl;
}

void print(const std::string& s) {
    std::cout << "String: " << s << std::endl;
}

int main() {
    print(10);        // print(int) が呼ばれる
    print(3.14);      // print(double) が呼ばれる
    print("Hello");   // print(const std::string&) が呼ばれる
    return 0;
}Integer: 10
Double: 3.14
String: Hello曖昧な呼び出し(Ambiguity)の回避
オーバーロード解決において、コンパイラが「どの関数が最適か」を一つに絞り込めない場合、コンパイルエラーが発生します。
例えば、float型の引数を受け取る関数とdouble型の引数を受け取る関数がある状況で、int型の値を渡すと、どちらの浮動小数点型への変換が適切か判断に迷うことがあります。
このような曖昧さを避けるためには、明示的なキャストを行うか、より適切な型を持つオーバーロードを追加する必要があります。
演算子オーバーロードによる直感的な型設計
C++の強力な機能の一つに、ユーザー定義型(クラスや構造体)に対して標準の演算子を再定義できる演算子オーバーロードがあります。
これにより、自作したクラスのオブジェクト同士を+や-、*といった記号で自然に操作できるようになります。
ただし、演算子の本来の意味から逸脱した定義を行うと、コードの可読性を著しく損なうため注意が必要です。
算術演算子のオーバーロード
算術演算子をオーバーロードする際は、メンバ関数として実装する方法と、非メンバ関数(フレンド関数)として実装する方法があります。
一般的に、左辺と右辺で異なる型を受け入れる柔軟性を持たせるためには、非メンバ関数として定義することが推奨されます。
以下の例では、2次元ベクトルを表す構造体に対して加算演算子を定義しています。
#include <iostream>

struct Vector2D {
    float x, y;

    // 加算代入演算子のメンバ関数実装
    Vector2D& operator+=(const Vector2D& rhs) {
        x += rhs.x;
        y += rhs.y;
        return *this;
    }
};

// 二項加算演算子の非メンバ関数実装
Vector2D operator+(Vector2D lhs, const Vector2D& rhs) {
    lhs += rhs;
    return lhs;
}

int main() {
    Vector2D v1{1.0f, 2.0f};
    Vector2D v2{3.0f, 4.0f};
    Vector2D v3 = v1 + v2;

    std::cout << "v3: (" << v3.x << ", " << v3.y << ")" << std::endl;
    return 0;
}v3: (4, 6)比較演算子と三方向比較(Spaceship Operator)
C++20からは、<=>(三方向比較演算子、通称宇宙船演算子)が導入され、比較演算子のオーバーロードが大幅に簡略化されました。
この演算子を一つ定義し、さらにdefault指定を行うだけで、==, !=, <, <=, >, >= のすべてが自動的に導出されます。
ボイラープレートコードを削減し、一貫性のある比較ロジックを維持できるため、現代的なC++設計では必須のテクニックです。
| 演算子の種類 | 主な用途 | 実装上の推奨事項 |
|---|---|---|
| 算術演算子 (+, -, *, /) | 数値演算、ベクトルの合成 | 複合代入(+=等)を先に作り、それを再利用する。 |
| 比較演算子 (<=>, ==) | 順序付け、等価判定 | C++20以降は <=> を活用し自動生成する。 |
| 入出力演算子 (<<, >>) | 標準ストリームへの表示・読込 | 非メンバ関数として定義し、第一引数はstd::ostream&等にする。 |
テンプレートとオーバーロードの競合
C++では、関数テンプレートもオーバーロードの対象となります。
特定の型に対してだけ特殊な処理を行いたい場合、テンプレートの特殊化ではなく、通常の関数によるオーバーロードを用いるのが一般的です。
オーバーロード解決のルールでは、テンプレートから生成された関数よりも、非テンプレートの関数(具体的な型を持つ関数)が優先される性質があるためです。
関数テンプレートとの優先順位
例えば、任意の型を受け取るテンプレート関数と、int型を明示的に受け取る通常関数がある場合、int型の引数で呼び出すと通常関数が選ばれます。
これにより、汎用的なアルゴリズムを提供しつつ、特定の型に対してのみ最適化された処理を記述することが可能になります。
#include <iostream>

// 汎用的なテンプレート
template <typename T>
void process(T value) {
    std::cout << "Generic process" << std::endl;
}

// int型専用のオーバーロード
void process(int value) {
    std::cout << "Specific process for int" << std::endl;
}

int main() {
    process(3.14); // テンプレート版が呼ばれる
    process(10);   // 通常関数版が呼ばれる
    return 0;
}Generic process
Specific process for intConceptsによる制約付きオーバーロードの革命
C++20以前では、特定の条件を満たす型に対してのみ関数を有効にするために「SFINAE(Substitution Failure Is Not An Error)」という複雑なテクニックが必要でした。
しかし、C++20で導入されたConcepts(コンセプト)により、オーバーロードの条件を極めて直感的に記述できるようになりました。
Conceptsを使用すると、テンプレート引数が満たすべき要件を明示し、その要件に基づいてオーバーロードを振り分けることができます。
requires句による分岐
requires句を使用することで、「この型が特定のメンバ関数を持っている場合」や「数値型である場合」といった制約を課すことができます。
これにより、意図しない型が渡された際のエラーメッセージが劇的に分かりやすくなるというメリットもあります。
次の例では、整数型と浮動小数点型で異なる処理を行うオーバーロードを、Conceptsを用いて実現しています。
#include <iostream>
#include <concepts>

// 整数型のみを受け付ける関数
template <typename T>
requires std::integral<T>
void compute(T value) {
    std::cout << "Integral compute: " << value << std::endl;
}

// 浮動小数点型のみを受け付ける関数
template <typename T>
requires std::floating_point<T>
void compute(T value) {
    std::cout << "Floating point compute: " << value << std::endl;
}

int main() {
    compute(100);    // 整数版
    compute(3.14f);  // 浮動小数点版
    // compute("test"); // コンパイルエラー:制約を満たさない
    return 0;
}Integral compute: 100
Floating point compute: 3.14より具体的な制約が優先されるルール
Conceptsを用いたオーバーロードでは、「より制約が強い(具体的な)」関数が優先的に選択されます。
例えば、「すべての数値型」を対象とするコンセプトと、「整数型かつ符号なし」を対象とするコンセプトの2つがある場合、後者の方が制約が強いため、条件に合致すれば優先されます。
これにより、従来のタグディスパッチのような複雑な手法を使わずに、洗練されたライブラリ設計が可能になりました。
実践的な設計ガイドライン
オーバーロードは非常に便利ですが、乱用は避けるべきです。
設計において最も重要なのは、「驚き最小の原則」に従うことです。
プログラマがその関数名を見たときに期待する動作と、実際の挙動が一致していなければなりません。
オーバーロードを避けるべきケース
引数の型が異なるだけで、全く異なる副作用を持つ関数をオーバーロードしてはいけません。
例えば、open(string filename) と open(int connection_id) は、名前は同じでも「ファイルを開く」動作と「通信コネクションを確立する」動作という、文脈の異なる操作を混同させる恐れがあります。
このような場合は、open_file や open_connection といった具体的な名前を付ける方が親切です。
デフォルト引数との使い分け
引数の数が異なるだけのオーバーロードを作成する場合、デフォルト引数で代用できることがあります。
しかし、デフォルト引数では対応できない「引数の型に基づいた本質的な処理の切り替え」が必要な場合にのみ、オーバーロードを選択すべきです。
コードの重複を避けるために、一方のオーバーロードから他方のオーバーロードを呼び出すという実装パターンも有効です。
まとめ
C++のオーバーロードは、言語の進化とともに、より安全で強力な道具へと変貌を遂げてきました。
単純な関数名の共有から始まり、演算子のカスタマイズ、そしてC++20のConceptsによる高度な制約制御まで、その適用範囲は多岐にわたります。
適切に設計されたオーバーロードは、ライブラリの利用者に直感的なインターフェースを提供し、ソースコードの記述量を減らしつつ、型の安全性を高めることができます。
最新の標準仕様を積極的に取り入れ、コンパイラの解決ルールを正しく理解することで、複雑なロジックをシンプルに隠蔽する美しいC++コードを目指しましょう。