
ソフトウェア開発の歴史において、今まさに未曾有の転換点が訪れています。
2026年5月現在、GitHubが発表した最新のインフラ状況に関するレポートは、世界中のエンジニアリングリーダーたちに衝撃を与えました。
GitHubのCTOであるVlad Fedorov氏は、2025年10月に開始した「10倍のキャパシティ向上計画」が、わずか数ヶ月で不十分になったと公表しています。
現在、彼らが設計目標としているのは、当初の想定を遥かに上回る「現在の30倍のスケール」に対応するインフラです。
この爆発的な需要増の背景にあるのは、AIコーディングエージェントがプロトタイプの段階を終え、開発組織における標準的なツールへと進化したことです。
しかし、コードが大量に生成される一方で、既存のソフトウェア開発ライフサイクル(SDLC)は、その圧倒的なボリュームを吸収しきれず、深刻な「検証のボトルネック」に直面しています。
GitHub CTOが突きつけた現実:30倍のキャパシティが必要な理由
10倍の計画を「破棄」させたAIエージェントの衝撃
GitHubが2025年後半に策定したロードマップでは、信頼性とフェイルオーバーの向上を目的として、10倍の負荷に耐えうるインフラ構築が進められていました。
しかし、2026年2月までのわずか4ヶ月間で、AIエージェントが生成するコード量とそのインタラクションが急増し、既存の予測が完全に覆されたのです。
Fedorov氏は、「今日のスケールに必要なのは10倍ではなく、30倍のデザインだ」と断言しました。
これは単なるルーチンワークとしての容量追加ではなく、「ソフトウェアの作られ方」そのものが根本から変容したことを意味しています。
もはや人間が手入力するコードの速度を基準にしたスケーリング計画は、現代の開発現場では通用しなくなっているのです。
ソフトウェア開発のライフサイクル(SDLC)が直面する構造的限界
AIエージェントによってコード生成のコストが限りなくゼロに近づく中、新たな課題として浮上しているのが、生成されたコードの「正当性」をいかに確認するかという問題です。
従来のSDLCは、人間がコードを書き、人間がレビューし、限られたリソースでテストを行うことを前提に設計されてきました。
しかし、エージェントが1人のエンジニアの数十倍の速度でプルリクエストを作成し続ける現状では、既存の検証パイプラインは容易にパンクしてしまいます。
ボリューム(生成量)が増えても、それをスループット(デリバリー量)に変換できない限り、組織としての生産性は向上しません。
このギャップこそが、現在のエンジニアリング組織が解決すべき最大の構造的課題です。
なぜ「検証(Validation)」がボトルネックになるのか
ボリューム(量)がスループット(成果)に変換されない理由
理論上、コードの生産量が30倍になれば、リリースされる新機能も30倍になるはずです。
しかし、現実にはコードの検証プロセスが「損失の多い変換器」として機能してしまっています。
検証はSDLCの中で最も時間がかかり、最も人間に依存し、最もエラーが発生しやすいプロセスだからです。
以下の表は、各開発段階における検証のコストと、不具合が発見された際の影響をまとめたものです。
| 開発フェーズ | 検証の主体 | 不具合修正のコスト | パイプラインへの影響 |
|---|---|---|---|
| インナーループ(作成時) | 開発者 / AI | 極めて低い | なし |
| CI (継続的インテグレーション) | 自動テスト | 低い | ビルド待ちの発生 |
| ステージング環境 | QA / 自動テスト | 高い | 環境の占有・デプロイ停止 |
| 本番環境 (Production) | ユーザー / 監視 | 致命的 | インシデント対応・切り戻し |
この表からわかる通り、検証が後回しになればなるほど、不具合修正のコストは「複利」のように増大していきます。
クラウドネイティブ構成による複雑性の増大
現代のアプリケーションは、独立したサービスが複雑に絡み合うマイクロサービスやクラウドネイティブなアーキテクチャを採用しています。
あるサービスで行われた変更が、依存関係にある他のサービスにどのような影響を及ぼすかを、ソースコードの静的解析だけで判断することは不可能です。
契約の不一致(Contract Drift)、レースコンディション、マルチテナント環境下のエッジケースなどは、実際にコードを動かしてみるまで明らかになりません。
AIエージェントが「コンパイルが通るコード」を書くことは容易ですが、「分散システム全体で正しく動作するコード」を書くことは極めて困難なのです。
「オープンループ」から「クローズドループ」への転換
現在のAIエージェントが抱える「片手落ち」の状態
現在普及している多くのAIエージェントは、いわば「オープンループ(開ループ)」の状態で動作しています。
彼らはコードを高速に書き上げますが、そのコードがシステム全体の中でどう振る舞うかを自ら確認する手段を持っていません。
ユニットテストをパスさせることはできても、外部APIとの連携やデータベースとの整合性までは関知できないのが現状です。
その結果、不完全なコードが次々と後続のパイプラインに流し込まれ、レビュー待ちの列やCIの失敗を増大させる結果を招いています。
自己検証型エージェントの必要性
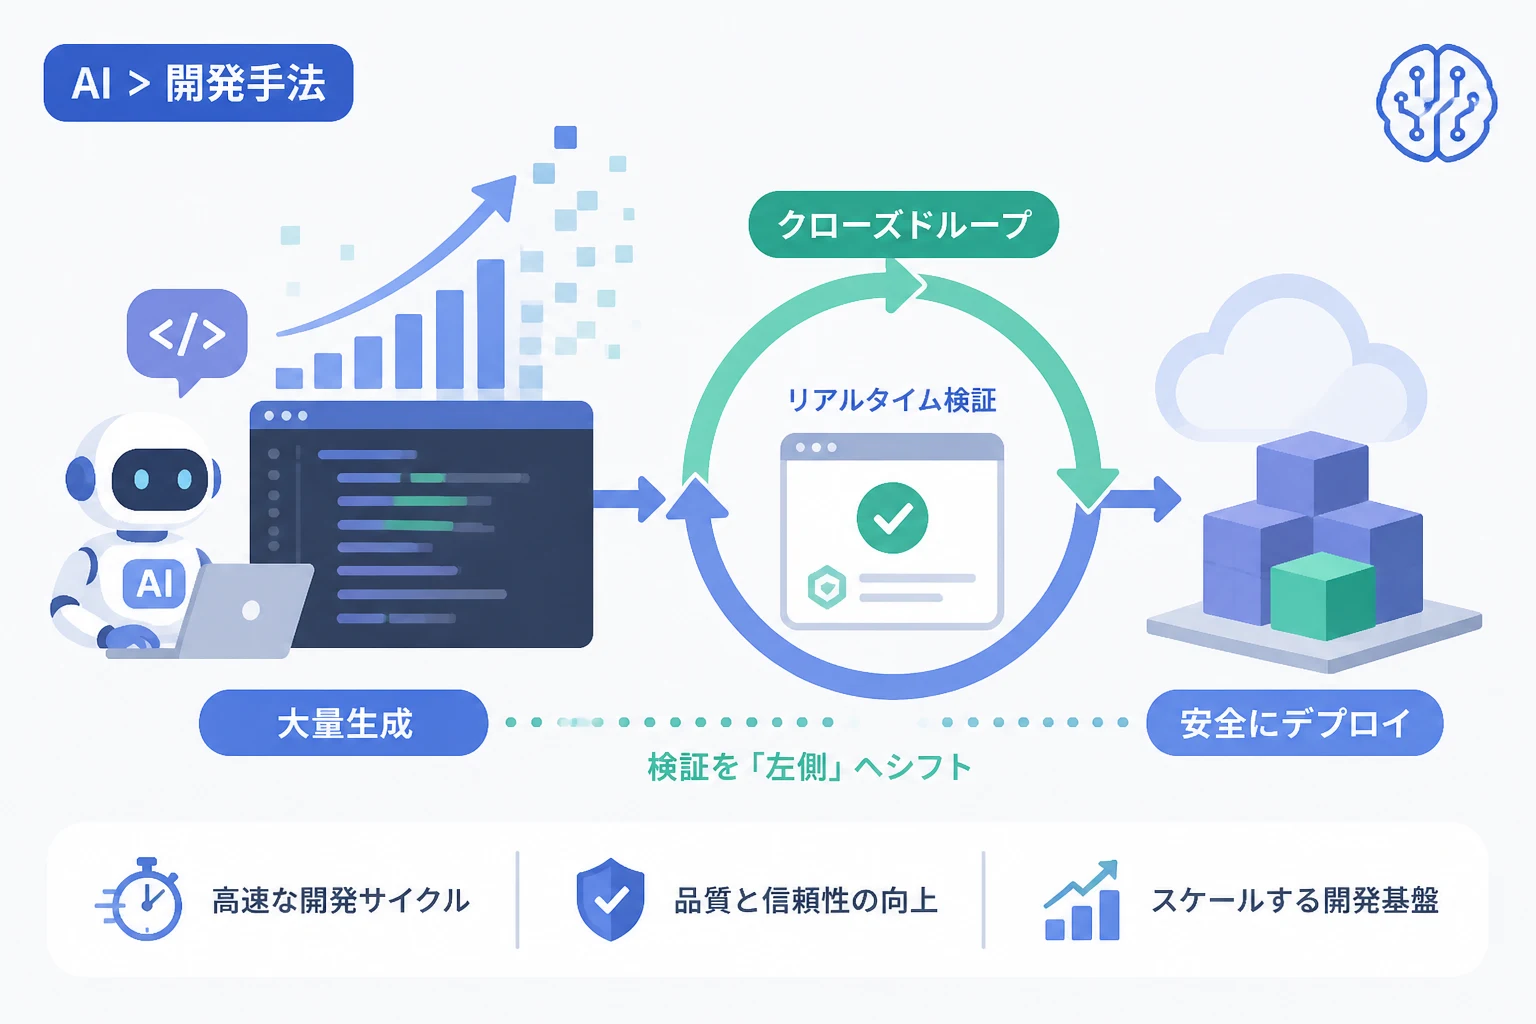
この問題を解決するための鍵は、エージェントが自身の書いたコードをインナーループ内で自己検証できる「クローズドループ(閉ループ)」の構築にあります。
エージェントがプルリクエストを出す前に、本番に近い環境で実際にコードを動かし、その結果をフィードバックとして受け取ることができれば、品質は劇的に向上します。
「書いてから確認する」のではなく、「確認しながら書く」というプロセスへの移行が必要です。
これにより、後続のCIや人間によるレビューは、最初の検証レイヤーではなく、最終的な「確認ステップ」へと役割を変えることができます。
技術的課題:リアルな環境での検証をいかに自動化するか
モックやユニットテストの限界
従来、インナーループでの検証にはモック(Mock)が多用されてきました。
しかし、モックは依存関係の「振る舞いの予測」に過ぎず、本物のサービスが返すリアルな挙動を再現することはできません。
複雑な分散システムにおいて、モックベースのテストをパスしたコードが本番でクラッシュするケースは珍しくありません。
エージェントに必要なのは、偽物のデータではなく、実際のサービスやトラフィックパターンにアクセスできる環境です。
エフェメラル環境(一時的な環境)の役割
そこで注目されているのが、「軽量なエフェメラル環境(一時的な実行環境)」の活用です。
Kubernetesネイティブな基盤を利用し、リクエストごとに分離されたプレビュー環境を瞬時に立ち上げる技術が登場しています。
Signadotのようなプラットフォームは、AIエージェントが本番に近いシグナルをインナーループで直接受け取ることを可能にします。
エージェントはこの環境を利用して、統合テスト、契約テスト、さらにはパフォーマンス測定までを自律的に実行できるようになります。
実践例:AIエージェントが自ら検証を行うパイプライン
以下に、AIエージェントが新しいAPIエンドポイントを実装し、自律的にエフェメラル環境で検証を行う際のスクリプト例を示します。
# AIエージェントが実行する自己検証プロセス
import time
from agent_sdk import CodeGenerator, EnvironmentManager, TestRunner

def autonomous_development_cycle(task_description):
    # 1. コード生成
    agent = CodeGenerator(model="gpt-5-pro")
    code_patch = agent.generate_fix(task_description)

    # 2. エフェメラル環境のプロビジョニング
    # 本番環境のサブセットをミラーリングした環境を瞬時に構築
    env_manager = EnvironmentManager()
    preview_env = env_manager.create_preview_env(patch=code_patch)

    try:
        # 3. リアルな依存関係を用いた統合テストの実行
        print(f"Testing in ephemeral environment: {preview_env.url}")
        results = TestRunner.run_integration_tests(env=preview_env)

        if results.all_passed():
            # 検証成功。プルリクエストを作成
            agent.submit_pull_request(code_patch, test_logs=results.logs)
        else:
            # 4. エラーフィードバックを元に再試行(クローズドループ)
            print("Tests failed. Refining code based on error logs...")
            new_patch = agent.refine_code(code_patch, results.errors)
            # 再検証プロセスへ...

    finally:
        # 環境のクリーンアップ
        env_manager.delete_env(preview_env)

# 実行
autonomous_development_cycle("Add rate-limiting to the checkout API")Testing in ephemeral environment: https://preview-env-xyz123.signadot.dev
Running 15 integration tests...
Test 1: GET /health - PASSED
Test 2: POST /checkout (valid) - PASSED
Test 3: POST /checkout (rate-limit-trigger) - FAILED (Expected 429, got 500)
Tests failed. Refining code based on error logs...
Re-generating code to handle RateLimitExceeded exception correctly.
Testing in ephemeral environment: https://preview-env-abc456.signadot.dev
All 15 integration tests PASSED.
Pull Request #1234 created successfully with validation logs.このように、エージェントが「自分の失敗を自分で修正する」サイクルを回すことで、人間が介在するパイプラインには、すでに動作が保証された高品質なコードのみが届くようになります。
エンジニアリングリーダーが今すぐ検討すべき戦略的問い
GitHubが直面している「30倍のスケーリング」という課題は、決して他人事ではありません。
あらゆる組織が、AIによって加速された開発スピードにインフラとプロセスを適応させる必要があります。
リーダーが自問すべきは、「自社のAIエージェントはオープンループで動いているか、それともクローズドループか」という点です。
単にAIツールを導入するだけでは、検証のボトルネックを悪化させ、組織の技術負債を急速に積み上げるリスクがあります。
投資すべきは、AIによる「執筆」のスピードアップだけではなく、AIによる「検証」の自動化と、それを支えるモダンなテスト基盤です。
まとめ
AIエージェントによる「コード爆発」は、すでに現実のものとなっています。
GitHubのCTO Vlad Fedorov氏が警告するように、これまでの10倍という予測すら通用しない「30倍のスケール」に対応するためには、開発パイプラインの構造そのものを再考しなければなりません。
鍵となるのは、検証プロセスを限りなく「左(開発の初期段階)」に寄せ、AIエージェントが自ら品質を担保できるクローズドループを構築することです。
エフェメラル環境を駆使し、リアルなフィードバックをインナーループに取り入れることで、爆発的なコード量は真の生産性向上へと変換されます。
検証のボトルネックを打破し、AIと共に進化する新しいSDLCの構築こそが、これからのエンジニアリング組織の勝敗を分けることになるでしょう。