
Rubyは誕生以来、一貫して「プログラマの幸福」を追求し続けてきた言語です。
2023年末にリリースされたRuby 3.3は、その哲学を継承しつつ、次世代の標準を見据えた大きな技術的転換点となりました。
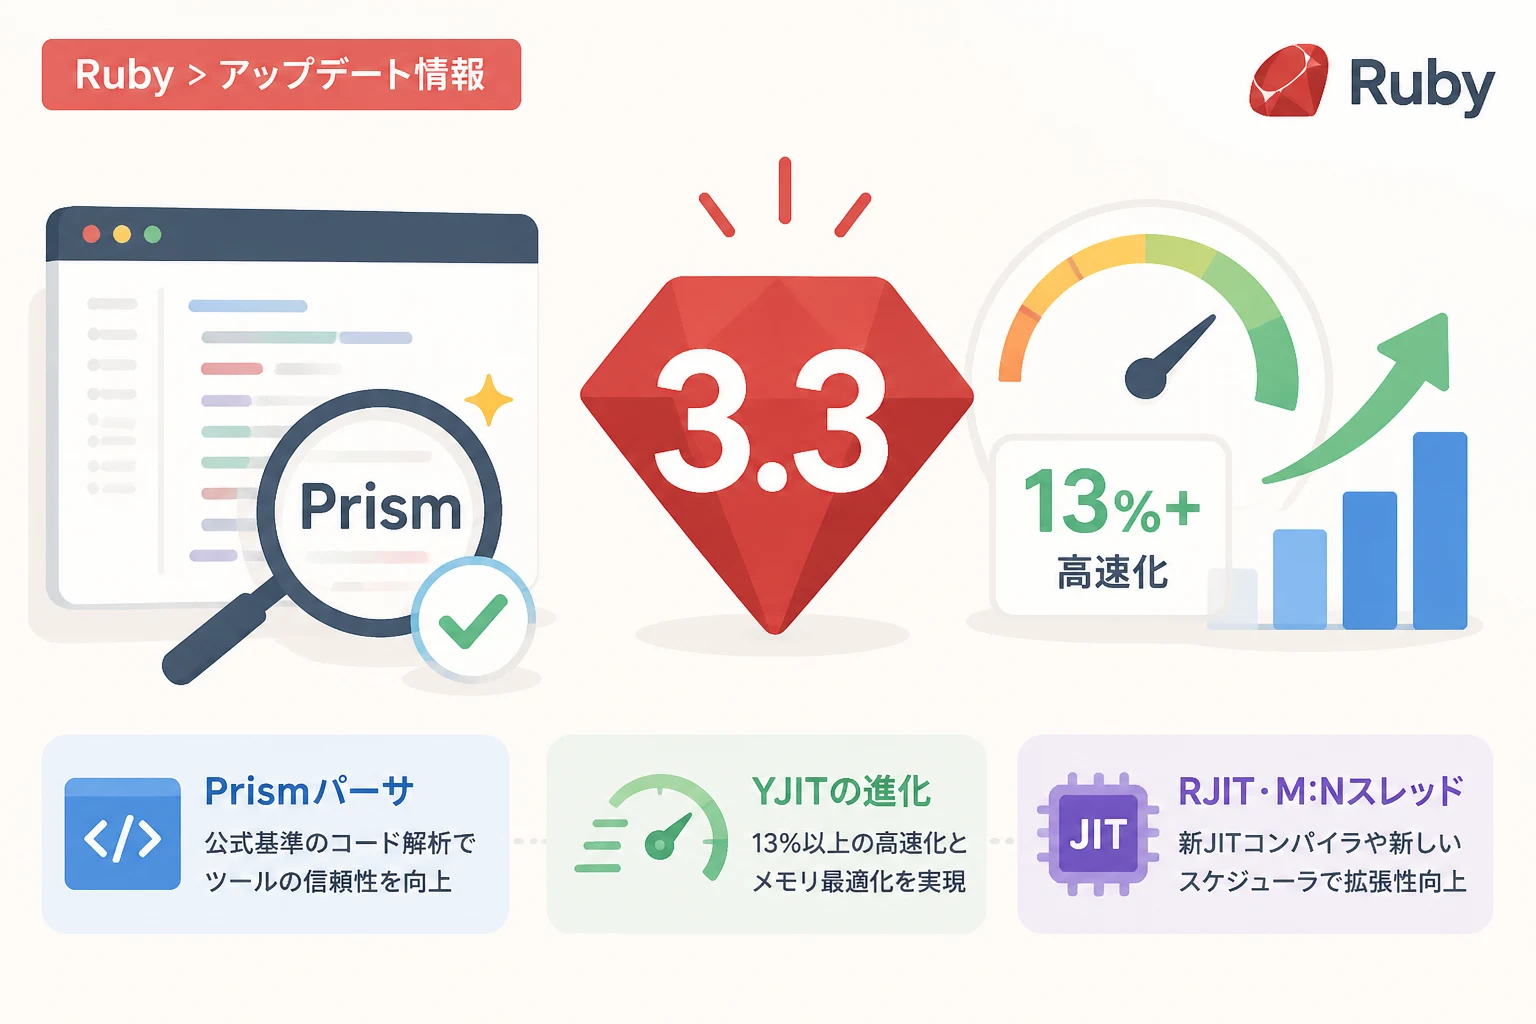
特に新しいパーサであるPrismの導入や、実行速度を劇的に向上させるYJITのさらなる進化は、Rubyエコシステム全体に多大な恩恵をもたらしています。
本記事では、Ruby 3.3における主要な新機能と変更点を整理し、開発者が知っておくべきパフォーマンス改善の要点を詳しく解説します。
Ruby 3.3の立ち位置と進化の方向性
Ruby 3.0が掲げた「Ruby 3×3(実行速度を3倍にする)」という目標は、JIT(Just-In-Time)コンパイラの進化によって着実に現実のものとなってきました。
Ruby 3.3はその延長線上にありつつも、単なる速度向上にとどまらない「基盤の再構築」を強く意識したバージョンといえます。
これまでのRubyは、メンテナンスが困難になりつつあった古いパーサや、メモリ消費が課題となっていた初期のJIT実装を抱えていました。
Ruby 3.3では、これらの技術的負債を解消し、将来のバージョンでも持続可能な開発を可能にするための新しいアーキテクチャが採用されています。
具体的には、パーサの刷新、新しいJITコンパイラの導入、そしてガベージコレクション(GC)の最適化がその柱となっています。
新しいパーサ「Prism」の導入
Ruby 3.3において最も技術的に注目すべき変更の一つが、新しいパーサであるPrism(プリズム)の導入です。
当初は yarp (Yet Another Ruby Parser)という名称で開発されていましたが、正式にPrismとしてRuby本体に同梱されることになりました。
Prismとは何か
Prismは、Rubyコードを解析して抽象構文木(AST)を生成するための、移植性が高く保守しやすい再帰下降パーサです。
従来のRubyのパーサは parse.y と呼ばれる巨大なファイルに依存しており、Bisonというジェネレータを使用していました。
しかし、この仕組みは複雑で、CRuby以外の実装(JRubyやTruffleRubyなど)や、静的解析ツールがRubyの構文を正確に追従することを困難にしていました。
PrismはC言語で記述されており、以下の特徴を持っています。
- 高い互換性:CRubyのセマンティクスを完全に再現するように設計されています。
- エラーリカバリの強化:タイポや未完成のコードが含まれていても、解析を中断せずに可能な限り情報を抽出できます。
- 独立したライブラリ:Ruby本体から独立してコンパイル・利用が可能なため、ツール開発が容易になります。
なぜPrismが必要だったのか
これまでのRubyエコシステムでは、エディタのLSP(Language Server Protocol)やLinter(RuboCopなど)が、それぞれ独自にパーサを実装したり、標準の ripper を利用したりしていました。
しかし、Rubyの構文は非常に柔軟で複雑なため、公式の解析結果と微妙に異なる挙動を示すことが課題でした。
Prismが標準化されることで、あらゆるツールが公式と同じ基準でコードを解析できるようになります。
これにより、開発ツールの信頼性が向上し、新しい構文が導入された際の影響も最小限に抑えることができます。
既存コードへの影響と導入方法
Ruby 3.3では、デフォルトのパーサが即座に入れ替わるわけではありません。
従来のパーサも引き続き利用可能ですが、以下のライブラリを通じてPrismを試すことができます。
# Prismを使用してソースコードを解析する例
require "prism"

code = "puts 'Hello, Ruby 3.3'"
result = Prism.parse(code)

# 抽象構文木の確認
puts result.value
将来的にPrismはデフォルトのパーサになる予定ですが、Ruby 3.3の段階では「ツール作成者やライブラリ開発者向けの強力な新オプション」という位置づけです。
パフォーマンスの劇的な向上:YJITの進化
Shopifyによって開発が主導されているYJIT(Yet Another Just-in-Time Compiler)は、Ruby 3.3で劇的な進化を遂げました。
3.2以前と比較して、多くの実用的なアプリケーションでさらなる高速化が達成されています。
実行速度の改善
Ruby 3.3のYJITは、レジスタ割り当ての最適化や、コード生成の効率化により、Ruby 3.2よりも約13%以上の高速化(ベンチマークによる)を実現しています。
特にWebアプリケーションのような、メソッド呼び出しが頻発するワークロードにおいてその真価を発揮します。
また、以前のバージョンでは特定の命令セットのみが最適化の対象でしたが、3.3ではより広範囲のRubyメソッドがインライン化されるようになり、オーバーヘッドが削減されました。
メモリ使用量の最適化
YJITの最大の懸念点の一つは、コンパイルされたマシンコードを保持するためのメモリ消費量でした。
Ruby 3.3では、この問題に対して強力なアプローチが取られています。
- コードGCの導入:使用されなくなったコンパイル済みコードをメモリから解放する仕組みが強化されました。
- メタデータの削減:各命令が付随して持つ情報をスリム化し、メモリ効率を高めました。
これにより、メモリ制限の厳しいコンテナ環境やクラウドプラットフォームでも、YJITを有効にしやすくなっています。
YJITを有効にするには、実行時に以下のオプションを付与します。
# Ruby実行時にYJITを有効化する
ruby --yjit your_script.rb実行中にYJITの状態を確認するには、RubyVM::YJIT.runtime_stats を使用します。
# YJITの統計情報を出力する例
if defined?(RubyVM::YJIT) && RubyVM::YJIT.enabled?
  stats = RubyVM::YJIT.runtime_stats
  puts "コンパイルされたメソッド数: #{stats[:compiled_method_count]}"
end
新たなJITコンパイラ「RJIT」
Ruby 3.3では、これまで実験的に導入されていたMJITが削除され、新たにRJITが導入されました。
RJITの役割と特徴
RJITは「Pure Ruby JIT」を目指して開発されているプロトタイプ的なコンパイラです。
MJITがC言語のコンパイラ(gccやclang)を外部プロセスとして呼び出していたのに対し、RJITはRuby自身で書かれたJIT実装をベースにしています。
現時点でのユーザーへの推奨は引き続きYJITですが、RJITの存在はRuby内部の仕組みをRubyで改善していくという、将来的な拡張性を示唆しています。
開発者にとっては、JITのロジックを読み解く際にC言語の深い知識がなくても理解しやすくなるというメリットがあります。
開発効率を高めるライブラリと新機能
言語のコア部分以外でも、Ruby 3.3は開発体験を向上させる多くのアップデートを含んでいます。
標準添付ライブラリのアップデート
Ruby 3.3では、多くの標準ライブラリがGem化(Default Gems / Bundled Gems)されました。
これにより、Ruby本体のリリースサイクルに縛られず、個別のライブラリをアップデートすることが可能になっています。
特に注目すべきは以下の点です。
| カテゴリ | 変更内容 |
|---|---|
base64 | 標準ライブラリからGemに移行。明示的な require が推奨されるようになりました。 | |
rbs | 型定義ファイル関連のツールが大幅にアップデートされ、型推論の精度が向上しました。 | |
debug | デバッガのパフォーマンスが改善され、リモートデバッグ機能が強化されました。 |
IRBとデバッグ体験の向上
Rubyの対話型シェルであるIRB(Interactive Ruby)も、3.3に合わせて進化しました。
- オートコンプリートの高速化:入力中の候補表示がよりスムーズになりました。
- 表示の改善:シンタックスハイライトの精度が向上し、大きなデータ構造を表示する際の視認性が高まりました。
- デバッグコマンドの統合:IRB内から直接デバッガの機能を呼び出すことが容易になり、開発中の試行錯誤がよりスピーディに行えるようになっています。
# IRBでの新機能体験(Ruby 3.3以降)
# オートコンプリートがより賢くなり、ドキュメントの表示も統合されています
[1, 2, 3].ma # ここでTabを押すと map などの候補が即座に出現
実践的なコード例と変更点
Ruby 3.3で導入された小さな、しかし便利な変更点についても見ていきましょう。
Range#step の動作改善
範囲オブジェクト(Range)に対して step を適用した際の挙動が一部洗練されました。
# Ruby 3.3でのRange#step
(1..10).step(2).each do |n|
  puts n
end

# 出力結果
# 1
# 3
# 5
# 7
# 9
また、Ruby 3.3からは Range#step が、浮動小数点を扱う際により正確な計算を行うよう内部的に調整されています。
警告とエラーメッセージの親切化
Ruby 3.3では、初心者が陥りやすいミスに対して、より具体的な解決策を提示するようになりました。
例えば、メソッド名のタイポに対して「Did you mean?」が表示される精度が向上し、適切な候補が提案されやすくなっています。
また、「将来のバージョンで廃止される予定の機能」に対する警告メッセージが整理され、どのGemが原因で警告が出ているのかが特定しやすくなりました。
これにより、大規模なRailsプロジェクトなどの移行作業が大幅に軽減されます。
パフォーマンス計測の具体例
実際にRuby 3.3とYJITを組み合わせた場合に、どの程度のパフォーマンス向上が見込めるかを、簡単なマイクロベンチマークで確認してみましょう。
require 'benchmark'

def calculate_pi(iterations)
  pi = 0.0
  iterations.times do |i|
    denominator = 2 * i + 1
    if i.even?
      pi += 4.0 / denominator
    else
      pi -= 4.0 / denominator
    end
  end
  pi
end

# 1,000万回のループで計算
n = 10_000_000

Benchmark.bm do |x|
  x.report("Calculation:") { calculate_pi(n) }
endこのコードを、YJITを無効にした状態と有効にした状態で比較すると、多くの環境で2倍から3倍程度の実行速度の差が出ることが確認できます。
Ruby 3.3では、この「JITによる恩恵」を受けられるコードの範囲が広がっているのが特徴です。
M:N スレッドスケジューラの導入(実験的)
Ruby 3.3のもう一つの野心的な試みが、M:N スレッドスケジューラの導入です。
これは、複数のRubyスレッド(M)を、より少ない数のOSネイティブスレッド(N)に割り当てる仕組みです。
従来のRubyでは、1つのRubyスレッドに対して1つのOSスレッドを割り当てていました。
しかし、これでは数千、数万という大量のスレッドを生成した際に、OSのリソースを過剰に消費してしまうという問題がありました。
Ruby 3.3では、Ractor(並列処理機構)内でこのM:Nスケジューラが試験的に導入されており、将来的に「スレッドの生成コストを劇的に下げる」ための基盤が整えられました。
現時点では実験的なステータスですが、大量の同時接続を捌くサーバーサイドの開発において、非常に大きな可能性を秘めています。
パフォーマンス改善の要点を整理
ここまで解説してきたRuby 3.3のパフォーマンス改善を整理すると、以下の3点に集約されます。
- JITの成熟:YJITが実用レベルを超え、デフォルトで有効にすることを検討すべき段階に達した。
- メモリ効率の追求:単に速いだけでなく、メモリ消費を抑えることで、クラウドネイティブな環境への適応力を高めた。
- 基盤の近代化:Prismによる解析の高速化や、GCの最適化(Variable Width Allocationの進展など)により、言語全体の足腰が強くなった。
これらの改善は、個別のコード修正なしに「Rubyのバージョンを上げるだけ」で恩恵を受けられるものが多いため、古いバージョンを利用しているプロジェクトにとって、3.3への移行は非常に高い投資対効果をもたらします。
まとめ
Ruby 3.3は、Rubyという言語が30年以上の歴史を持ちながらも、いまだに凄まじいスピードで進化し続けていることを証明したアップデートです。
Prismパーサの導入は、今後のツール開発や言語の拡張性を飛躍的に高める礎となり、YJITの進化は「Rubyは遅い」というかつての常識を過去のものにしようとしています。
また、標準ライブラリの整理やデバッグ体験の向上は、日々の開発業務におけるストレスを軽減し、より本質的なロジックの実装に集中できる環境を提供してくれます。
2026年現在、多くのプロジェクトがRuby 3.3以降をベースに運用されています。
もし、まだ3.2以前のバージョンを利用しているのであれば、まずはYJITの有効化から検討し、この洗練されたパフォーマンスと新しい開発体験を取り入れてみてはいかがでしょうか。
Ruby 3.3へのアップデートは、単なるメンテナンスではなく、「将来への強力な技術投資」となるはずです。