
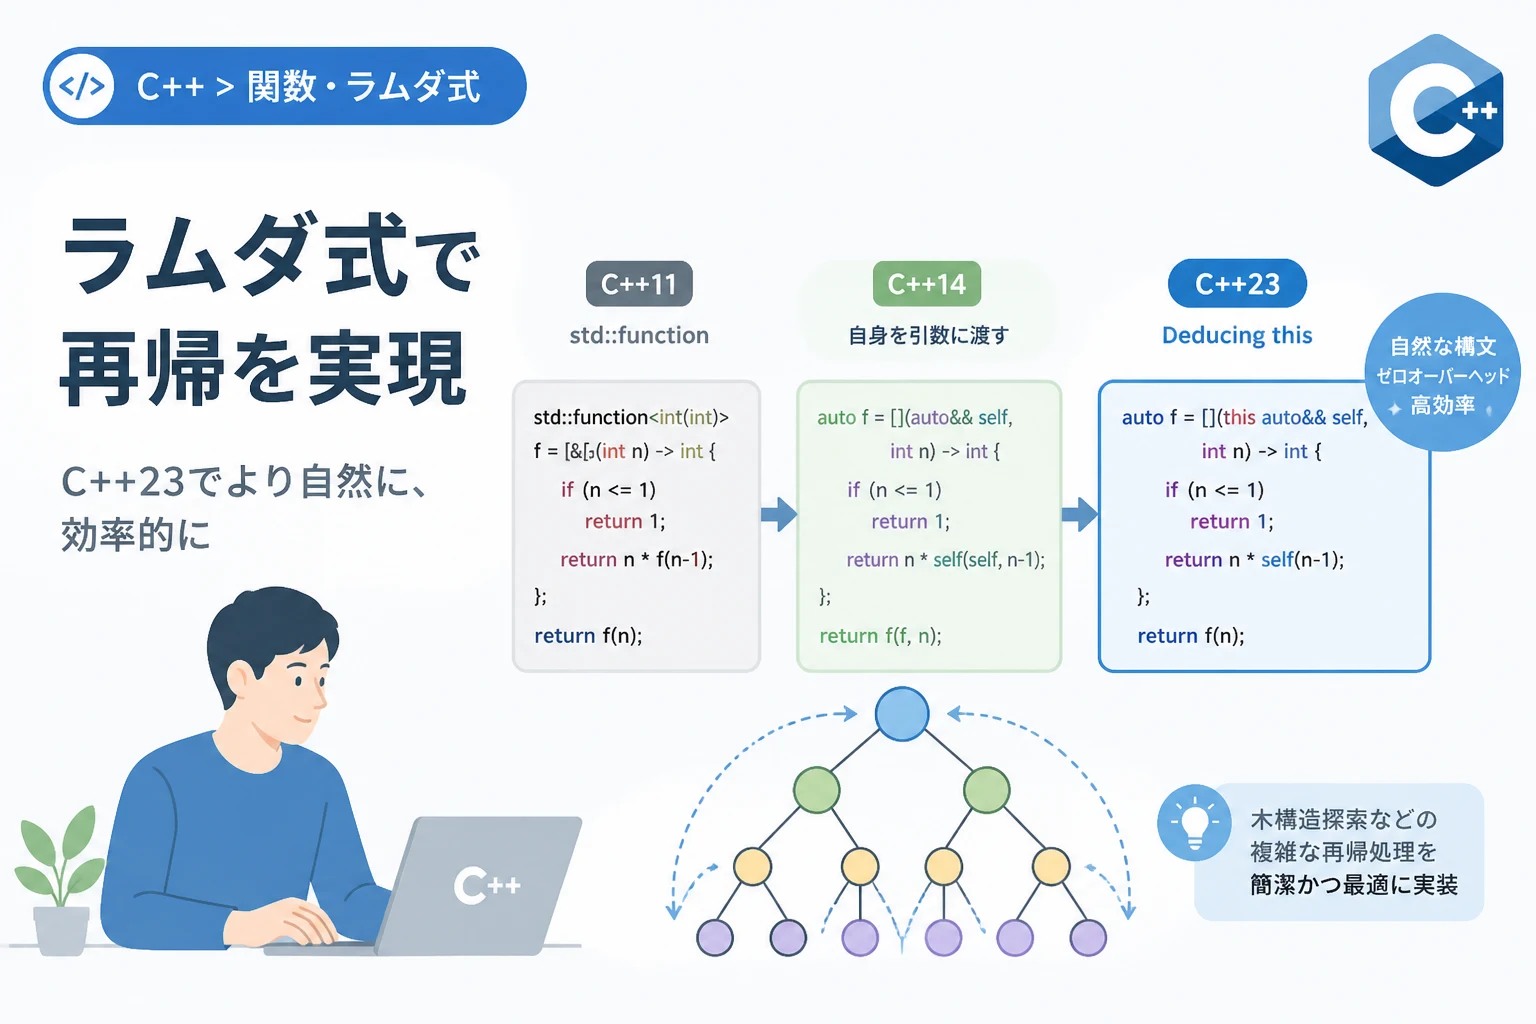
C++11で導入されたラムダ式は、現代的なC++プログラミングにおいて欠かせないツールとなりました。
関数オブジェクトをその場で定義できる利便性は、STLアルゴリズムの利用や非同期処理の記述を劇的に簡素化しました。
しかし、ラムダ式において長年の課題となっていたのが「自分自身を呼び出す再帰処理」をいかに簡潔に記述するかという点です。
従来のC++では、ラムダ式が匿名クラスのインスタンスであるという性質上、自分自身の名前をスコープ内で参照することができず、やや変則的な実装が必要でした。
しかし、C++23に至るまでの進化の過程で、この問題は非常に洗練された形で解決されました。
本記事では、古典的なstd::functionを用いた手法から、最新のC++23で導入された「deducing this(明示的なオブジェクトパラメータ)」によるスマートな再帰実装まで、その変遷と具体的なコード例を詳しく解説します。
ラムダ式と再帰の難しさ
C++におけるラムダ式は、コンパイル時に生成される一意の匿名クラス(クロージャ型)です。
この性質により、ラムダ式の中で自分自身を呼び出そうとしても、その定義が完了するまでは「自分自身の型」も「インスタンスの名前」も確定していないため、単純な関数のように名前を呼ぶことができません。
例えば、以下のコードはコンパイルエラーとなります。
auto fib = [](int n) {
    if (n <= 1) return n;
    return fib(n - 1) + fib(n - 2); // エラー:fibの名前が解決できない
};
この問題を回避するために、開発者は歴史的にいくつかの「テクニック」を駆使してきました。
まずは、最も古くから使われている手法から見ていきましょう。
古典的手法:std::functionを用いた再帰
C++11の時代から広く使われてきたのが、std::functionに自分自身を格納し、それをキャプチャする方法です。
実装の仕組み
std::functionは型消去を用いた汎用関数ラッパーです。
ラムダ式の型をあらかじめ固定し、その変数を参照キャプチャ(&)することで、ラムダ式の内部から自分自身を呼び出すことが可能になります。
#include <iostream>
#include <functional>

int main() {
    // std::functionで型を明示的に宣言
    std::function<int(int)> factorial = [&](int n) {
        if (n == 0) return 1;
        // キャプチャしたfactorialを呼び出す
        return n * factorial(n - 1);
    };

    std::cout << "5! = " << factorial(5) << std::endl;
    return 0;
}5! = 120利点と欠点
この手法の最大の利点は、「読みやすさ」です。
関数プロトタイプを事前に定義するため、再帰構造が直感的に理解しやすくなります。
一方で、いくつかの重大な欠点も存在します。
- パフォーマンスの低下:
std::functionは型消去を行うため、動的なメモリ確保や仮想関数の呼び出しに似たオーバーヘッドが発生します。インライン化も阻害されやすいため、非常に頻繁に呼ばれる処理には向きません。 - 参照キャプチャのリスク:外部変数を参照キャプチャしているため、ラムダ式の寿命が
std::functionより短くなった場合にダングリングリファレンスが発生する恐れがあります。
C++14/17:汎用ラムダと自己引渡し
C++14で導入された「汎用ラムダ(Generic Lambda)」を利用すると、std::functionを使わずに再帰を実現できます。
実装の仕組み
この手法では、ラムダ式の第一引数に「自分自身の関数オブジェクト」を受け取るように設計します。
呼び出し時には、自分自身を引数として渡す(self(self, args...))というトリッキーな記述になります。
#include <iostream>

int main() {
    // 第一引数にselfを受け取るように定義
    auto fib = [](auto self, int n) -> int {
        if (n <= 1) return n;
        // 自分自身を引数として渡して再帰呼び出し
        return self(self, n - 1) + self(self, n - 2);
    };

    // 呼び出し時に自分自身(fib)を渡す必要がある
    std::cout << "Fibonacci(10) = " << fib(fib, 10) << std::endl;

    return 0;
}Fibonacci(10) = 55評価
この手法はゼロオーバーヘッドです。
std::functionのような実行時のコストは発生せず、コンパイラによる最適化(インライン化)も期待できます。
しかし、「呼び出し側の記述が不自然になる」という点が大きなデメリットです。
fib(fib, 10)のように、同じ名前を二度書かなければならないのは、APIのデザインとして美しくありません。
これを解決するために、ヘルパー関数や「Yコンビネータ(不動点演算子)」を実装するケースもありますが、コードが複雑化しやすいため、一般的には敬遠されがちでした。
C++23の革新:Deducing thisによる自己再帰
C++23では、クラスのメンバ関数やラムダ式において、そのオブジェクト自身を明示的な引数として受け取ることができる「Deducing this」(明示的なオブジェクトパラメータ)が導入されました。
これにより、ラムダ式の再帰はついに「完成形」を迎えました。
実装の仕組み
ラムダ式の引数リストの最初に this auto&& self のように記述します。
これにより、そのラムダクロージャ自体が self という名前で参照可能になります。
#include <iostream>

int main() {
    // C++23: explicit object parameter を使用
    auto factorial = [](this auto& self, int n) -> int {
        if (n == 0) return 1;
        // 第一引数を明示せずに、自然な形で再帰呼び出しが可能
        return n * self(n - 1);
    };

    // 呼び出し側は通常の関数と同じ!
    std::cout << "5! (C++23) = " << factorial(5) << std::endl;

    return 0;
}
Deducing thisのメリット
- 自然な呼び出し構文:呼び出し側で自分自身を引数として渡す必要がなくなりました。
- 高いパフォーマンス:テンプレートベースの静的な解決であるため、
std::functionのような実行時コストがかかりません。 - カプセル化の向上:型推論(
auto)が働くため、複雑なクロージャ型を意識せずに安全に再帰を記述できます。
実践的な応用例:木構造の探索
再帰が最も威力を発揮するのは、木構造やグラフの探索です。
ここでは、バイナリツリーのノードを深さ優先探索(DFS)で走査する例を考えてみましょう。
#include <iostream>
#include <vector>
#include <memory>

struct Node {
    int value;
    std::unique_ptr<Node> left, right;
    Node(int v) : value(v) {}
};

int main() {
    // ツリーの構築
    auto root = std::make_unique<Node>(1);
    root->left = std::make_unique<Node>(2);
    root->right = std::make_unique<Node>(3);
    root->left->left = std::make_unique<Node>(4);

    // C++23を用いた深さ優先探索
    auto dfs = [](this auto& self, Node* node) -> void {
        if (!node) return;

        std::cout << node->value << " "; // 訪問
        self(node->left.get());        // 左部分木へ
        self(node->right.get());       // 右部分木へ
    };

    std::cout << "DFS traversal: ";
    dfs(root.get());
    std::cout << std::endl;

    return 0;
}DFS traversal: 1 2 4 3このように、アルゴリズムの内部だけで使用する補助的な再帰処理を、名前空間を汚染することなく、かつ効率的に記述できるのがC++23スタイルの強みです。
手法の比較まとめ
各手法の特徴を以下の表にまとめました。
| 手法 | 導入バージョン | パフォーマンス | 記述の簡潔さ | 推奨されるケース |
|---|---|---|---|---|
std::function | C++11 | 低い | 普通 | 互換性重視、速度不問 |
自己引渡し (self(self,...)) | C++14 | 高い | 低い (呼び出しが煩雑) | C++20以前の高速化 |
| Deducing this | C++23 | 高い | 非常に高い | モダンな開発の標準 |
パフォーマンスと最適化の注意点
ラムダ式の再帰においてパフォーマンスを追求する場合、「末尾再帰最適化(TCO: Tail Call Optimization)」を意識することが重要です。
C++の言語仕様自体は末尾再帰最適化を保証していませんが、主要なコンパイラ(GCC, Clang, MSVC)は、条件が整えば再帰呼び出しをループへと変換します。
しかし、std::functionを使用している場合、間接参照が発生するため、コンパイラが末尾再帰を最適化するのは非常に困難になります。
一方で、C++23のthis autoを用いた手法であれば、コンパイラは呼び出し先を静的に特定できるため、最適化の可能性が飛躍的に高まります。
大規模な計算や深い再帰が予想される場合は、C++23以降の利用が強く推奨されます。
まとめ
C++のラムダ式における再帰実装は、言語の進化と共に洗練されてきました。
- C++11では
std::functionによる「動的な解決」 - C++14/17では 汎用ラムダによる「静的だが不格好な解決」
- C++23では Deducing this による「静的かつ優雅な解決」
今、新しくプロジェクトを立ち上げるのであれば、C++23をベースに設計するのが最も効率的です。
もし古い規格に縛られている環境であっても、それぞれの特徴とコストを理解しておくことで、最適な設計を選択できるはずです。
ラムダ式による再帰は、単なるコードの短縮テクニックではなく、「処理の局所性を高め、保守性を向上させるための強力な武器」です。
ぜひ、日々の開発に活用してみてください。