
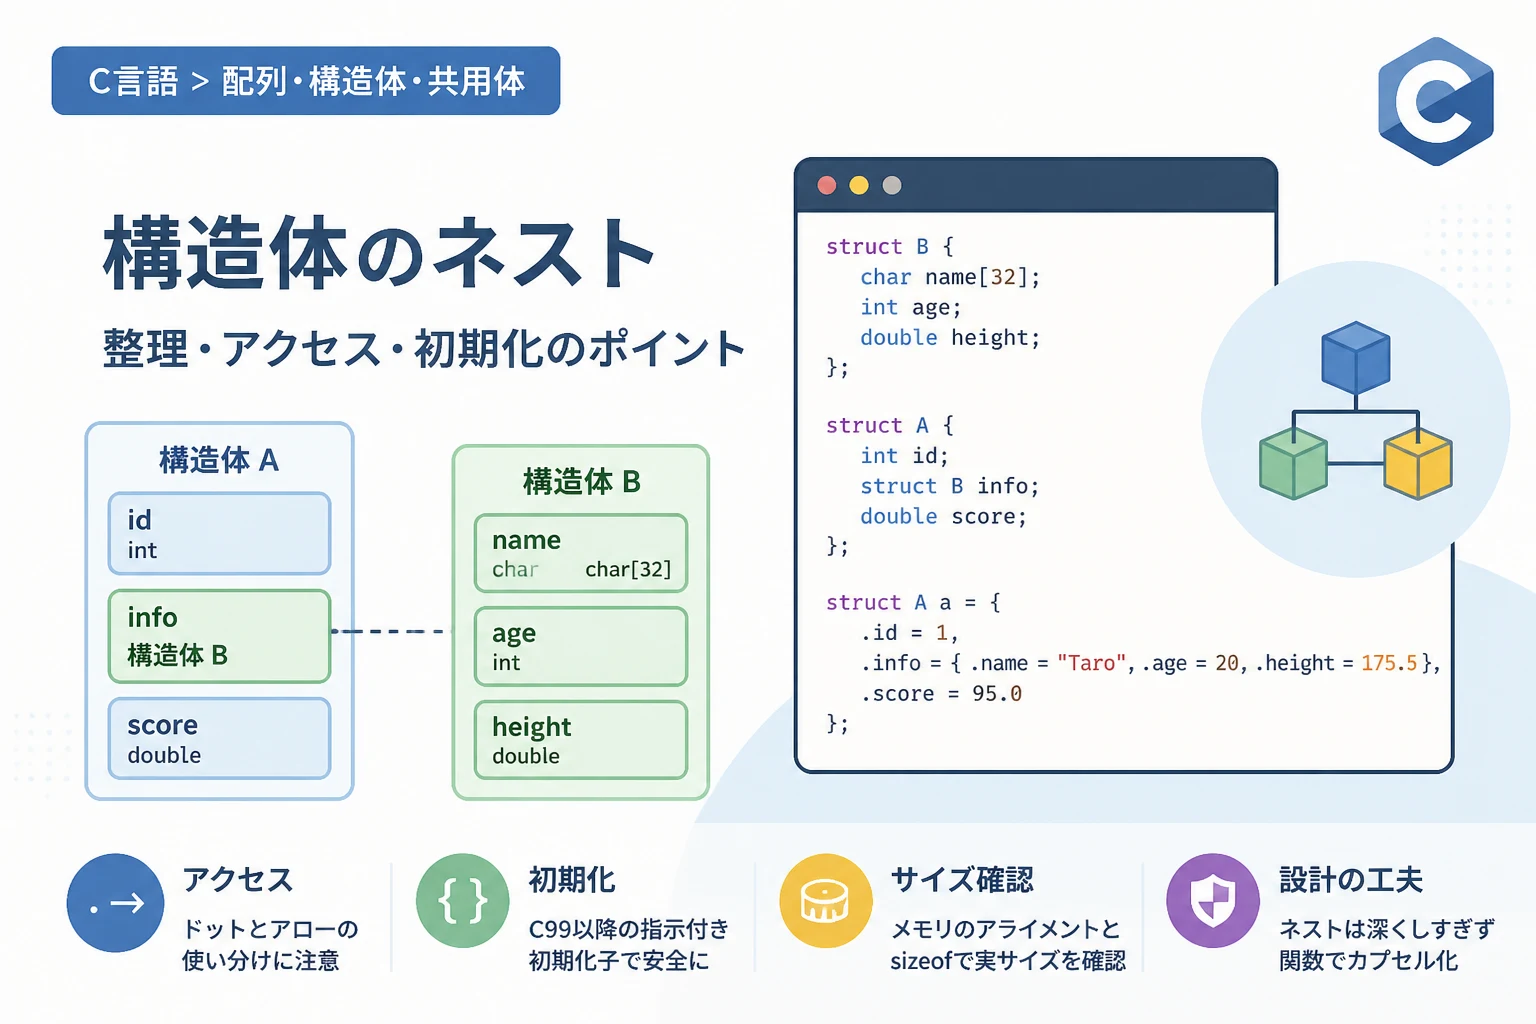
C言語におけるプログラミングにおいて、データの管理をいかに効率的に、かつ論理的に行うかは、保守性の高いソフトウェアを開発する上での最重要課題の一つです。
その中心的な役割を担うのが構造体 (struct)です。
構造体は、異なるデータ型を一つのまとまりとして扱うための強力な仕組みですが、複雑なシステムを設計する際には、構造体のメンバとして別の構造体を含める、いわゆる「構造体のネスト (入れ子)」が必要不可欠となります。
本記事では、このネストされた構造体の定義方法から、メンバへのアクセス手法、初期化における厳密なルール、そしてメモリ管理上の注意点に至るまで、実務で即戦力となる知識を詳しく解説していきます。
構造体の中に構造体を定義する基礎知識
C言語では、ある構造体のメンバとして別の構造体変数を宣言することが可能です。
これにより、関連性の高いデータを階層的に整理できるようになります。
例えば、「社員」という情報を管理する場合、社員名や社員番号に加えて「住所」という情報が必要になります。
住所自体も、郵便番号、都道府県、市区町村といった複数のデータから構成されるため、これらを独立した構造体として定義し、社員構造体の中に組み込むのが一般的です。
構造体のネストを実現する2つの手法
構造体を入れ子にする方法は、大きく分けて2つのパターンが存在します。
一つは、あらかじめ定義された構造体型を利用する方法、もう一つは、構造体定義の中で別の構造体を定義する方法です。
1. 外部で定義した構造体を利用する方法
この手法は、コードの再利用性を高めるために最も推奨される方法です。
先に子となる構造体を定義しておき、それを親となる構造体のメンバとして利用します。
#include <stdio.h>

// 住所情報を管理する構造体
struct Address {
    char postal_code[8];
    char city[50];
};

// 社員情報を管理する構造体
struct Employee {
    int id;
    char name[50];
    struct Address addr; // Address構造体をメンバに持つ
};

int main() {
    struct Employee emp;
    printf("Employee構造体のサイズ: %zuバイト\n", sizeof(emp));
    return 0;
}この方法の利点は、struct Address を他の構造体 (例えば「顧客情報」など) でも使い回せる点にあります。
プログラムの規模が大きくなるほど、このようなコンポーネント化された設計が重要になります。
2. 内部で構造体を定義する方法 (無名構造体の活用)
特定の構造体の中でしか使用しない一時的なデータ構造の場合、親構造体の内部で直接構造体を定義することも可能です。
struct Robot {
    int serial_number;
    struct {
        int x;
        int y;
    } position; // Robot内でのみ有効な座標データ
};
このように、内部で直接定義された構造体はタグ名を省略することもできますが、後からその型を用いて他の変数を宣言することができないため、汎用性は低くなります。
特定のデータコンテナ内でのみ意味を持つ構造に適しています。
構造体メンバへのアクセス手法
ネストされた構造体のメンバにアクセスするには、ドット演算子 (.) を多段階に繋げて記述します。
また、ポインタを経由する場合は、アロー演算子 (->) とドット演算子を組み合わせて使用します。
ドット演算子による階層アクセス
ドット演算子は、構造体変数の実体からそのメンバを参照するために使用されます。
ネストされている場合は、親から子、子から孫へと順にアクセスします。
#include <stdio.h>
#include <string.h>

struct Date {
    int year;
    int month;
    int day;
};

struct Event {
    char title[100];
    struct Date date;
};

int main() {
    struct Event meeting;

    // ネストされたメンバへの値の代入
    meeting.date.year = 2026;
    meeting.date.month = 5;
    meeting.date.day = 15;
    strcpy(meeting.title, "プロジェクト進捗会議");

    printf("イベント: %s\n", meeting.title);
    printf("開催日: %d年%d月%d日\n", meeting.date.year, meeting.date.month, meeting.date.day);

    return 0;
}イベント: プロジェクト進捗会議
開催日: 2026年5月15日この例では、meeting.date.year のように、親変数名、子メンバ名、その先のメンバ名という順序でアクセスしています。
演算子の優先順位は左から右へ流れるため、直感的に理解しやすい記述となります。
ポインタを利用したアクセス
構造体を関数に渡す際や、動的にメモリを確保した場合には、ポインタを介してアクセスすることになります。
この時、親構造体がポインタであればアロー演算子を使用し、その先のメンバが実体であればドット演算子を使用するという使い分けが必要です。
#include <stdio.h>

struct Point {
    int x;
    int y;
};

struct Circle {
    struct Point center;
    double radius;
};

void print_circle(struct Circle *c) {
    // 親がポインタなのでアロー演算子を使用
    // centerは構造体の実体なのでドット演算子を使用
    printf("中心座標: (%d, %d)\n", c->center.x, c->center.y);
    printf("半径: %.2f\n", c->radius);
}

int main() {
    struct Circle my_circle = {{10, 20}, 5.5};
    print_circle(&my_circle);
    return 0;
}中心座標: (10, 20)
半径: 5.50ここでの注意点は、演算子の使い分けです。 c->center.x という記述において、c はポインタであるため -> を使いますが、center は Circle 構造体の中に「実体」として埋め込まれているため、その内部へのアクセスにはドット演算子を使います。
もし center 自体もポインタとして保持されている場合は、c->center->x という記述になります。
初期化のルールとパターン
ネストされた構造体の初期化は、記述が複雑になりやすいため、いくつかのパターンを整理して理解しておく必要があります。
波括弧を用いた階層的初期化
最も基本的な初期化方法は、波括弧 {} を二重、三重に重ねて記述する方法です。
struct Person {
    char name[30];
    struct {
        int year;
        int month;
        int day;
    } birthday;
};

struct Person p = {"山田太郎", {1995, 10, 25}};
このように、内側の構造体に対応する部分をさらに波括弧で囲むことで、構造の境界を明確にします。
コンパイラによっては波括弧を省略して {"山田太郎", 1995, 10, 25} と書くことも許容されますが、可読性と安全性の観点から、階層ごとに波括弧を付けるべきです。
指示付き初期化子 (Designated Initializers)
C99規格以降では、指示付き初期化子を利用することができます。
これにより、特定のメンバだけを指定して初期化したり、定義順に関わらず初期化したりすることが可能になります。
struct Config {
    int id;
    struct {
        int timeout;
        int retry_limit;
    } network;
};

// 特定のメンバを明示的に指定して初期化
struct Config my_conf = {
    .id = 101,
    .network = {
        .timeout = 5000,
        .retry_limit = 3
    }
};
指示付き初期化子を使用すると、どの値がどのメンバに対応しているのかが一目で分かります。
特に、ネストが深い構造体やメンバ数が多い構造体では、書き間違いを防ぐ非常に強力な手段となります。
メモリ管理とアライメントの注意点
構造体の中に構造体を入れる場合、メモリ上の配置についても正しく理解しておく必要があります。
単に各メンバのサイズを合計したものが、全体のサイズになるとは限らないからです。
メモリアライメントとパディング
C言語の処理系は、CPUが効率的にメモリへアクセスできるように、データの区切りを一定のバイト数 (4バイトや8バイトなど) に合わせる性質があります。
これをアライメントと呼び、そのために挿入される隙間をパディングと呼びます。
| メンバ | 型 | サイズ |
|---|---|---|
| char flag | char | 1バイト |
| struct Data { int val; } | int | 4バイト |
上記の構成の場合、flag の直後に3バイトのパディングが入る可能性が高いです。
ネストされた構造体がある場合、その「内側の構造体」の中で最大のアライメント要求を持つメンバに合わせて、全体の配置が決定されます。
#include <stdio.h>

struct Inner {
    char a;
    int b; // ここでパディングが発生する可能性が高い
};

struct Outer {
    char c;
    struct Inner inner;
};

int main() {
    printf("Innerのサイズ: %zu\n", sizeof(struct Inner));
    printf("Outerのサイズ: %zu\n", sizeof(struct Outer));
    return 0;
}このプログラムを64bit環境で実行すると、sizeof(struct Inner) が 8バイト、sizeof(struct Outer) が 12バイト、あるいはアライメント調整によりさらに大きな値になることがあります。
ネスト構造を多用する場合、安易に sizeof の合計値を信じるのではなく、必ず sizeof 演算子を使って実際のサイズを確認する習慣をつけましょう。
ポインタによるネストと動的確保
構造体のメンバを実体ではなく「ポインタ」にする手法も頻繁に使われます。
これは、構造体のサイズを小さく保ちたい場合や、データが存在しない可能性がある (NULLを許容したい) 場合に有効です。
struct Node {
    int data;
    struct Node *next; // 自己参照構造体
};
このようにポインタを用いたネスト (参照) の場合、親構造体のサイズには「ポインタ変数のサイズ (通常4〜8バイト)」だけが加算されます。
ただし、この場合はメンバへのアクセス前に、ポインタが適切に初期化されているか、あるいは malloc 等でメモリが確保されているかを確認しなければなりません。
実践的な設計例:多階層構造の活用
ここでは、現実のアプリケーション開発に近い例として、図形オブジェクトを管理するデータ構造を考えてみましょう。
#include <stdio.h>

typedef struct {
    float x;
    float y;
} Vector2;

typedef struct {
    Vector2 position;
    Vector2 velocity;
} PhysicsProp;

typedef struct {
    int id;
    PhysicsProp physics;
    float mass;
} Entity;

void update_position(Entity *e, float dt) {
    // 3階層のアクセス
    e->physics.position.x += e->physics.velocity.x * dt;
    e->physics.position.y += e->physics.velocity.y * dt;
}

int main() {
    Entity player = {
        .id = 1,
        .physics = {
            .position = {0.0f, 0.0f},
            .velocity = {10.5f, 5.0f}
        },
        .mass = 1.0f
    };

    update_position(&player, 1.0f);

    printf("Player ID: %d\n", player.id);
    printf("新座標: (%.1f, %.1f)\n", player.physics.position.x, player.physics.position.y);

    return 0;
}Player ID: 1
新座標: (10.5, 5.0)この設計では、Vector2 という汎用的な構造体を定義し、それを PhysicsProp で再利用し、さらにそれを Entity の一部として組み込んでいます。
このように階層化することで、「物理演算に関する処理は PhysicsProp を参照する」といった具合に、コードの役割分担が明確になります。
構造体設計におけるベストプラクティス
構造体のネストは便利ですが、無計画に使用するとコードの複雑度を上げ、デバッグを困難にします。
以下のガイドラインを意識して設計を行うことが推奨されます。
1. ネストの深さを抑制する
一般的に、ネストの深さは2階層から3階層程度に留めるべきです。
4階層、5階層と深くなると、a.b.c.d.e のような記述が頻発し、タイピングミスや可読性の低下を招きます。
あまりに深くなる場合は、データ構造そのものを見直すか、中間的なポインタ変数を用意してアクセスを簡略化しましょう。
2. typedef の適切な利用
構造体を利用するたびに struct キーワードを書くのは冗長です。
typedef を用いて型名を定義することで、コードがスッキリし、他の言語に近い感覚で記述できるようになります。
typedef struct {
    int x;
    int y;
} Point;

// struct を省略できる
Point p = {10, 20};
3. 関数を通じたアクセス
ネストされた深いメンバを直接操作するのではなく、特定の構造体を操作するための専用関数を用意することを検討してください。
いわゆるカプセル化に近い考え方です。
// 直接操作するのではなく...
// player.physics.position.x = 10;

// 関数を介して操作する
set_entity_position(&player, 10, 20);
これにより、構造体の内部設計が変更(例えば position の型が float から double に変更)されたとしても、修正範囲を関数内部だけに限定できる可能性が高まります。
まとめ
C言語における構造体のネストは、複雑なデータを論理的なグループに分割し、プログラムの構造を整理するための極めて重要なテクニックです。
外部定義による再利用性の向上、ドット演算子やアロー演算子を用いた精緻なアクセス、そして指示付き初期化子による安全な初期化など、本記事で解説した手法をマスターすることで、堅牢なコードを記述できるようになります。
一方で、メモリアライメントによるパディングの問題や、ネストが深くなることによる可読性の低下など、注意すべき側面も存在します。
常に sizeof でデータサイズを把握し、適切な抽象化レベルを保ちながら設計を進めることが、プロフェッショナルなCプログラマへの第一歩です。
これらのルールを日々のコーディングに適用し、より効率的でメンテナンスしやすいプログラムの開発を目指してください。