
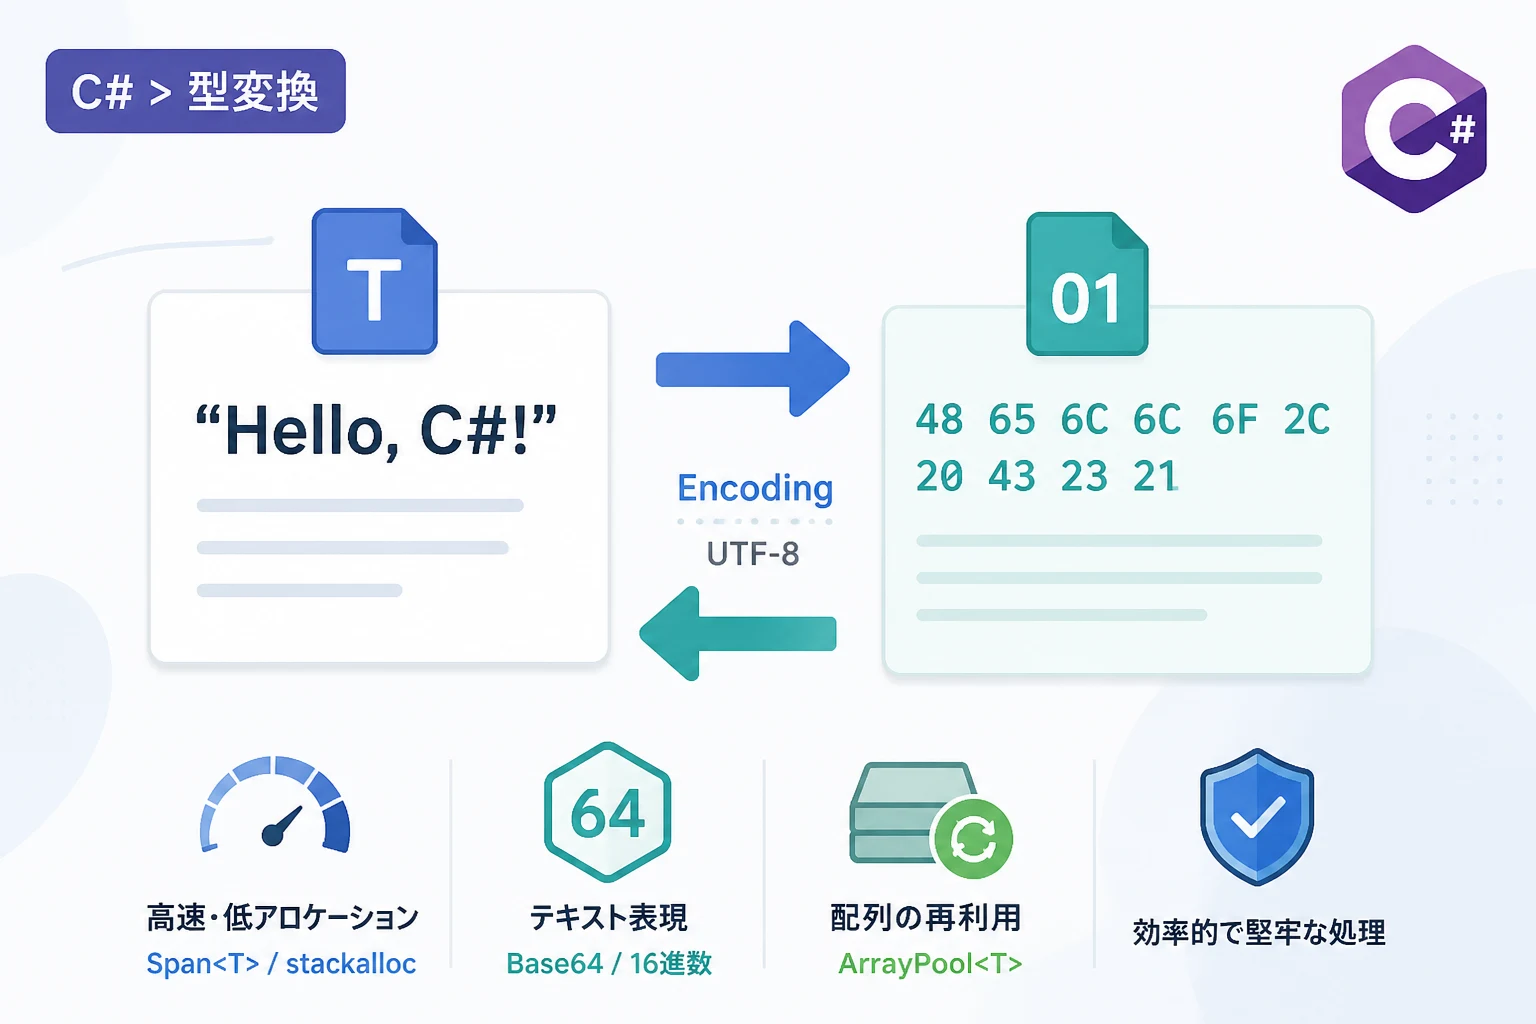
C#におけるプログラミングにおいて、文字列(string)とバイト配列(byte[])の相互変換は、避けては通れない非常に重要な処理です。
ネットワーク通信、ファイル入出力、暗号化、シリアル化など、データのやり取りを行うあらゆる場面でこの変換が必要となります。
かつては単純なEncodingクラスの利用が一般的でしたが、近年の.NETではパフォーマンスを極限まで追求するためのSpan<T>やMemory<T>を活用した手法が主流となっています。
本記事では、初心者の方でも理解できる基本的な変換方法から、大規模システムや高頻度な処理で求められる最新の低アロケーション・高パフォーマンスな変換手法までを網羅して解説します。
文字列とバイト配列の基本概念
C#において、string型は内部的にUTF-16エンコーディングを採用しており、1文字を2バイト(サロゲートペアの場合は4バイト)で表現します。
一方、バイナリデータであるbyte[]は、単なる数値の羅列であり、それがどのような文字を表すかはエンコーディング設定に依存します。
この「エンコーディング(符号化)」のルールが一致していないと、変換時に文字化けが発生してしまいます。
そのため、変換処理を記述する際には、常に「どの文字コードを使用しているか」を意識することが極めて重要です。
System.Text.Encodingを用いた標準的な変換
最も一般的かつ伝統的な方法は、System.Text.Encodingクラスを使用する方法です。
このクラスには、UTF-8、ASCII、Unicode(UTF-16)など、主要なエンコーディングに対応するプロパティが用意されています。
文字列からバイト配列への変換(GetBytes)
文字列をバイト配列に変換するには、Encoding.GetBytesメソッドを使用します。
現代のアプリケーション開発では、Web標準であるUTF-8を使用するのが一般的です。
using System;
using System.Text;

public class Program
{
    public static void Main()
    {
        string text = "こんにちは、C#。";

        // UTF-8エンコーディングを使用してバイト配列に変換
        byte[] byteArray = Encoding.UTF8.GetBytes(text);

        Console.WriteLine($"バイト配列の長さ: {byteArray.Length}");
        // バイトの内容を16進数で表示
        Console.WriteLine($"内容: {BitConverter.ToString(byteArray)}");
    }
}バイト配列の長さ: 21
内容: E3-81-93-E3-82-93-E3-81-AB-E3-81-A1-E3-81-AF-E3-80-81-43-23-E3-80-82バイト配列から文字列への変換(GetString)
受け取ったバイナリデータを文字列に戻すには、Encoding.GetStringメソッドを使用します。
変換時に使用するエンコーディングは、作成時と同じものでなければなりません。
using System;
using System.Text;

public class Program
{
    public static void Main()
    {
        byte[] byteArray = { 0xE3, 0x81, 0x93, 0xE3, 0x82, 0x93, 0xE3, 0x81, 0xAB, 0xE3, 0x81, 0xA1, 0xE3, 0x81, 0xAF };

        // UTF-8として文字列に復元
        string result = Encoding.UTF8.GetString(byteArray);

        Console.WriteLine($"復元された文字列: {result}");
    }
}復元された文字列: こんにちはパフォーマンスを意識したSpanの活用
.NET Core以降、および.NET 5/6/7/8/9といった最新バージョンでは、Span<T>やReadOnlySpan<T>を活用することで、メモリ割り当て(アロケーション)を最小限に抑える手法が推奨されています。
従来のGetBytesメソッドは、呼び出すたびに新しいbyte[]オブジェクトをヒープメモリ上に生成します。
これに対し、Span<T>を使用すると、既存のバッファやスタックメモリを利用して変換を行うことが可能です。
Spanを用いた効率的な変換例
例えば、非常に短い文字列を頻繁に変換する場合、stackallocを使用してスタック領域にメモリを確保することで、ガベージコレクション(GC)の負荷をゼロにできます。
using System;
using System.Text;

public class SpanExample
{
    public void ProcessText(string text)
    {
        // 必要なバイト数を計算
        int byteCount = Encoding.UTF8.GetByteCount(text);

        // スタック上にメモリを確保(小さいデータの場合に有効)
        Span<byte> buffer = stackalloc byte[byteCount];

        // Spanに対して直接書き込む
        int written = Encoding.UTF8.GetBytes(text, buffer);

        Console.WriteLine($"書き込まれたバイト数: {written}");
    }
}この手法の利点は、「新しい配列を作成しない」点にあります。
高スループットが求められるサーバーアプリケーションでは、こうした小さな最適化の積み重ねが全体のパフォーマンスを大きく左右します。
Base64エンコーディングによる変換
バイナリデータをテキスト形式(JSONやXMLなど)で扱いたい場合、Base64エンコーディングがよく利用されます。
これはバイト配列を、A-Z, a-z, 0-9, +, / の64種類の文字で表現する手法です。
ConvertクラスによるBase64変換
using System;

public class Base64Example
{
    public static void Main()
    {
        byte[] data = { 0x01, 0x02, 0x03, 0x04, 0x05 };

        // バイト配列をBase64文字列に変換
        string base64String = Convert.ToBase64String(data);
        Console.WriteLine($"Base64: {base64String}");

        // Base64文字列をバイト配列に戻す
        byte[] backData = Convert.FromBase64String(base64String);
        Console.WriteLine($"元のデータの長さ: {backData.Length}");
    }
}Base64: AQIDBAU=
元のデータの長さ: 5Base64における最新の最適化手法
最新の.NETでは、System.Buffers.Text.Base64クラスを使用することで、UTF-8形式のバイト配列から直接Base64へ変換するなどの、より高度な操作が可能です。
これにより、文字列を経由せずにバイナリ間での加工ができるため、中間オブジェクトの生成を抑えられます。
16進数(Hex)文字列との変換
デバッグや暗号化ハッシュの表示などで、バイト配列を16進数の文字列として表現したい場合があります。
以前はBitConverterやStringBuilderを組み合わせて実装していましたが、現在はより便利なメソッドが追加されています。
Convert.ToHexStringの利用
.NET 5以降、Convert.ToHexStringおよびConvert.FromHexStringが導入され、高速かつ簡潔に変換できるようになりました。
using System;

public class HexExample
{
    public static void Main()
    {
        byte[] data = { 255, 128, 64, 0 };

        // 16進数文字列へ変換
        string hex = Convert.ToHexString(data);
        Console.WriteLine($"HEX: {hex}");

        // 16進数文字列からバイト配列へ復元
        byte[] decoded = Convert.FromHexString(hex);
        Console.WriteLine($"Decoded: {string.Join(", ", decoded)}");
    }
}HEX: FF804000
Decoded: 255, 128, 64, 0このメソッドは非常に高速で、大文字の16進数表記を標準で出力します。
小文字が必要な場合は、string.Createや各要素へのフォーマット指定が必要ですが、特別な理由がない限りはこの標準メソッドを使うのがベストプラクティスです。
メモリ効率を最大化する「ArrayPool」の活用
数MB単位の大きなバイト配列を頻繁に変換・破棄する場合、GCの「LOH(Large Object Heap)」への負荷が問題となります。
これを回避するために、ArrayPool
| 特徴 | new byte[] | ArrayPool |
|---|---|---|
| メモリ確保 | ヒープに新規割り当て | プールから既存の配列を借用 |
| GC負荷 | 高い(頻繁な解放が必要) | 低い(再利用されるため) |
| 管理 | 自動 | 手動(Returnが必要) |
ArrayPoolを用いた変換の実装例
using System;
using System.Buffers;
using System.Text;

public class PoolExample
{
    public void EfficientConversion(string largeText)
    {
        var pool = ArrayPool<byte>.Shared;
        int maxByteCount = Encoding.UTF8.GetMaxByteCount(largeText.Length);

        // プールから配列を借りる
        byte[] buffer = pool.Rent(maxByteCount);
        try
        {
            int actualBytes = Encoding.UTF8.GetBytes(largeText, 0, largeText.Length, buffer, 0);
            // bufferを利用した処理...
            Console.WriteLine($"変換完了: {actualBytes}バイト");
        }
        finally
        {
            // 必ずプールに返す
            pool.Return(buffer);
        }
    }
}注意点として、pool.Rentで返される配列の長さは、要求したサイズ以上であることが保証されますが、必ずしもぴったりのサイズではありません。
そのため、処理には必ずactualBytesのような実際に書き込まれたサイズを示す変数を使用してください。
変換時におけるエラーハンドリング
文字列からバイト配列への変換、あるいはその逆において、不正なデータが含まれている場合にどのように振る舞うかを制御することも重要です。
デフォルトでは、Encodingクラスは不正な文字を「?」などの置換文字に置き換えます。
しかし、セキュリティが重視される場面やデータの整合性が必須な場面では、例外をスローさせる設定に変更することが推奨されます。
// 不正なシーケンスで例外を投げるエンコーディング設定
Encoding strictUtf8 = Encoding.GetEncoding(
    "utf-8",
    new EncoderExceptionFallback(),
    new DecoderExceptionFallback()
);

try
{
    // 不正なバイトデータからの変換を試みる
    byte[] invalidData = { 0xFF, 0xFF };
    string result = strictUtf8.GetString(invalidData);
}
catch (DecoderFallbackException ex)
{
    Console.WriteLine("デコードエラー: 不正なバイト列が検出されました。");
}このように、EncoderFallbackやDecoderExceptionFallbackを明示的に指定することで、堅牢なアプリケーションを構築できます。
文字列作成の最適化:string.Create
C# 10以降では、string.Createメソッドを使用することで、バイト配列から文字列を作成する際のアロケーションをさらに最適化できる場合があります。
これは、文字列のメモリ領域を先に確保し、その領域に対して直接書き込みを行う手法です。
高度なライブラリ開発などでは多用されますが、一般的な業務アプリケーションではEncoding.GetString(ReadOnlySpan<byte>)を使用するのが、可読性とパフォーマンスのバランスが最も取れた選択肢となります。
まとめ
C#におけるバイト配列と文字列の相互変換は、単なるデータの型変換以上の意味を持ちます。
適切なエンコーディングの選択、そしてパフォーマンス要件に応じた最適なAPIの選択が、プロフェッショナルなコードを書くための第一歩です。
- 標準的な処理では、
Encoding.UTF8.GetBytesおよびGetStringを使用する。 - パフォーマンスが重要な場合は、
Span<byte>やstackallocを活用してアロケーションを抑える。 - バイナリのテキスト表現には、
Convert.ToBase64StringやConvert.ToHexStringを活用する。 - 巨大なデータを扱う際は、
ArrayPool<byte>による配列の再利用を検討する。
これらの手法を適切に使い分けることで、効率的でメモリに優しい、そして堅牢なC#プログラムを実現することができます。
最新の.NETが提供する強力なAPIを駆使し、データ変換のボトルネックを解消していきましょう。