
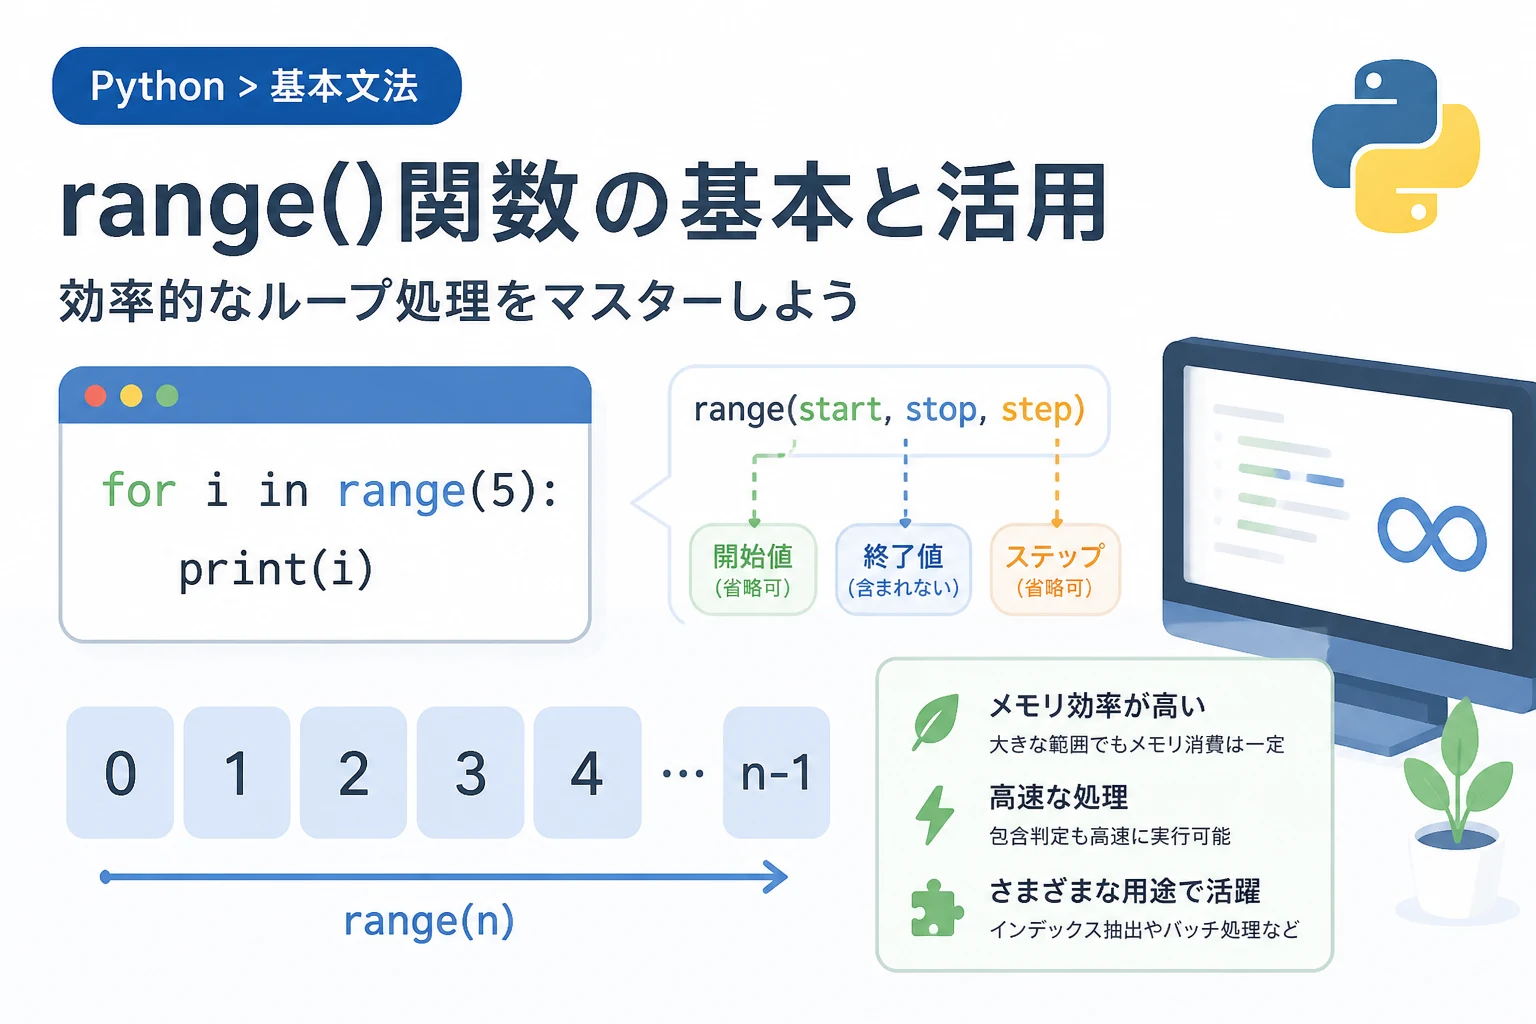
Pythonでプログラミングを学ぶ際、最も頻繁に利用する組み込み関数のひとつがrange関数です。
反復処理(ループ)を行う際の回数指定や、特定の規則に基づいた数値のシーケンスを生成するために欠かせない存在です。
一見すると単純な関数に思えますが、引数の渡し方や負のステップ指定、メモリ効率の仕組みなど、深く知ることでよりスマートなコードを書くことが可能になります。
本記事では、Pythonのrange()について、初心者の方から実務で応用したい方まで役立つ知識を体系的に解説します。
1. range関数の基本的な役割と特徴
Pythonにおけるrange()は、連続する整数のシーケンスを生成するためのオブジェクトを返す関数です。
主にforループと組み合わせて、特定の回数だけ処理を繰り返したい場合に使用されます。
rangeオブジェクトの性質
range()が返すのは、リスト(list)ではなくrangeオブジェクトと呼ばれる特殊なイテラブルなオブジェクトです。
これは「イミュータブル(変更不能)なシーケンス型」に分類されます。
最大の特徴は、メモリ効率が極めて高い点にあります。
例えば、100万個の要素を持つリストを作成すると大量のメモリを消費しますが、range(1000000)は内部的に「開始値・終了値・ステップ数」の情報のみを保持するため、数値の大きに関わらず消費メモリは一定です。
基本的な記述パターン
range()には、1つから3つの引数を渡すことができます。
# 0から始まる5つの数値を生成
for i in range(5):
print(i)0
1
2
3
4上記の例では、range(5)と記述することで、0から4までの計5個の数値が順に出力されます。
ここで重要なのは、指定した引数の値(この場合は5)自体は含まれないという点です。
これはPythonのスライス表記などとも共通する「終了値は含まない」という仕様に基づいています。
2. 引数の指定方法による挙動の変化
range()の構文は、引数の数によって3つのパターンに分けられます。
それぞれの挙動を正しく理解することで、複雑な数値シーケンスを自在に操れるようになります。
引数が1つの場合:range(stop)
引数を1つだけ指定すると、それは「終了値」として扱われます。
開始値はデフォルトで0となり、ステップ(増分)は1となります。
# 0から9までの10個の数値を生成
r = range(10)
print(list(r)) # リスト形式に変換して確認[0, 1, 2, 3, 4, 5, 6, 7, 8, 9]引数が2つの場合:range(start, stop)
引数を2つ指定すると、1つ目が「開始値」、2つ目が「終了値」になります。
# 5から始まり、12の直前(11)までを生成
for i in range(5, 12):
print(i, end=" ")5 6 7 8 9 10 11この記法は、特定の範囲(例えばIDの範囲指定や、オフセットを持たせたループ)を処理する際に非常に便利です。
引数が3つの場合:range(start, stop, step)
3つ目の引数は「ステップ(増分)」を指定します。
これにより、数値を1つ飛ばしにしたり、特定の倍数のみを抽出したりすることができます。
# 1から10までの奇数のみを生成
# 1から始まり2ずつ増える、10未満の数値
odds = list(range(1, 10, 2))
print(odds)[1, 3, 5, 7, 9]ステップ数には正の整数だけでなく、負の整数を指定することも可能です。
これにより、数値を減らしていく逆順のシーケンスを作成できます。
3. 負のステップを利用した逆順(カウントダウン)処理
プログラミングでは、大きな値から小さな値に向かってループを回したい場面が多々あります。
range()でこれを実現するには、開始値を終了値よりも大きく設定し、ステップに負の値を指定します。
カウントダウンの例
# 10から1までカウントダウン
for i in range(10, 0, -1):
print(i, end=" ")10 9 8 7 6 5 4 3 2 1ここでの注意点は、やはり「終了値(stop)」は含まれないというルールです。
1まで出力したい場合は、終了値に0を指定する必要があります。
もしここを1にしてしまうと、ループは2で止まってしまいます。
ステップ指定の注意点
ステップに0を指定することはできません。
もし指定した場合はValueErrorが発生します。
# ステップに0を指定するとエラーになる
try:
    range(0, 10, 0)
except ValueError as e:
print(f"エラー発生: {e}")エラー発生: range() arg 3 must not be zero4. リストの要素とインデックスを同時に扱う
Pythonでは、リスト(配列)の要素をループで処理する場合、直接要素を取り出す「イテラブルな操作」が推奨されます。
しかし、処理の内容によっては「現在の要素が何番目か(インデックス)」という情報が必要になることがあります。
伝統的なインデックスによるアクセス
他のプログラミング言語に慣れている方は、以下のような書き方をすることがあります。
fruits = ["apple", "banana", "cherry"]

# リストの長さ(len)をrangeに渡す
for i in range(len(fruits)):
print(f"Index {i}: {fruits[i]}")Index 0: apple
Index 1: banana
Index 2: cherryenumerate関数との使い分け
上記の書き方は間違いではありませんが、Pythonではenumerate()関数を使う方がより簡潔で「Pythonic(Pythonらしい)」とされます。
fruits = ["apple", "banana", "cherry"]

# enumerateを使うとインデックスと要素を同時に取得できる
for i, fruit in enumerate(fruits):
print(f"Index {i}: {fruit}")ただし、「特定のインデックスから開始したい」場合や「1つ飛ばしで要素を処理したい」場合は、range()を活用したほうが柔軟に対応できることもあります。
状況に応じて使い分けられるようにしておきましょう。
5. rangeオブジェクトの高度な操作
range()は単なるループのための道具ではなく、シーケンス型としての機能を備えています。
インデックスアクセスとスライス
rangeオブジェクトに対して、リストのようにインデックスで特定の要素を取得したり、スライスを適用して新しいrangeオブジェクトを作成したりできます。
r = range(0, 100, 10)

# 3番目の要素を取得(0, 10, 20...なので20)
print(f"3番目の要素: {r[2]}")

# スライスを適用して、新しいrangeを作成
sub_r = r[1:4]
print(f"スライス後のリスト表示: {list(sub_r)}")3番目の要素: 20
スライス後のリスト表示: [10, 20, 30]包含判定(in 演算子)の高速性
特定の数値が範囲内に含まれているかどうかを調べる際、in演算子を使用します。
r = range(0, 1000000, 2)

# 500は範囲に含まれるか?
print(500 in r)

# 501は範囲に含まれるか?
print(501 in r)True
Falseここで注目すべきは、rangeに対するin演算の速度です。
リストの場合、要素を先頭から順に探すため要素数が増えるほど時間がかかりますが、rangeの場合は計算によって判定を行うため、どんなに大きな範囲でも一瞬で完了します。
6. 小数点(浮動小数点数)を扱う場合
標準のrange()関数は、整数(int)のみを引数として受け取ります。そのため、0.1刻みでループを回したいといった場合には直接利用することができません。
while文による代用
浮動小数点数を使いたい場合の最もシンプルな方法は、while文と変数の更新を組み合わせることです。
x = 0.0
while x < 1.0:
    print(f"{x:.1f}", end=" ")
x += 0.20.0 0.2 0.4 0.6 0.8ただし、浮動小数点数の計算には誤差が伴うため、終了判定には注意が必要です。
NumPyライブラリの活用
データ分析や科学計算を行う場合、外部ライブラリのNumPyが提供するnp.arange()やnp.linspace()を使用するのが一般的です。
import numpy as np

# 0.0から1.0の手前まで0.2刻み
for i in np.arange(0.0, 1.0, 0.2):
print(f"{i:.1f}", end=" ")0.0 0.2 0.4 0.6 0.8このように、用途に合わせて適切なツールを選択することが重要です。
7. 実践的な応用例:バッチ処理の実装
実務において、大量のデータリストを一定のサイズ(バッチ)ごとに分割して処理したいことがあります。
ここでrange()のステップ指定が非常に役立ちます。
def process_batches(data, batch_size):
    # dataの長さまで、batch_sizeごとにループ
    for i in range(0, len(data), batch_size):
        batch = data[i : i + batch_size]
        print(f"Processing batch starting at index {i}: {batch}")

# テストデータ
large_dataset = list(range(100, 115))
process_batches(large_dataset, 5)Processing batch starting at index 0: [100, 101, 102, 103, 104]
Processing batch starting at index 5: [105, 106, 107, 108, 109]
Processing batch starting at index 10: [110, 111, 112, 113, 114]このパターンは、APIのリクエスト制限に対応するための分割送信や、ディープラーニングにおけるミニバッチ学習のデータ作成など、幅広い分野で応用されています。
8. range関数を使用する際のベストプラクティス
より良いコードを書くために、以下のポイントを意識しておきましょう。
1. リスト化が必要な場合のみ list() を使う
デバッグや内容の確認のためにlist(range(5))のように変換するのは有効ですが、通常のループ処理ではrange()をそのまま使用してください。
メモリの無駄を省き、実行速度を最適化できます。
2. 無理に range(len(obj)) を使わない
前述の通り、要素自体が必要な場合はfor item in obj:と書き、インデックスも必要な場合はenumerate()を使いましょう。
コードの可読性が格段に向上します。
3. 明示的な引数指定
特にステップ数に負の値を指定する場合、開始値と終了値が逆になっていないか、期待通りの回数ループするかを慎重に確認してください。
1つズレる(オフバイワン・エラー)が発生しやすい箇所です。
9. 内部構造とメモリ効率の詳細
なぜrange()は巨大な数値を扱ってもメモリを消費しないのでしょうか。
その理由は、Pythonのrange型が「計算による値の生成」を行っているからです。
リストの場合、あらかじめすべての要素がメモリ上に展開されます。
一方でrangeは、以下の計算式に基づいて、必要な時に必要な値をその場で算出します。
| プロパティ | 計算式(イメージ) |
|---|---|
| i番目の要素 | start + (step \* i) |
| 要素数 (length) | max(0, ceil((stop - start) / step)) |
このように、「値そのもの」ではなく「値を作るためのルール」を保存しているため、データ量に依存しない軽量な動作が保証されているのです。
10. よくある質問とトラブルシューティング
Q: range(10, 1) で何も出力されないのはなぜですか?
A: デフォルトのステップ数が1だからです。
10から1に向かうには数値が「減少」しなければなりませんが、ステップが正の場合、開始から終了に到達できないと判断され、空のシーケンスとなります。
減少させたい場合はrange(10, 1, -1)としてください。
Q: rangeオブジェクトの中身を直接 print() しても数字が見えません。
A: print(range(5))を実行するとrange(0, 5)と表示されます。
これは、rangeが遅延評価を行うオブジェクトであるためです。
中身を数値として確認したい場合は、list(range(5))のようにリスト型にキャストするか、ループで回して確認する必要があります。
Q: 大きな range をスライスしてもメモリは大丈夫ですか?
A: はい、大丈夫です。
rangeをスライスした結果もまたrangeオブジェクトになります。
そのため、どれだけ大きな範囲を切り出しても、メモリを大量に消費することはありません。
まとめ
Pythonのrange()関数は、単純な繰り返し処理から複雑な数値シーケンスの生成、さらには効率的なバッチ処理の実装まで、Pythonプログラミングの屋台骨を支える非常に強力なツールです。
本記事で解説した以下のポイントを心に留めておきましょう。
- 引数の指定順序(start, stop, step)と、「終了値は含まれない」というルール。
- 負のステップを活用した逆順ループ。
- メモリ効率の高さを活かし、大きな数値範囲でも躊躇なく使用できること。
- シーケンス型としての特徴(インデックスアクセスや包含判定)の活用。
これらの特性を正しく理解し活用することで、あなたの書くPythonコードはより効率的で、読みやすく、洗練されたものになるはずです。
日々のコーディングの中で、最適なrange()の使い方を常に意識してみてください。