
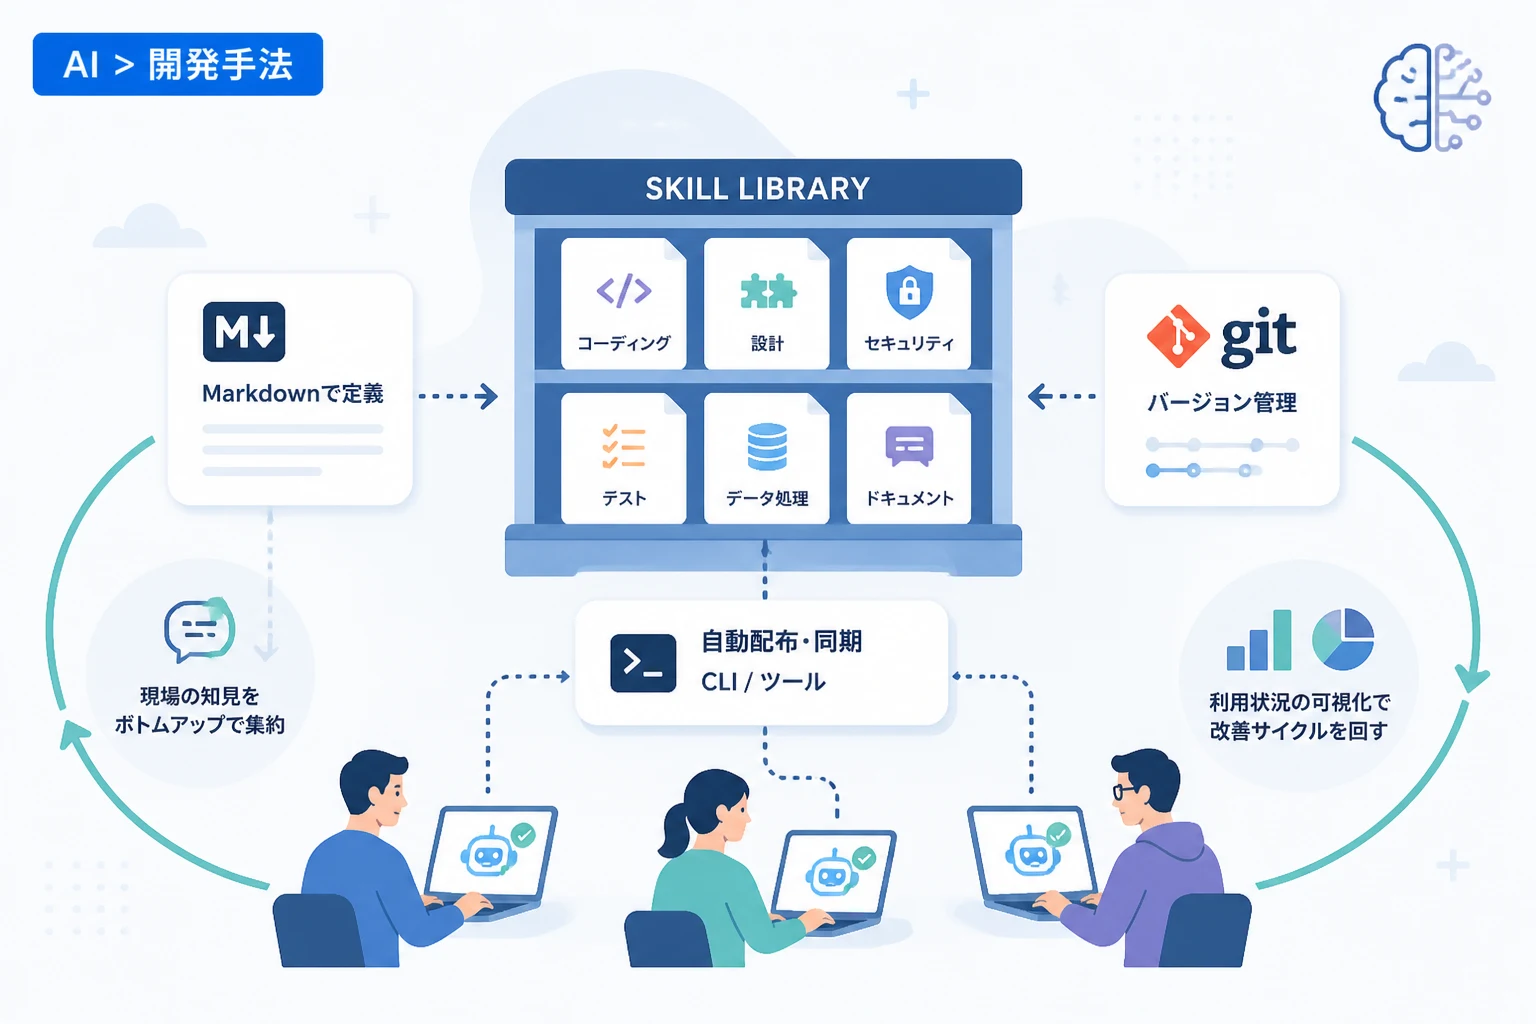
2026年、エンジニアリングチームにおける最大の課題は、AIモデルの選択ではなく、それらAIエージェントをいかに組織の標準に適合させるかという点に移行しています。
多くの開発者が最新のAIモデルを利用しているものの、それぞれのAIエージェントが参照する「スキル (プロンプトや設定ファイル)」は個人の裁量に委ねられており、品質のバラツキが顕著になっています。
このような「スキルの属人化」は、セキュリティリスクやコード品質の低下を招くだけでなく、チーム全体の生産性を阻害する大きな要因となり得ます。
本記事では、AIエージェントの動作を組織全体で最適化し、ガバナンスを効かせながら進化させるための「スキルライブラリ」の構築手法について詳しく解説します。
なぜ今「スキルライブラリ」が必要なのか
現在、多くのチームで「エージェント・スプロール (エージェントの無秩序な拡散)」と呼ばれる現象が発生しています。
個々のエンジニアが独自の判断でAIの設定をカスタマイズすることで、組織のコーディング規約やセキュリティポリシーが無視される「シャドウスキル」が蔓延しています。
スキルライブラリを導入することで、すべてのAIエージェントに対して共通の知識ベースと動作指針を提供することが可能になります。
これにより、ジュニアエンジニアからシニアエンジニアまで、一貫した最高品質のアウトプットをAIから得られるようになります。
ステップ1:Markdown形式によるスキルの定義と一元管理
スキルライブラリの核となるのは、AIエージェントへの指示書となるMarkdownファイルです。
これらのファイルには、セキュリティコンベンション、インシデントプロトコル、あるいは特定の技術スタックにおけるコーディング標準を記述します。
重要なのは、これらのスキルファイルをローカル環境に放置せず、Gitなどのバージョン管理システムで管理することです。
Gitで管理することにより、誰がいつどのような指示をAIに追加したのかが明確になり、チーム内でのレビューも可能になります。
以下は、インシデント発生時の初期対応をAIに指示するためのスキル定義の例です。
# インシデント・トリアージ・スキル
## 役割
あなたはSREチームの副操縦士として、発生したインシデントの初期分析をサポートします。

## 実行手順
1. 影響を受けているサービスとリージョンを特定してください。
2. 直近30分以内のデプロイ履歴を確認し、相関関係を調査してください。
3. 根本原因を「ネットワーク」「アプリケーション」「インフラ」のいずれかに分類してください。
4. ステークホルダーへの報告用サマリーを、標準テンプレートに従って作成してください。

## 注意事項
- 顧客の個人情報は絶対にプロンプトに含めないでください。
- 未確認の情報を「事実」として報告しないでください。
ステップ2:スキルの構造化と役割による分類
ライブラリに数百のファイルが並んでいるだけでは、開発者はどのスキルを使えばよいか迷ってしまいます。
そのため、スキルを「エンジニアリング標準」「フロントエンド」「インフラ」などのユースケース別にグループ化する必要があります。
さらに、スキルには「必須 (Required)」と「オプション (Optional)」の2つの属性を持たせることが効果的です。
| スキルの種類 | 具体的な内容 | 適用範囲 |
|---|---|---|
| 必須スキル | セキュリティ、共通規約、ガバナンスルール | 全エンジニアに自動配布 |
| オプションスキル | Django、React、ML、インフラ構築 | 担当プロジェクトに応じて選択 |
必須スキルには、プロンプトインジェクションの監視や、機密データの外部送信ブロックといった組織の防衛線を含めるべきです。
一方で、オプションスキルは「特定の拡張子 (例:*.tsx) が開かれたときのみ有効化する」といったトリガーを設定することで、エージェントのコンテキスト過負荷を防ぎます。
ステップ3:エンジニアへの自動配布とIDE連携
構築したスキルライブラリは、エンジニアが手動でコピーするのではなく、CLIツールなどを通じて自動的に配布される仕組みを構築します。
例えば、port skill init のようなコマンドを実行するだけで、権限に基づいた適切なスキルグループが自動的にローカルの .cursor/ などの設定フォルダに同期されます。
# スキルライブラリの初期化と同期
$ port skill init

# [INFO] 認証に成功しました。
# [INFO] 必須スキル(Security, General)を同期中...
# [PROMPT] 追加のスキルを選択してください:
# > 1. Frontend (React/TypeScript)
#   2. Backend (Go/PostgreSQL)
# 3. Infrastructure (Terraform/AWS)Successfully synced 12 skills to .cursor/rules/
Current Version: v2.4.0
Next Sync: Automatically on file changeこの仕組みの優れた点は、ライブラリ側でスキルが更新された際に、すべてのエンジニアのエージェントに即座に反映されることです。
これにより、古い慣習に基づいたコードがAIによって生成されるリスクを最小限に抑えることができます。
ステップ4:自己進化するフィードバックループの構築
スキルライブラリを静的なドキュメントにしてはいけません。
開発者がAIエージェントに対して同じ修正を二度以上繰り返した場合、それを検知して新しいスキルとして提案する「メタスキル」の実装が有効です。
AI側から「この指摘は二度目です。今後自動化するために新しいスキルを作成しますか?」と問いかける仕組みを構築します。
このフローにより、現場の知見がボトムアップでライブラリに集約され、プラットフォームチームが介在しなくてもライブラリが賢くなっていきます。
提案された新しいスキルは、Gitのプルリクエストとして送信され、適切なレビューを経て正式なライブラリへと統合されます。
ステップ5:運用状況の可視化とヘルスチェック
最後に、スキルライブラリが実際に活用されているかをダッシュボードで追跡します。
「誰がどのバージョンのスキルを使用しているか」「どのスキルが頻繁に呼び出されているか」を可視化することが重要です。
また、90日間一度も更新されていない、あるいは参照されていないスキルを「陳腐化したスキル」としてフラグを立て、定期的に整理します。
AIが生成したプルリクエストに対して、人間が行った修正コメントの内容を分析することも非常に有効です。
同じ指摘が何度も繰り返されている箇所があれば、それはスキルライブラリに不足があるか、既存のスキルが機能していない証拠となります。
まとめ
AIエージェントの能力を最大限に引き出し、組織としての開発効率を高めるためには、個々のエンジニアのスキルに依存しない共通基盤としての「スキルライブラリ」が不可欠です。
Markdownによる一元管理、自動同期の仕組み、そして自己進化するフィードバックループを組み合わせることで、AIとの共生は次のフェーズへと進化します。
まずはチーム内で頻出するルールを1つのファイルにまとめることから始めてみてください。
その小さな一歩が、将来的な「エージェント・スプロール」を防ぎ、強固な開発文化を築く礎となるはずです。