SQLを学ぶ上で、最初の一歩でありながら最も奥が深いのがSELECT文です。
データベースに蓄積された膨大なデータから、必要な情報だけを正確に抽出する技術は、エンジニアだけでなくデータアナリストにとっても必須のスキルと言えます。
本記事では、SELECT文の基本構文から、実務で役立つ応用的な記述方法、そして多くの初心者が躓きやすい「実行順序」の概念について詳しく説明します。
正しい書き方を習得することで、複雑なデータ操作も迷いなく行えるようになるでしょう。
SQL SELECT文の役割と基本構造
SELECT文は、リレーショナルデータベース(RDBMS)からデータを取得するためのクエリです。
データの追加、更新、削除といった操作の中でも、参照(抽出)を行うSELECT文は最も頻繁に使用されます。
まずは、最もシンプルな構文の形を確認しましょう。
-- 全ての列を取得する場合
SELECT * FROM テーブル名;

-- 特定の列を指定して取得する場合
SELECT 列名1, 列名2 FROM テーブル名;
SELECT句とFROM句の基本
SELECT句には、抽出したいカラム名(列名)を記述します。
カンマ , で区切ることで、複数の列を一度に指定することが可能です。
FROM句には、対象となるデータが格納されているテーブル名を指定します。
アスタリスク * を使用すると、そのテーブルに含まれるすべての列を取得できますが、実務では必要な列のみを指定することが推奨されます。
不必要なデータまで取得すると、ネットワーク帯域やメモリを無駄に消費し、パフォーマンスの低下を招く可能性があるためです。
実例で学ぶSELECT文の基本的な使い方
具体的なテーブル構造を例に、データの抽出方法を見ていきましょう。
ここでは、以下のような「employees(社員)」テーブルを想定します。
| emp_id | emp_name | department | salary |
|---|---|---|---|
| 1 | 田中 太郎 | 営業 | 300000 |
| 2 | 佐藤 花子 | 開発 | 350000 |
| 3 | 鈴木 一郎 | 営業 | 280000 |
特定の列のみを取得する
社員名と部署名だけを知りたい場合は、次のように記述します。
SELECT
    emp_name,
    department
FROM
employees;emp_name | department
---------|-----------
田中 太郎 | 営業
佐藤 花子 | 開発
鈴木 一郎 | 営業別名(エイリアス)を使用して列名を分かりやすくする
AS キーワードを使用すると、取得した結果の列名に任意の名前(別名)を付けることができます。
日本語の名称を付けたり、計算結果の列に名前を付けたりする際に非常に便利です。
SELECT
    emp_name AS 社員名,
    salary * 12 AS 年収
FROM
employees;社員名 | 年収
---------|---------
田中 太郎 | 3600000
佐藤 花子 | 4200000
鈴木 一郎 | 3360000重複を除去するDISTINCT
特定の列に含まれる値を、重複を排除してユニークなものだけ取得したい場合には DISTINCT を使用します。
例えば、どのような部署が存在するかを確認したい場合に有効です。
SELECT DISTINCT
    department
FROM
employees;department
----------
営業
開発WHERE句によるデータの絞り込み
すべてのデータを取得するのではなく、特定の条件に合致するデータのみを抽出するために WHERE 句を使用します。
条件式を適切に記述することで、必要な情報をピンポイントで見つけ出すことができます。
比較演算子の活用
数値や文字列を比較するために、一般的な比較演算子が利用可能です。
=(等しい)<>または!=(等しくない)<(より小さい)>(より大きい)<=(以下)>=(以上)
-- 給与が30万円以上の社員を取得
SELECT
    emp_name,
    salary
FROM
    employees
WHERE
    salary >= 300000;
論理演算子(AND, OR, NOT)による複数条件
複数の条件を組み合わせる場合は、AND や OR を使用します。
AND はすべての条件を満たす場合、OR はいずれかの条件を満たす場合に真となります。
-- 部署が「営業」かつ、給与が29万円以上の社員を取得
SELECT
    emp_name
FROM
    employees
WHERE
    department = '営業'
    AND salary >= 290000;
IN演算子とBETWEEN演算子
複数の候補のいずれかに一致するかを判定するには IN 演算子が便利です。
また、範囲を指定する場合には BETWEEN 演算子が役立ちます。
-- 営業または開発部署に所属する社員を取得
SELECT * FROM employees WHERE department IN ('営業', '開発');

-- 給与が25万から35万の間の社員を取得
SELECT * FROM employees WHERE salary BETWEEN 250000 AND 350000;
LIKE演算子によるパターンマッチング
文字列の部分一致検索を行いたい場合は、LIKE 演算子を使用します。
ワイルドカードとして % (0文字以上の任意の文字列)や _ (任意の1文字)を使用します。
-- 苗字が「田中」で始まる社員を取得
SELECT * FROM employees WHERE emp_name LIKE '田中%';
結果の並び替えと取得件数の制限
抽出された結果は、デフォルトでは順序が保証されていません。
実務では、日付順や数値順など、特定のルールで並び替える必要があります。
ORDER BYによるソート
ORDER BY 句を使用することで、結果を昇順(ASC)または降順(DESC)に並べ替えることができます。
指定を省略した場合は昇順(ASC)になります。
-- 給与が高い順に並び替える
SELECT
    emp_name,
    salary
FROM
    employees
ORDER BY
    salary DESC;
LIMITとOFFSETによる件数制限
大量のデータがある場合、全件を取得すると負荷が高くなります。
LIMIT を使用すると、取得する最大件数を指定できます。
OFFSET を組み合わせることで、Webサイトのページネーションのような「〇件目から取得する」という処理が可能になります。
-- 給与トップ3の社員を取得
SELECT
    emp_name,
    salary
FROM
    employees
ORDER BY
    salary DESC
LIMIT 3;
集約関数とグループ化
SELECT文では、単にデータを取得するだけでなく、計算処理を行うことも可能です。
主要な集約関数
代表的な集約関数には以下のものがあります。
COUNT(): 行数を数えるSUM(): 合計値を算出するAVG(): 平均値を算出するMAX(): 最大値を求めるMIN(): 最小値を求める
-- 全社員の平均給与を算出
SELECT
    AVG(salary) AS 平均給与
FROM
    employees;
GROUP BYによるグループ化
特定の列の値ごとに集計を行いたい場合は、GROUP BY 句を使用します。
例えば、部署ごとの合計給与を算出したい場合に利用します。
SELECT
    department,
    SUM(salary) AS 部署合計給与
FROM
    employees
GROUP BY
    department;
HAVINGによる集計結果の絞り込み
WHERE 句は「集計前」のデータに対して条件判定を行いますが、HAVING 句は「集計後」の結果に対して条件判定を行います。
「平均給与が30万円以上の部署だけを表示する」といった処理は HAVING を使わなければ実現できません。
SELECT
    department,
    AVG(salary) AS 平均給与
FROM
    employees
GROUP BY
    department
HAVING
    AVG(salary) >= 300000;
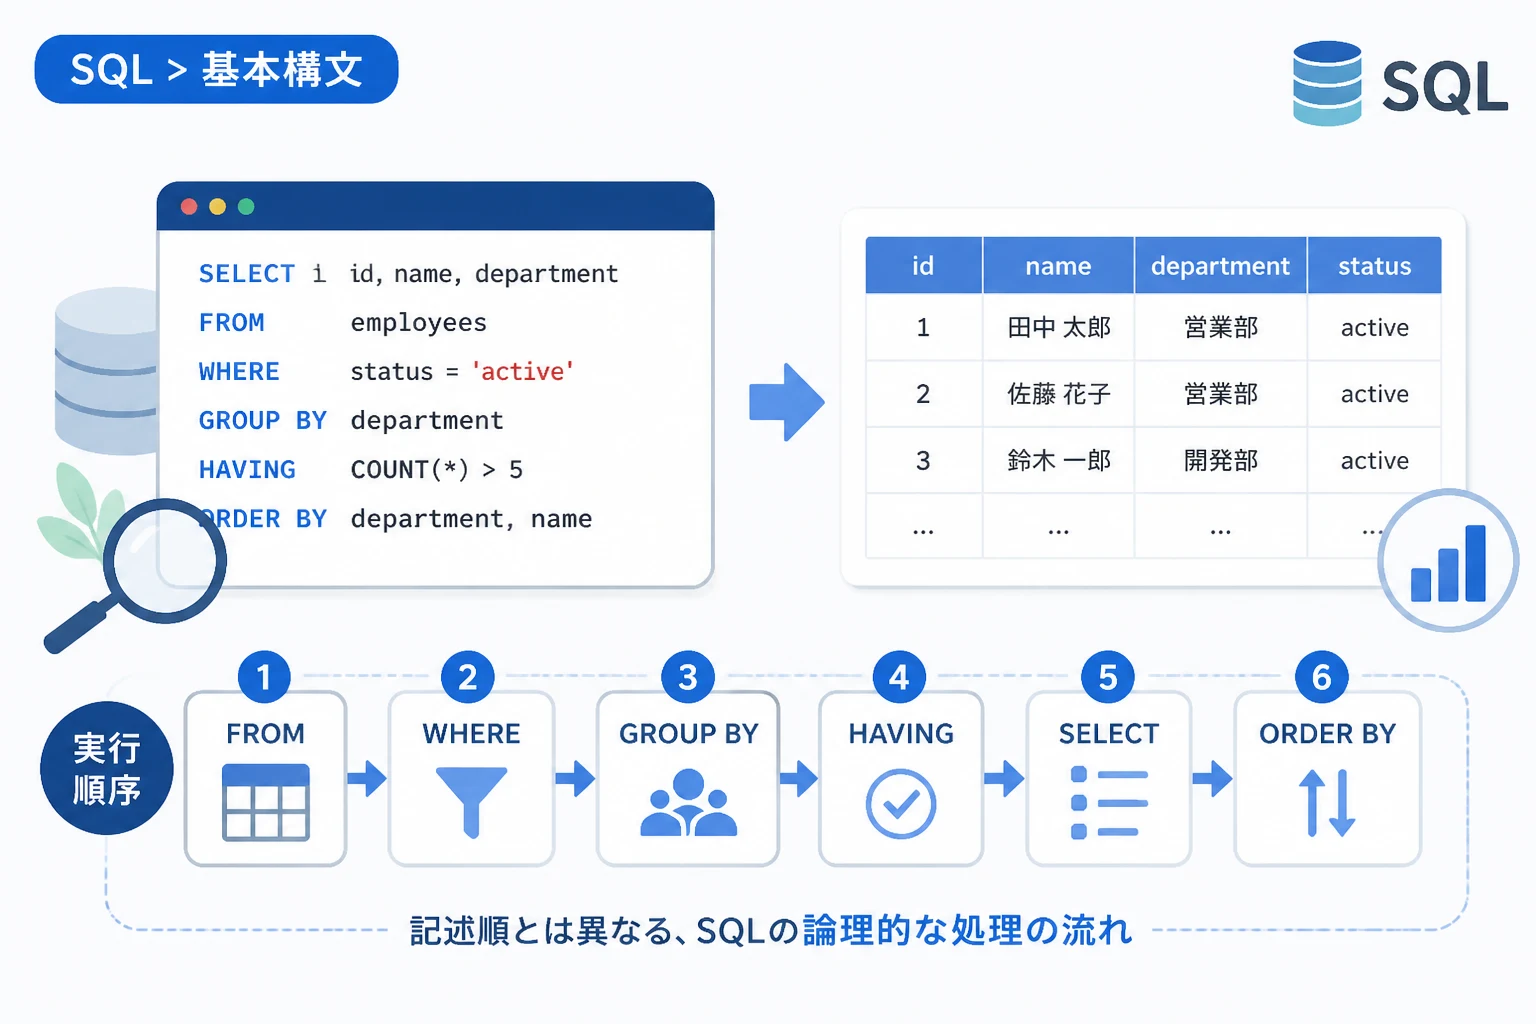
SQL SELECT文の論理実行順序
SQLを書く際に最も重要な概念の一つが、「記述順序」と「実行順序」は異なるという点です。
クエリは上から順番に実行されるわけではありません。
この順序を理解していないと、「なぜSELECT句で付けたエイリアスをWHERE句で使えないのか」といった疑問を解消できなくなります。
論理実行順序のステップ
標準的なSQLにおける実行順序は以下の通りです。
- FROM (テーブルの指定、JOINの結合)
- WHERE (行の絞り込み)
- GROUP BY (グループ化)
- HAVING (グループ化した後の絞り込み)
- SELECT (列の選択、式の計算、エイリアスの付与)
- DISTINCT (重複除去)
- ORDER BY (ソート)
- LIMIT / OFFSET (件数制限)
この順序を見ると分かるように、SELECT句はWHERE句よりも後に評価されます。
そのため、SELECT句で定義した AS 別名 を WHERE 句で使用しようとするとエラーが発生します。
逆に、ORDER BY 句は SELECT 句よりも後に実行されるため、別名を使用して並び替えることが可能です。
実行順序を意識したクエリ作成のコツ
パフォーマンスを最適化するためには、早い段階でデータを絞り込むことが鉄則です。
FROM でテーブルを特定し、WHERE で不要な行を真っ先に排除することで、後の GROUP BY や SELECT の処理対象を減らすことができます。
データ量が多い環境では、「いかに早く行数を減らすか」を常に意識してクエリを構成してください。
複雑なSELECT文の活用テクニック
基本をマスターしたら、より高度な抽出方法にも挑戦しましょう。
CASE式による条件分岐
SELECT句の中で CASE 式を使うと、プログラミングのif文のような条件分岐が可能になります。
抽出結果の値を動的に変換したい場合に非常に役立ちます。
SELECT
    emp_name,
    CASE
        WHEN salary >= 350000 THEN '高給与'
        WHEN salary >= 300000 THEN '平均'
        ELSE '一般'
    END AS ランク
FROM
    employees;
サブクエリ(副問合せ)の利用
SELECT文の結果を、別のSELECT文の条件として利用することができます。
これを「サブクエリ」と呼びます。
-- 全体の平均給与より高い給与をもらっている社員を抽出
SELECT
    emp_name,
    salary
FROM
    employees
WHERE
    salary > (SELECT AVG(salary) FROM employees);
NULLの扱いとCOALESCE関数
データベースには「値が存在しない」状態を示す NULL が含まれることがあります。
NULL に対して演算を行うと結果も NULL になってしまうため、COALESCE 関数などを使ってデフォルト値を設定するのが一般的です。
-- 給与が未設定(NULL)の場合は 0 として表示する
SELECT
    emp_name,
    COALESCE(salary, 0) AS 給与確定値
FROM
    employees;
パフォーマンスを意識したSELECT文の書き方
実務では、データ件数が数百万、数千万件に及ぶことも珍しくありません。
効率の悪いSELECT文はシステム全体の遅延に直結します。
インデックスを意識したWHERE句
検索条件に指定する列には、通常「インデックス」が貼られています。
しかし、列に対して関数を使用したり、左部分一致の LIKE '%キーワード' を使用したりすると、インデックスが効かなくなり、全表走査(フルスキャン)が発生します。
インデックスを最大限活用できるような条件式の書き方を心がけましょう。
必要なカラムだけを抽出する習慣
前述の通り、SELECT * はデバッグ時には便利ですが、本番環境のコードでは避けるべきです。
必要な列のみを明示することで、I/O負荷を軽減し、クエリの実行速度を向上させることができます。
また、将来的にテーブルに列が追加された際、予期せぬ挙動を防ぐことにも繋がります。
SELECT文に関するよくあるミス
エラーは出ないものの、意図しない結果が返ってくるケースには注意が必要です。
NULL比較の誤り
WHERE col = NULL と書いても、期待した結果は得られません。
NULLとの比較には必ず IS NULL または IS NOT NULL を使用してください。
データの型変換による暗黙のキャスト
数値型の列に対して文字列で検索を行うと、暗黙の型変換が発生することがあります。
これが原因でインデックスが使用されず、検索が大幅に遅くなるケースがあります。
検索値のデータ型は、カラムの型と必ず一致させるようにしましょう。
まとめ
SQLのSELECT文は、データベース操作の基盤となる極めて重要なコマンドです。
単に「データを取る」だけでなく、論理的な実行順序を理解し、効率的な絞り込みや集計を行うことで、真のデータ活用が可能になります。
今回学んだ FROM, WHERE, GROUP BY, HAVING, SELECT, ORDER BY の各句の役割と、それらが動く順番を忘れないようにしてください。
日々の開発や分析作業において、適切なSELECT文を記述することは、システムのパフォーマンス向上と正確なアウトプットへの近道です。
まずは基本構文をしっかり身につけ、徐々に複雑なクエリや最適化の手法にステップアップしていきましょう。