
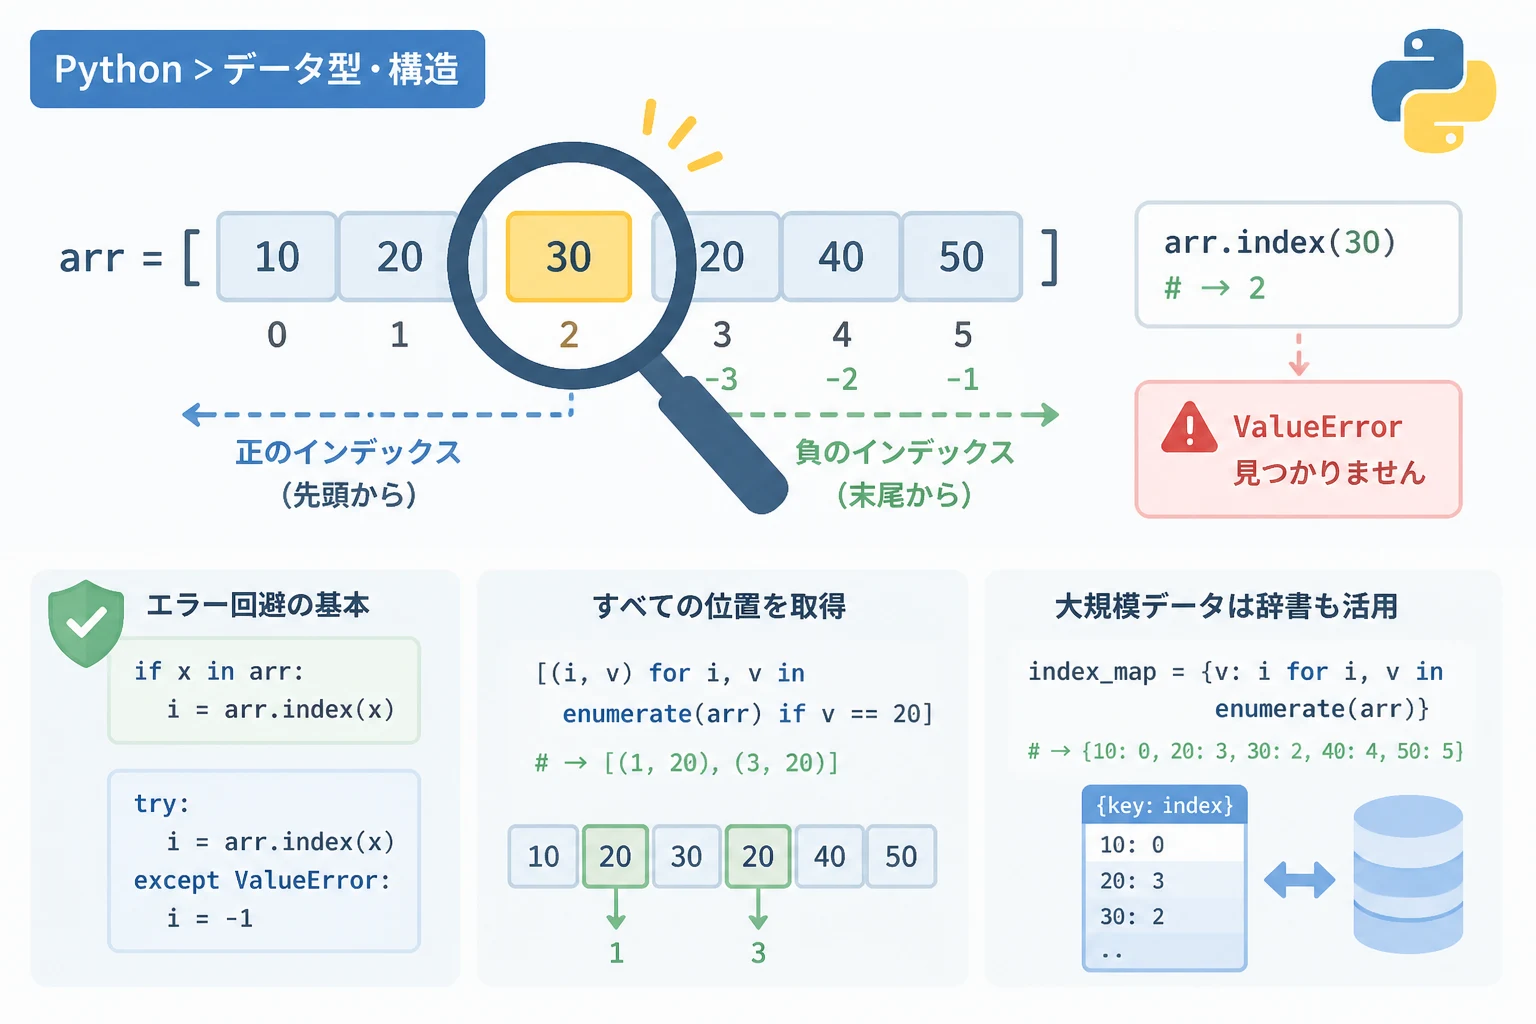
Pythonのプログラミングにおいて、データの位置を特定する「インデックス」の概念は非常に重要です。
リストや文字列などのシーケンス型オブジェクトでは、各要素に一意の番号が割り振られています。
この番号を利用して要素を取り出したり、特定の要素が何番目にあるのかを検索したりする操作は、実務開発で避けて通ることはできません。
本記事では、Pythonの index() メソッドの基本的な使い方から、エラーを回避するための例外処理、さらには効率的なインデックス操作の応用テクニックまで詳しく解説します。
初心者の方が躓きやすいポイントを整理し、実践的なコード例を交えて進めていきましょう。
Pythonにおけるインデックスの基本概念
Pythonのシーケンス型(リスト、タプル、文字列など)では、要素の並び順が保持されています。
それぞれの要素には、先頭から 0から始まる整数 が割り当てられており、これを「インデックス」と呼びます。
多くのプログラミング言語と同様に、Pythonも 「0オリジン(0始まり)」を採用している点 に注意が必要です。
1番目の要素にアクセスしたい場合は、インデックス番号として 0 を指定します。
正のインデックスと負のインデックス
Pythonのユニークな特徴の一つに、負の数値を使ったインデックス指定があります。
正のインデックスは先頭(左側)から数えますが、負のインデックスは 末尾(右側)から数える ことができます。
末尾の要素は -1、その一つ前の要素は -2 というように指定します。
以下のコードで、正と負のインデックスの違いを確認してみましょう。
# リストの定義
fruits = ["apple", "banana", "cherry", "orange"]

# 正のインデックスによるアクセス
print(fruits[0])  # 先頭の要素
print(fruits[2])  # 3番目の要素

# 負のインデックスによるアクセス
print(fruits[-1]) # 末尾の要素
print(fruits[-3]) # 末尾から3番目の要素(banana)apple
cherry
orange
bananaこのように、データの全体の長さがわからない場合でも、負のインデックスを使えば簡単に末尾の要素へアクセスできます。
index()メソッドの基本的な使い方
index() メソッドは、指定した値がシーケンス内の 「どの位置に最初に出現するか」 を検索するために使用されます。
リスト、文字列、タプルのいずれでも利用可能な共通のメソッドです。
リストでのindex()の使用例
リストの中で特定の要素が何番目にあるかを知りたい場合、リスト名.index(検索したい値) と記述します。
# リストの作成
tech_stack = ["Python", "Java", "Go", "Rust", "Python"]

# "Go"の位置を検索
target_index = tech_stack.index("Go")
print(f"'Go'のインデックス: {target_index}")

# 重複する値がある場合
first_python = tech_stack.index("Python")
print(f"最初に見つかった'Python'のインデックス: {first_python}")'Go'のインデックス: 2
最初に見つかった'Python'のインデックス: 0重要な点として、検索対象がリスト内に複数存在する場合、index() メソッドは 最初に見つかったインデックスのみを返す という性質があります。
すべてのインデックスを取得したい場合は、後述するループ処理やリスト内包表記を組み合わせる必要があります。
検索範囲を指定する(startとend)
index() メソッドには、検索を開始する位置と終了する位置を引数として渡すことができます。
構文は index(value, start, end) となります。
numbers = [10, 20, 30, 40, 10, 20, 30, 40]

# インデックス3以降から「10」を検索
index_after_3 = numbers.index(10, 3)
print(f"インデックス3以降にある10の位置: {index_after_3}")

# インデックス2から5の間で「30」を検索
index_range = numbers.index(30, 2, 6)
print(f"指定範囲内の30の位置: {index_range}")インデックス3以降にある10の位置: 4
指定範囲内の30の位置: 2この機能を使うことで、特定の範囲内だけを効率的に探索することが可能になります。
文字列におけるインデックス検索
文字列(str型)においても index() メソッドは同様に機能します。
ただし、文字列の場合は 「部分一致」 の検索も可能です。
text = "Python programming is fun and powerful."

# 文字列内での検索
pos = text.index("programming")
print(f"'programming'の開始位置: {pos}")'programming'の開始位置: 7find()メソッドとの違い
文字列オブジェクトには、index() とよく似た機能を持つ find() メソッドが存在します。
両者の最大の違いは、 「値が見つからなかった時の挙動」 です。
| メソッド | 値が見つからない場合の挙動 | 適用可能な型 |
|---|---|---|
| index() | ValueError を送出する | リスト、タプル、文字列 |
| find() | -1 を返す | 文字列のみ |
プログラムを停止させたくない場合や、条件分岐で存在チェックを行いたい場合には、文字列に限り find() を使う方が便利なケースが多いです。
ValueErrorの回避と例外処理
index() メソッドを使用する際、最も注意すべきなのが ValueError です。
指定した要素がシーケンス内に存在しない場合、Pythonは即座にエラーを出してプログラムを中断します。
my_list = [1, 2, 3]

# 存在しない値を検索
# print(my_list.index(100)) # ここでValueErrorが発生
try-except文によるエラーハンドリング
実務的なコードでは、以下のように try-except ブロックを使用してエラーを適切に処理します。
items = ["apple", "banana", "orange"]
search_target = "grape"

try:
    idx = items.index(search_target)
    print(f"見つかりました: インデックス {idx}")
except ValueError:
print(f"エラー: '{search_target}' はリスト内に存在しません。")エラー: 'grape' はリスト内に存在しません。このように例外処理を記述することで、ユーザーに対して分かりやすいメッセージを表示したり、代替の処理を実行したりできます。
in演算子による事前チェック
例外処理を書くのが面倒な場合や、検索前に存在を確認したい場合は in 演算子が有効です。
in 演算子は、要素が存在するかどうかを 真偽値(True/False) で返します。
if search_target in items:
    idx = items.index(search_target)
    print(f"インデックス: {idx}")
else:
print("存在しません")ただし、この方法は「in で1回スキャンし、index() でもう一度スキャンする」という二重の手間が発生するため、データ量が多い場合はパフォーマンスに影響を与える可能性があります。
応用:複数のインデックスをすべて取得する方法
標準の index() メソッドでは最初の一つしか見つけられませんが、実務では「該当するすべての位置を知りたい」という場面が多々あります。
その場合は、 enumerate() 関数 と リスト内包表記 を組み合わせるのが Pythonic な(Pythonらしい)書き方です。
data = [1, 2, 3, 2, 4, 2, 5]
target = 2

# targetと一致するインデックスをすべて抽出
indices = [i for i, x in enumerate(data) if x == target]

print(f"値 {target} が見つかったすべての位置: {indices}")値 2 が見つかったすべての位置: [1, 3, 5]enumerate() は、ループの中で「インデックス」と「要素の値」を同時に取り出せる非常に便利な関数です。
パフォーマンス上の注意点
index() メソッドの計算量は、リストの要素数を $n$ とすると O(n) です。
これは「線形探索」と呼ばれ、リストの先頭から一つずつ順番に値をチェックしていく仕組みだからです。
要素数が数百万件を超えるような巨大なリストに対して、頻繁に index() を呼び出すと、プログラムの動作が著しく低下する恐れがあります。
もし高速な検索が何度も必要な場合は、データ構造を セット(set) や 辞書(dict) に変換することを検討してください。
辞書型であれば、ハッシュテーブルを利用するため、ほぼ一定時間 O(1) で検索が可能になります。
スライス操作によるインデックス制御
インデックスに関連する重要な操作として「スライス」があります。
これは、特定の範囲の要素をまとめて取り出す手法です。
構文は オブジェクト[start:stop:step] となります。
chars = ["a", "b", "c", "d", "e", "f"]

# インデックス1から3まで(4の手前まで)取得
print(chars[1:4])

# 先頭から2つおきに取得
print(chars[::2])

# リストを反転させる
print(chars[::-1])['b', 'c', 'd']
['a', 'c', 'e']
['f', 'e', 'd', 'c', 'b', 'a']インデックスの数値を直接指定する index() と、範囲を指定するスライスを組み合わせることで、データの抽出自由度は格段に上がります。
多次元リスト(ネストされたリスト)の検索
リストの中にリストが含まれている場合、通常の index() では子要素の中身まで検索してくれません。
多次元リストの要素を検索するには、ループ処理や再帰的なアプローチが必要です。
matrix = [
    ["id", "name"],
    [1, "Alice"],
    [2, "Bob"]
]

# "Alice"が含まれる行を探す
for i, row in enumerate(matrix):
    if "Alice" in row:
        col_idx = row.index("Alice")
print(f"行インデックス: {i}, 列インデックス: {col_idx}")行インデックス: 1, 列インデックス: 1表形式のデータを扱う際は、このようにインデックスを多層的に管理するスキルが求められます。
まとめ
Pythonにおけるインデックス操作と index() メソッドは、データ処理の根幹を支える技術です。
本記事で解説した主要なポイントを振り返りましょう。
- Pythonのインデックスは 0から始まる。
- 負のインデックスを使うと 末尾からの指定 ができる。
index()は最初に見つかった位置を返すが、 見つからないとエラー(ValueError) になる。- エラーを避けるには
try-exceptやin演算子を活用する。 - すべての出現位置を取得するには
enumerate()とリスト内包表記が便利。 - 大量のデータ検索には、リストよりも 辞書やセット の方が高速。
これらの基本をマスターすることで、リスト操作のバグを減らし、より効率的なコードが書けるようになります。
日々のコーディングの中で、エラーハンドリングを意識しながら index() を使いこなしてみてください。