
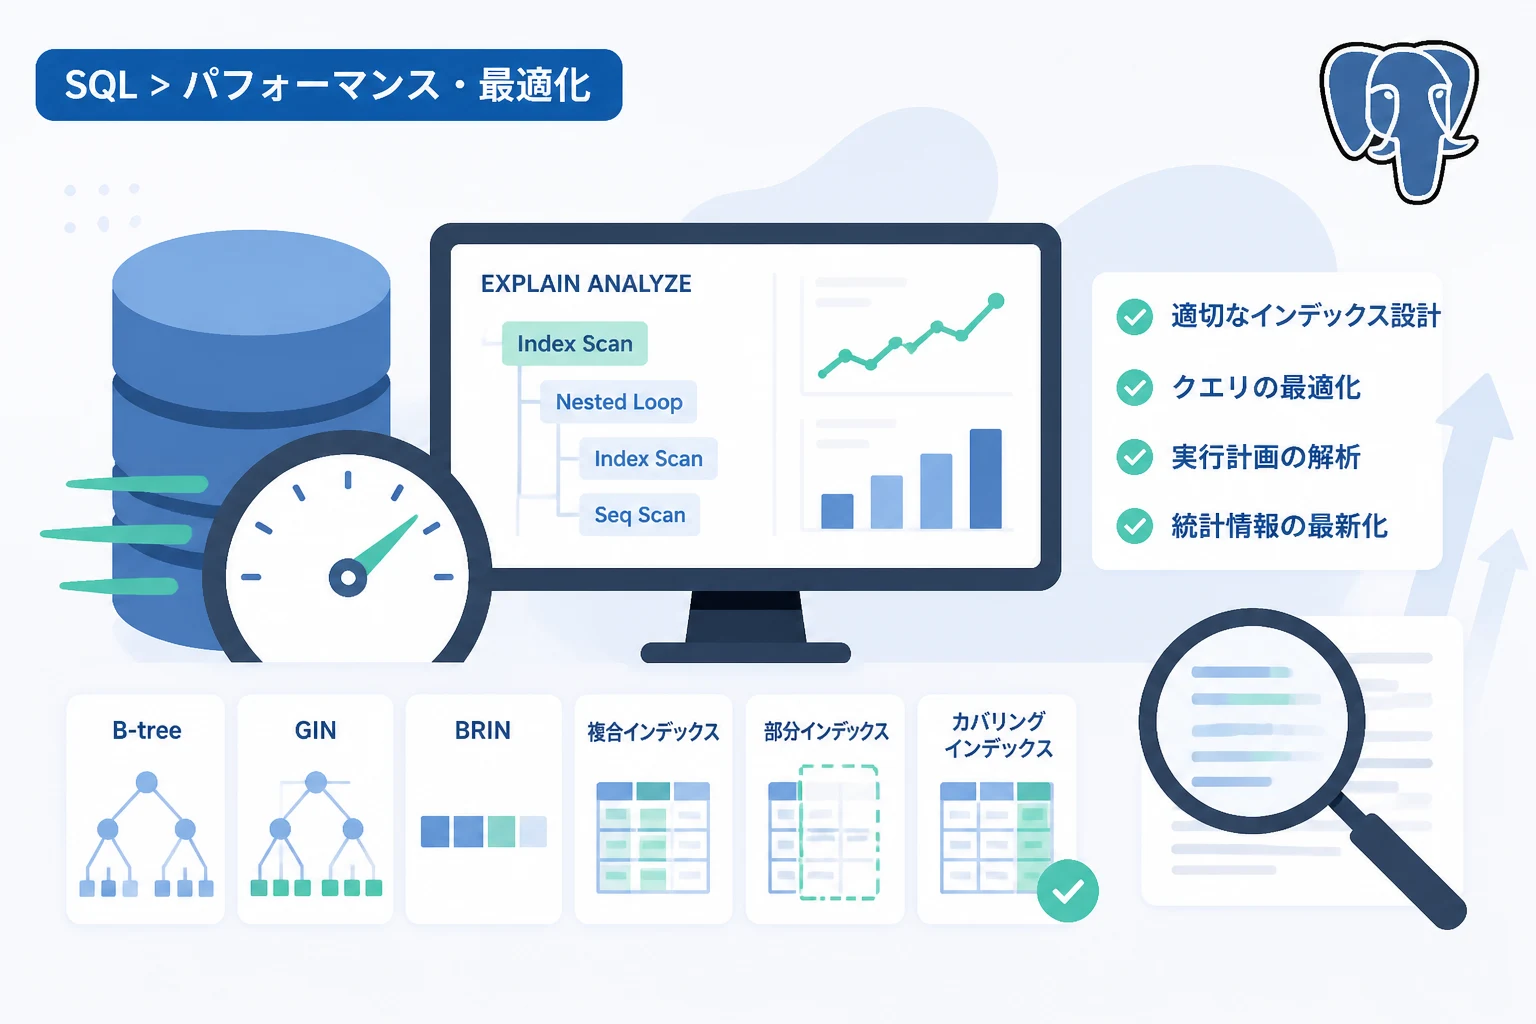
2026年現在、データドリブンな意思決定がビジネスの根幹を成す中で、データベースのパフォーマンス改善はエンジニアにとって不可欠なスキルとなっています。
特にPostgreSQLは、その堅牢性と拡張性から多くのエンタープライズシステムで採用されており、日々膨大なクエリが実行されています。
しかし、データ量が増大するにつれて、初期設計のままではレスポンスタイムが悪化し、ユーザー体験を損なうケースが少なくありません。
本記事では、PostgreSQLにおいてSQLを高速化するためのインデックス設計の基本から、実行計画を用いたクエリ最適化の実践的な手法までを詳しく解説します。
現場で即座に活用できるテクニックを習得し、システムのボトルネックを解消するための知識を深めていきましょう。
PostgreSQLにおけるインデックスの重要性と基本構造
データベースのパフォーマンスを左右する最大の要因は、ディスクI/O(入出力)をいかに削減するかという点にあります。
インデックスは、特定のカラムの値をキーとして、データの格納場所を指し示すポインタを保持するデータ構造です。
PostgreSQLでは、デフォルトでB-tree(Balanced Tree)インデックスが使用されます。
B-treeは、等価比較(=)や範囲比較(<, >=, BETWEEN)に対して非常に効率的に動作します。
インデックスが適切に設計されていない場合、PostgreSQLはテーブルの全データを走査する「シーケンシャルスキャン」を実行せざるを得ません。
データ件数が数百万件、数億件と増えるにつれ、シーケンシャルスキャンによる遅延は無視できないものとなります。
そのため、適切なインデックスを選択し、クエリの特性に合わせることが高速化の第一歩となります。
PostgreSQLで利用可能なインデックスの種類
PostgreSQLには、用途に応じて使い分けられる多様なインデックスタイプが用意されています。
B-treeインデックスは、ソート可能なデータに対して汎用的に使用できる最も強力なインデックスです。
GIN(Generalized Inverted Index)は、全文検索やJSONB型、配列などの複数の値を持つカラムの検索に最適です。
GiST(Generalized Search Tree)は、幾何学データや地理空間情報の検索に頻繁に使用されます。
BRIN(Block Range Index)は、時系列データのように物理的な順序と論理的な順序が一致している巨大なテーブルにおいて、ストレージ容量を抑えつつ高速化を実現します。
以下の表は、それぞれのインデックスの主な用途をまとめたものです。
| インデックス種別 | 主な用途 | 適した演算子 |
|---|---|---|
| B-tree | 一般的な用途、一意性制約 | =, <, >, BETWEEN, IN |
| GIN | JSONB、配列、全文検索 | @>, ?, && |
| GiST | 空間データ、範囲型 | &&, <@, << |
| BRIN | 非常に巨大な時系列データ | =, <, > (相関が高い場合) |
インデックス設計の実践手法
単一カラムにインデックスを貼るだけでは、複雑なクエリの高速化には不十分な場合があります。
現場では、複数の条件を組み合わせた検索や、特定の条件でのみ有効なインデックスが必要とされるからです。
複合インデックス(マルチカラムインデックス)の活用
複数のカラムを条件に指定するクエリでは、複合インデックスの作成を検討してください。
複合インデックスを作成する際は、カラムの順番が極めて重要になります。
一般的に、等価条件(=)で使用されるカラムを左側に、範囲条件で使用されるカラムを右側に配置するのが基本です。
また、カーディナリティ(値のバリエーション)が高いカラムをインデックスの先頭に配置することで、検索効率が向上します。
-- 複合インデックスの作成例
CREATE INDEX idx_orders_customer_date ON orders (customer_id, order_date);このインデックスは、customer_idのみを指定した検索や、customer_idとorder_dateの両方を指定した検索で有効に機能します。
しかし、order_dateのみを指定した検索では、このインデックスは基本的に使用されない点に注意してください。
カバリングインデックスとINCLUDE句
インデックスだけでクエリの結果を返却できれば、テーブル本体へのアクセス(Heap Access)を省略できます。
これを「Index Only Scan」と呼び、非常に高速なレスポンスが期待できます。
PostgreSQLでは、INCLUDE句を使用することで、インデックスのキーには含めないが、値として保持しておきたいカラムを指定できます。
-- カバリングインデックスの作成例
CREATE INDEX idx_users_email_include_name ON users (email) INCLUDE (user_name);
この設定により、メールアドレスからユーザー名を取得するクエリにおいて、テーブルデータへのアクセスを回避できます。
カバリングインデックスを適切に活用することで、I/O負荷を大幅に削減することが可能です。
部分インデックスによる効率化
テーブル内の特定の行だけを対象にしたインデックスを「部分インデックス」と呼びます。
例えば、「論理削除されていないデータのみ」や「ステータスが完了以外のデータのみ」を検索対象とする場合です。
インデックスのサイズを小さく保つことができ、更新コストも低減できるため非常に効率的です。
-- 部分インデックスの作成例
CREATE INDEX idx_active_tasks ON tasks (priority) WHERE status != 'completed';
EXPLAIN ANALYZEを用いた実行計画の解析
SQLの高速化を実現するためには、PostgreSQLがどのようにクエリを実行しているかを把握する必要があります。
そのための強力なツールがEXPLAINコマンドです。
特に、実際にクエリを実行して詳細な統計情報を出力するEXPLAIN ANALYZEを活用しましょう。
実行計画の確認方法
クエリの先頭にEXPLAIN (ANALYZE, BUFFERS)を付与して実行します。
BUFFERSオプションを付けることで、共有バッファのヒット率を確認でき、ディスクI/Oの発生状況を把握できます。
EXPLAIN (ANALYZE, BUFFERS)
SELECT * FROM orders WHERE customer_id = 12345;
実行結果には、以下のような情報が含まれます。
Index Scan using idx_orders_customer_id on orders  (cost=0.43..8.45 rows=1 width=120) (actual time=0.045..0.047 rows=1 loops=1)
  Index Cond: (customer_id = 12345)
  Buffers: shared hit=4
Planning Time: 0.123 ms
Execution Time: 0.082 msここで注目すべきは、Index Scanが行われているか、それともSeq Scan(シーケンシャルスキャン)になっているかです。
意図した通りにインデックスが使われていない場合は、統計情報が古いか、クエリの書き方に問題がある可能性があります。
よくある「インデックスが効かない」原因
インデックスを定義しているにもかかわらず、PostgreSQLがそれを使用しないケースがいくつか存在します。
演算子や関数をカラムに対して適用している場合、インデックスは無効化されます。
例えば、WHERE date_trunc('day', created_at) = '2026-05-15'という条件では、created_atのインデックスは使用されません。
このような場合は、式インデックスを作成するか、クエリ側をWHERE created_at >= '2026-05-15' AND created_at < '2026-05-16'のように書き換える必要があります。
-- 式インデックスの例
CREATE INDEX idx_orders_day ON orders (date_trunc('day', created_at));
クエリ最適化のテクニック
インデックスの設計と並行して、SQLクエリ自体の記述方法を見直すことも重要です。
非効率なクエリは、どれほどインデックスを貼ってもリソースを無駄に消費してしまいます。
SELECT * を避ける
業務アプリケーション開発で無意識に使われがちなSELECT *ですが、これはパフォーマンス上のリスクを孕んでいます。
必要なカラムのみを指定することで、データ転送量を削減し、先述したIndex Only Scanを誘発しやすくします。
特に、大きなテキストデータ(TEXT型)やJSONB型のカラムが含まれる場合、それらを不要に読み込むことはメモリ消費の増大に直結します。
結合(JOIN)の最適化
複数のテーブルを結合する際、PostgreSQLのクエリオプティマイザは最適な結合アルゴリズムを選択しようとします。
結合アルゴリズムには、Nested Loop、Hash Join、Merge Joinの3種類があります。
Nested Loopは、駆動表(外側のテーブル)が小さく、内部表の結合キーにインデックスがある場合に非常に高速です。
一方で、大量のデータを結合する場合は、Hash Joinの方が効率的になることが一般的です。
結合順序が不適切なためにパフォーマンスが低下している場合は、統計情報を最新に保つことが解決への近道となります。
サブクエリとCTE(共通テーブル式)の使い分け
PostgreSQL 12以降、CTE(WITH句)はデフォルトでインライン化されるようになり、最適化が進んでいます。
しかし、複雑な集計を行う場合は、CTE内でマテリアライズ(一時保存)されることがあります。
クエリの可読性を高めるためにCTEを使うのは良い習慣ですが、パフォーマンスが低下した場合はサブクエリへの書き換えを試してみる価値があります。
逆に、同じ集計結果を複数回参照する場合は、CTEを利用して一度だけ計算する方が効率的です。
運用管理と統計情報の更新
PostgreSQLのクエリオプティマイザは、テーブルの統計情報に基づいて実行計画を作成します。
データの分布が大幅に変わったにもかかわらず統計情報が古いと、オプティマイザが誤った判断を下してしまいます。
ANALYZEコマンドの活用
データの一括投入(バルクインサート)や大量の更新を行った後は、明示的にANALYZEコマンドを実行してください。
ANALYZE VERBOSE orders;これにより、テーブルの統計情報が最新になり、オプティマイザがより正確な実行計画を選択できるようになります。
通常はautovacuumプロセスがバックグラウンドで統計情報を収集しますが、急激なデータ変更には手動のANALYZEが有効です。
VACUUMによる不要領域の回収
PostgreSQLは多版型同時実行制御(MVCC)を採用しているため、UPDATEやDELETEを行うと「不要な行(死んだタプル)」が発生します。
これらが蓄積されると、テーブルやインデックスのサイズが肥大化し(Bloat)、スキャン速度が低下します。
autovacuumが適切に設定されているかを確認し、必要に応じて設定値を調整して、不要領域が迅速に回収されるようにしましょう。
-- テーブルの肥大化具合を確認するクエリ(簡易版)
SELECT relname, n_dead_tup, last_autovacuum FROM pg_stat_user_tables;
まとめ
PostgreSQLの高速化は、単一の魔法のような設定ではなく、地道なインデックス設計とクエリの改善の積み重ねによって実現されます。
まずはB-treeインデックスの基本を押さえ、検索条件に合わせた複合インデックスや部分インデックスを検討しましょう。
次に、EXPLAIN ANALYZEを活用して、ボトルネックとなっているスキャンや結合を見つけ出し、クエリの書き方を最適化します。
また、インデックスの性能を最大限に引き出すためには、統計情報を最新に保つ運用が不可欠です。
最新のPostgreSQLの機能を活用しながら、現場の環境に合わせた最適なチューニングを継続していきましょう。
これらの手法を実践することで、大規模なデータセットに対しても安定したパフォーマンスを発揮するデータベースを構築できるはずです。