
C言語の学習を進めていく中で、多くのプログラマーが最初に突き当たる壁の一つが日本語、特に「全角文字」の扱いです。
標準的な教科書で学ぶchar型やstrlen関数は、主に1バイトで1文字を表現する英語圏の文字(ASCII)を前提として設計されています。
しかし、現代のソフトウェア開発において日本語の処理を避けて通ることはできず、適切な知識がなければ文字化けやプログラムの異常終了を引き起こす原因となります。
本記事では、C言語で全角文字を扱うための基礎知識から、UTF-8とワイド文字の具体的な使い分け、そして正確な文字数をカウントする方法までを詳しく解説します。
C言語における全角文字の定義とバイト数の関係
C言語において、全角文字は「マルチバイト文字列」として扱われることが一般的です。
私たちが普段使用している日本語の全角文字は、コンピュータ内部では1バイトではなく、複数のバイトを組み合わせて表現されています。
かつてはShift_JIS(SJIS)が多く使われていましたが、現在の主流はUTF-8という文字コードです。
UTF-8では、半角英数字は1バイトで表現されますが、日本語の全角文字は基本的に3バイトを使用して表現されます。
この「1文字が複数バイトである」という事実が、C言語での文字列処理を複雑にする最大の要因です。
例えば、char str[] = "あ";という宣言を行った場合、この配列には「あ」の3バイト分と、終端文字であるヌル文字(\0)の1バイト、合計4バイトが格納されます。
strlen関数が全角文字で正しく動作しない理由
C言語の標準ライブラリに含まれるstrlen関数は、厳密には「文字数」を数える関数ではありません。
strlenは、文字列の先頭からヌル文字が出現するまでのバイト数をカウントする関数です。
そのため、UTF-8で「こんにちは」という5文字の全角文字列をstrlenに渡すと、結果は「15」となります。
以下に、実際の挙動を確認するためのプログラムを示します。
#include <stdio.h>
#include <string.h>

int main(void) {
    // UTF-8環境を想定
    char text[] = "日本語";

    // strlenはバイト数を返す
    printf("文字列: %s\n", text);
    printf("strlenの結果: %zu\n", strlen(text));

    return 0;
}文字列: 日本語
strlenの結果: 9このように、期待した「3文字」という結果は得られず、UTF-8でのバイト数である「9」が出力されます。
もしプログラム内で「画面上に表示される文字数」に基づいた処理が必要な場合、strlenをそのまま使うことはできません。
ワイド文字(wchar_t)を使用した日本語処理
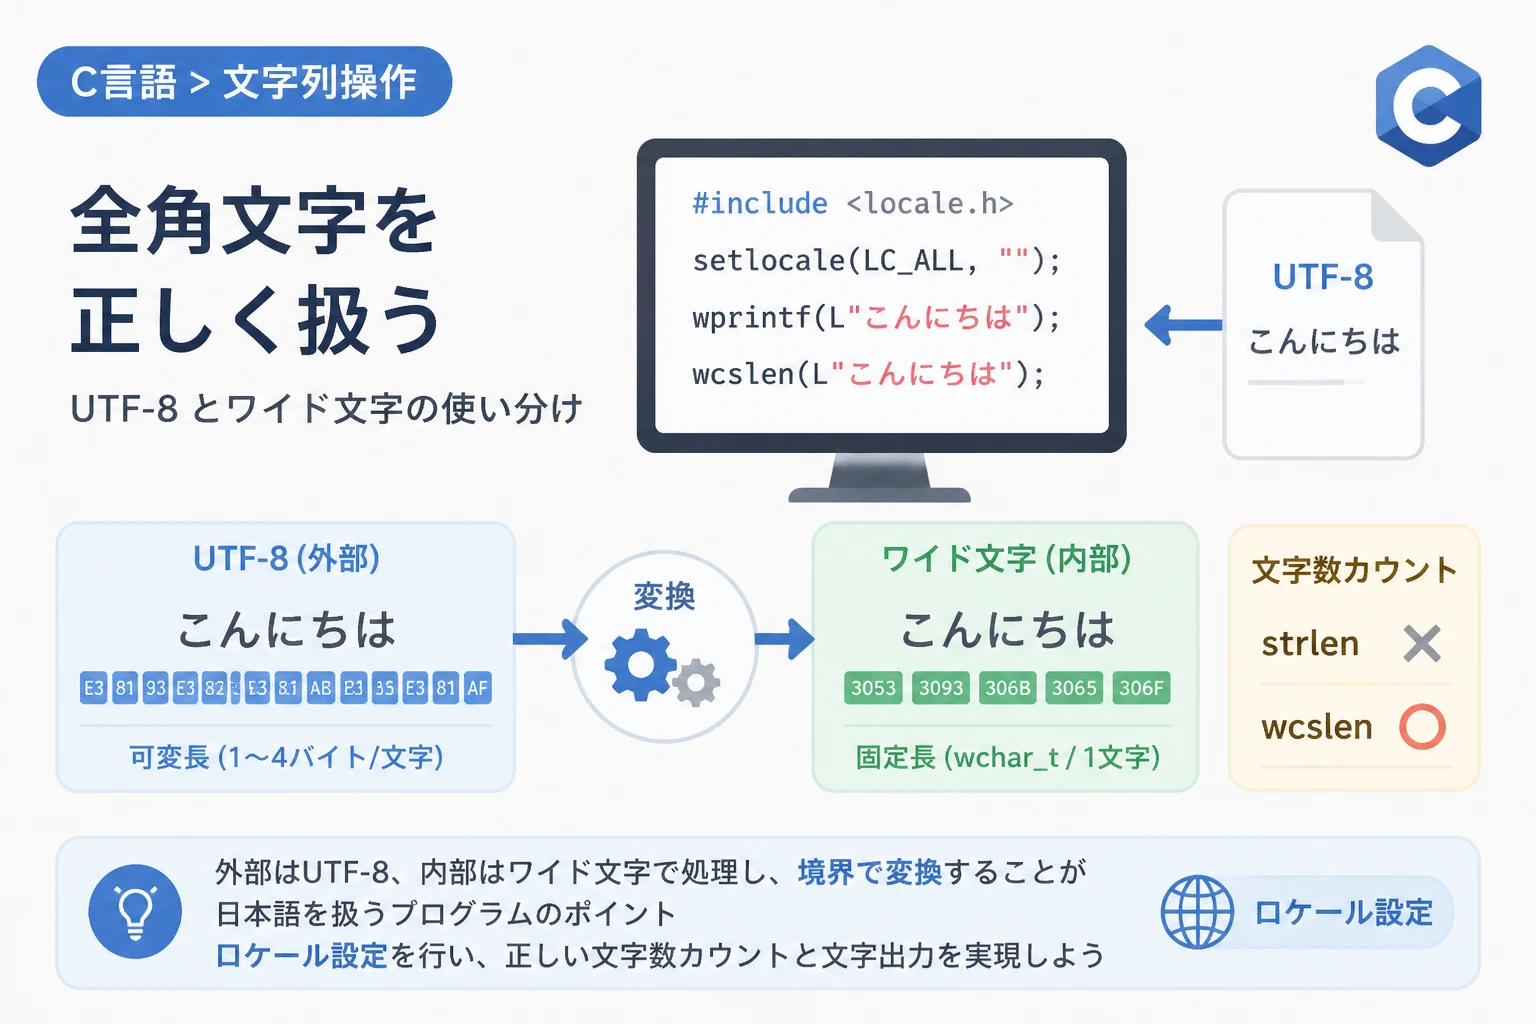
全角文字をより直感的に扱うための方法として、ワイド文字(wchar_t型)を使用する手法があります。
ワイド文字とは、全ての文字を固定のバイト数(多くの環境では2バイトまたは4バイト)で表現するデータ型です。
ワイド文字を使用することで、全角文字も半角文字も「1文字」として平等に扱うことが可能になります。
ワイド文字リテラルとLプレフィックス
ワイド文字をコード内で記述する際は、文字列リテラルの前にLを付けます。
例えば、L"日本語"のように記述します。
この表記により、コンパイラは文字列を通常のchar配列ではなく、wchar_t配列として処理します。
wprintf関数による全角文字の出力
ワイド文字を出力するためには、通常のprintfではなく、wprintf関数を使用する必要があります。
また、ワイド文字を正しく表示するためには、locale.hをインクルードし、ロケールの設定を行うことが不可欠です。
以下のサンプルコードは、ワイド文字を使用して全角文字列の文字数を正しくカウントする例です。
#include <stdio.h>
#include <wchar.h>
#include <locale.h>

int main(void) {
    // システムの標準ロケール(通常は日本語UTF-8)に設定
    setlocale(LC_ALL, "");

    // ワイド文字として文字列を定義
    wchar_t w_text[] = L"プログラミング";

    // wcslen関数を使用してワイド文字の文字数を取得
    printf("文字列の長さ: %zu\n", wcslen(w_text));

    // wprintfを使用してワイド文字を出力
    wprintf(L"出力内容: %ls\n", w_text);

    return 0;
}文字列の長さ: 7
出力内容: プログラミングこのプログラムでは、wcslen関数を使用することで、全角文字であっても正確に「7文字」という結果を得ることができています。
UTF-8とワイド文字の使い分け
C言語で開発を行う際、UTF-8(マルチバイト)とワイド文字のどちらを使うべきか迷うことがあります。
一般的には、以下の表のような基準で使い分けるのが推奨されます。
| 項目 | UTF-8 (マルチバイト) | ワイド文字 (wchar_t) |
|---|---|---|
| 主な用途 | ファイル保存、ネットワーク通信、外部出力 | プログラム内部での文字列加工、文字数カウント |
| メモリ効率 | 英数字は1バイトなので効率が良い | 全ての文字が固定長(2〜4バイト)のため消費が多い |
| 処理の容易さ | 1文字が可変長のため、インデックス操作が困難 | 1文字が固定長のため、配列として扱いやすい |
| 標準関数の互換性 | 既存の多くの関数がそのまま使える(バイト単位) | 専用のwcs系関数を使用する必要がある |
理想的な実装は、「入力と出力はUTF-8で行い、プログラム内部の複雑な処理ではワイド文字に変換して扱う」という構成です。
これを「境界での変換」と呼び、多くのモダンなアプリケーションで採用されている設計パターンです。
ロケール設定(setlocale)の重要性
C言語の標準ライブラリで日本語を扱う場合、ロケール(Locale)の設定を忘れてはいけません。
デフォルトの状態では、C言語の実行環境は「Cロケール(ASCII)」として動作しています。
この状態では、wprintfや後述する変換関数が日本語を正しく認識できず、出力が空になったり文字化けしたりします。
プログラムの開始直後にsetlocale(LC_ALL, "");を実行することで、OSが設定している現在の言語環境(通常は日本語)が適用されます。
これを忘れると、どれほど正しいコードを書いても全角文字が正しく処理されないため、おまじないのように記述する習慣をつけましょう。
マルチバイト文字列からワイド文字への変換
外部から読み込んだUTF-8の文字列を、文字数カウントや加工のためにワイド文字へ変換する必要がある場面は多々あります。
この際に便利なのが、mbstowcs(multibyte string to wide character string)関数です。
この関数を使用することで、可変長のUTF-8文字列を固定長のワイド文字列配列に展開できます。
#include <stdio.h>
#include <stdlib.h>
#include <locale.h>

int main(void) {
    setlocale(LC_ALL, "");

    const char *mb_str = "全角文字のテスト";
    wchar_t wc_str[128];

    // マルチバイト文字列をワイド文字列に変換
    // 第3引数は変換する最大文字数
    size_t num_converted = mbstowcs(wc_str, mb_str, 127);

    if (num_converted == (size_t)-1) {
        perror("変換失敗");
        return 1;
    }

    printf("変換後の文字数: %zu\n", num_converted);

    return 0;
}変換後の文字数: 8このように、mbstowcsを利用することで、UTF-8形式のデータから論理的な文字数を取得することが可能になります。
全角・半角が混在する文字列の文字数カウント手法
実際の開発では、全角文字と半角文字が混在する文字列を扱うケースがほとんどです。
単純に文字数を数えるだけでなく、「表示上の幅」を考慮しなければならないこともあります。
ここでは、代表的な2つのアプローチを紹介します。
1. ワイド文字への変換によるカウント
前述の通り、mbstowcsやwcslenを使用する方法が最も標準的で安全です。
この方法は、文字のエンコーディング(UTF-8など)を意識することなく、論理的な文字数を取得できます。
2. UTF-8のバイト構造を解析するカウント
ライブラリの制約などでワイド文字を使えない場合、UTF-8のバイト構造を直接解析して文字数を数えることも可能です。
UTF-8では、各文字の1バイト目を見ることで、その文字が何バイトで構成されているかを判別できるルールがあります。
具体的には、最上位ビットが0なら1バイト文字、110で始まれば2バイト文字、1110で始まれば3バイト文字といった具合です。
ただし、この実装は非常に複雑になりやすく、不規則なバイト列が含まれていた場合の例外処理も困難です。
特別な理由がない限り、標準ライブラリのワイド文字変換関数を利用することを強く推奨します。
表示幅(カラム数)の考慮:wcwidth関数
文字数カウントにおいてもう一つ重要なのが「表示幅」です。
全角文字は「2カラム」、半角文字は「1カラム」の幅を占有するのが一般的です。
wcslenで得られるのはあくまで「文字数」であり、表示したときの長さではありません。
コンソールアプリケーションなどで文字の揃え(整列)を行いたい場合は、wcwidth関数(POSIX標準)などを使用して各文字の幅を取得する必要があります。
C言語標準だけでは完結しない部分もありますが、日本語処理においては避けて通れない概念です。
開発環境ごとの注意点(Windows vs Linux)
C言語での全角文字処理は、実行するOS環境によって挙動が異なる場合があるため注意が必要です。
Windows環境(Visual Studioなど)
Windowsのwchar_tは伝統的に2バイト(UTF-16)として定義されています。
そのため、サロゲートペアが必要な一部の特殊な漢字や絵文字を扱う際、1文字が2つのwchar_t要素を消費することがあります。
また、ソースコード自体の保存形式がShift_JIS(CP932)になっていることも多いため、コンパイルオプションでUTF-8を指定するなどの工夫が必要です。
Linux/macOS環境(GCC/Clangなど)
多くのLinux環境ではwchar_tは4バイト(UTF-32相当)です。
これにより、ほとんどの文字を1要素で表現できるため、Windowsよりもワイド文字の扱いは比較的シンプルです。
しかし、メモリ消費量が増えるという側面もあるため、大規模な文字列データを扱う際には留意してください。
よくあるトラブルと解決策
全角文字を扱っていて「プログラムが動かない」と感じたときは、以下のチェックリストを確認してみてください。
- 出力が「?」や「文字化け」になる:
setlocaleを呼び出しているか、ターミナルの文字コード設定とプログラムの文字コードが一致しているかを確認してください。 wcslenの結果がおかしい: 文字列リテラルの前にLを付け忘れていないか、あるいはマルチバイト文字列をそのままwchar_t*にキャストしていないかを確認してください。printfでワイド文字が表示されない: ワイド文字の出力には%sではなく%lsを使用する必要があります。
まとめ
C言語で全角文字を適切に処理するためには、まず「バイト数」と「文字数」を明確に区別することが第一歩です。
strlen関数などの伝統的な関数はバイト単位で動作するため、日本語処理には適していません。
正確な文字数をカウントしたり、文字列を1文字ずつ加工したりする場合は、wchar_t型とsetlocale関数を組み合わせたワイド文字処理を検討してください。
また、UTF-8(マルチバイト文字列)とワイド文字にはそれぞれ長所と短所があるため、用途に合わせて適切に使い分けることが重要です。
近年の開発環境ではUTF-8が標準となりつつありますが、C言語の低レイヤーな視点から文字コードの仕組みを理解することは、より堅牢なプログラムを書くための強力な武器となります。
まずは簡単な文字列変換や文字数カウントから実装を始め、日本語処理に慣れていきましょう。