
AIエージェントが急速に普及する中で、多くの開発者が共通の課題に直面しています。
ユーザーが月曜日に相談した内容を、水曜日のエージェントが全く覚えていないという事態は、実用化における大きな障壁となります。
どれほど高度なLLMを基盤にしていても、「記憶」の設計が不十分であれば、エージェントは単なるステートレスなプログラムに過ぎません。
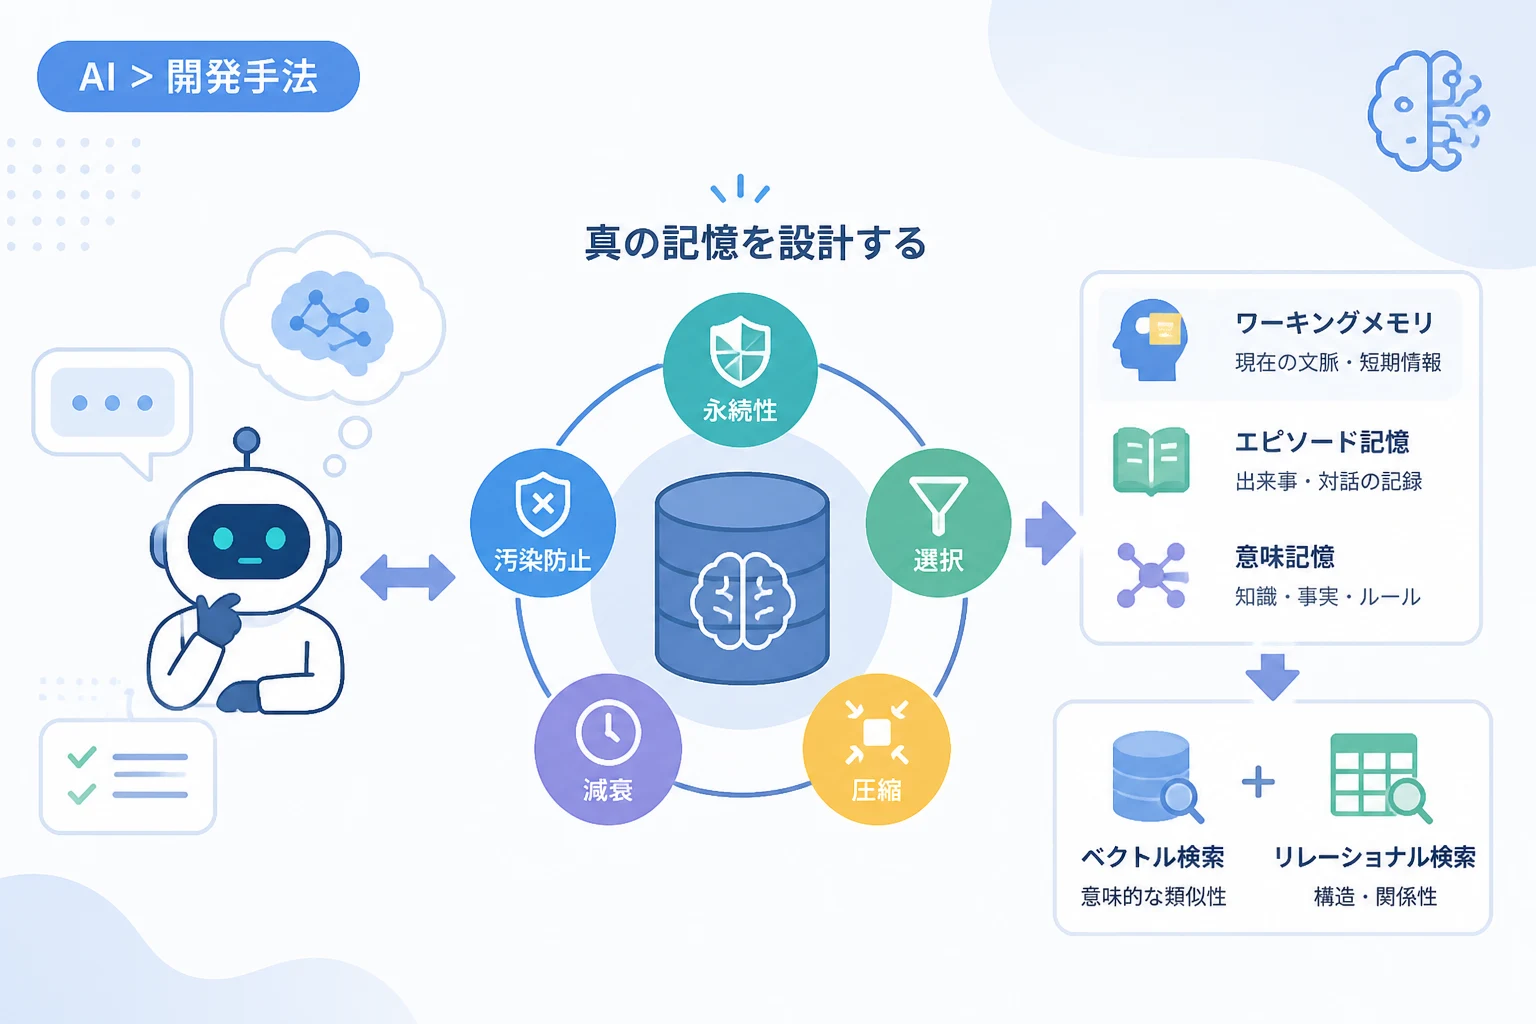
本記事では、AIエージェントが真の意味で「記憶」を持つために必要な5つの要素と、その実装における技術的アプローチを深掘りします。
エージェントにおける「記憶」の定義を再考する
まず、混同されやすい概念を整理することから始めましょう。
AIの文脈で語られる「記憶」は、既存のシステムエンジニアリングにおける「整合性」や「状態管理」とは本質的に異なります。
よくある誤解の一つは、「冪等性(Idempotency)」を記憶と呼ぶことです。
重複したリクエストを排除する仕組みは、単なる通信の制御であり、歴史を振り返る能力ではありません。
次に、「ワークフローの状態(State Machine)」も記憶とは呼びません。
プロセスがどのステップにあるかを記録することは重要ですが、それはあくまで実行パスの追跡に過ぎません。
さらに、「トランザクションの整合性」も記憶の本質ではありません。
データの一貫性を保つことは不可欠ですが、それはエージェントが自らの過去の判断を振り返る能力とは別物です。
真の記憶とは、過去のインタラクションから文脈を抽出し、現在の意思決定に反映させる能力を指します。
「真の記憶」を構成する5つの重要要素
エージェントの記憶を設計する際には、単なるデータの永続化以上の考慮が必要です。
以下の表に、記憶システムが備えるべき5つの機能をまとめました。
| 要素名 | 役割 | 欠如した場合のリスク |
|---|---|---|
| 永続性 (Persistence) | セッション終了後も履歴をデータベースに保持する | 会話が毎回リセットされ、ユーザーの信頼を失う |
| 選択 (Selection) | 膨大な履歴から何が記憶に値するかを判断する | 情報のノイズが増え、推論の精度が低下する |
| 圧縮 (Compression) | 生の履歴を構造化された事実や要約に変換する | コンテキスト窓を圧迫し、実行コストが肥大化する |
| 減衰と忘却 (Decay & Forgetting) | 時間の経過とともに古い情報の重要度を下げる | 古い情報と新しい情報が混在し、誤った判断を下す |
| 汚染防止 (Contamination Prevention) | 誤った事実や矛盾した情報を修正・排除する | 一度信じ込んだ誤情報を永久に参照し続ける |
これら5つの要素が組み合わさることで、エージェントは初めて人間のように柔軟な記憶の運用が可能になります。
1. 永続性と選択:情報の価値を見極める
すべてのトークンを保存することは可能ですが、それは賢明な戦略ではありません。
ストレージコストの問題だけでなく、情報の密度が希釈されることで、検索精度(Recall)が低下するためです。
エージェントは、対話の中から「ユーザーの好み」「確定した約束」「重要なイベント」を能動的に選択して保存する必要があります。
2. 圧縮と減衰:効率的なリコールを実現する
数時間に及ぶ会話をそのままコンテキストに注入すると、LLMの推論能力は低下します。
そのため、会話を構造化されたファクト(事実)へと圧縮するプロセスが不可欠です。
また、人間の記憶と同じように、古い情報は次第に重みを失うべきです。
昨日受けた「急ぎの依頼」は、1ヶ月後にはもはや重要ではない可能性が高いからです。
記憶のタクソノミー(分類学)
認知科学の知見を応用すると、AIエージェントの記憶は以下の4つの階層に分類できます。
ワーキングメモリ (Working Memory)
現在のコンテキスト窓に含まれる情報のことで、極めて一時的な記憶です。
現在のタスクや、直前のやり取りがここに含まれます。
エピソード記憶 (Episodic Memory)
「いつ、誰が、何をしたか」という特定の出来事に関する記憶です。
トラブル対応の履歴や、過去の特定のセッション内容が該当します。
意味記憶 (Semantic Memory)
出来事から抽出された「知識」や「概念」に関する記憶です。
「このユーザーは常に朝の便を好む」といった、一般化された事実がこれにあたります。
手続き記憶 (Procedural Memory)
「どのように処理を行うか」というスキルや手順に関する記憶です。
特定のアクションに対して、どのツールをどの順序で使うのが最適だったかという経験則が含まれます。
実運用におけるデータベースの課題
多くの開発チームは、記憶の保存先としてRedisやベクトルデータベースを最初に検討します。
しかし、単一パターンのデータストアだけでは、複雑な記憶の振る舞いを支えることは困難です。
Key-Valueストアは高速ですが、「過去30日間に地域Aで成功した返金処理」といった構造的なクエリには向きません。
一方で、純粋なベクトル検索は「意味の近さ」を捉えますが、「特定のユーザーID」や「正確なタイムスタンプ」によるフィルタリングが苦手な場合があります。
また、情報の修正(汚染防止)が必要な場合、ベクトルインデックスの再構築はコストが高く、リアルタイム性に欠けるという課題もあります。
実機実装:ハイブリッド記憶スキーマの設計
真の記憶システムには、リレーショナルな検索とベクトル検索、そして情報の「確信度」を管理する機能が必要です。
以下に、エピソード記憶と意味記憶を統合管理するためのSQLスキーマの例を示します。
-- エピソード記憶:何が起きたかを記録し、結果を追跡する
CREATE TABLE episodic_memory (
  id           BIGINT PRIMARY KEY AUTO_INCREMENT,
  agent_id     VARCHAR(64) NOT NULL,
  user_id      BIGINT NOT NULL,
  summary      TEXT,           -- 圧縮された要約
  raw_payload  JSON,           -- 監査用の生データ
  outcome      ENUM('success','failure','pending'), -- 結果のステータス
  confidence   FLOAT DEFAULT 1.0, -- 記憶の確信度
  superseded_by BIGINT NULL,   -- 汚染修正用のポインタ
  created_at   DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP,
  embedding    VECTOR(1536),   -- ベクトル検索用の埋め込み
  INDEX idx_user_time (user_id, created_at),
  INDEX idx_embedding USING HNSW (embedding) -- 高速なベクトル検索
);

-- 意味記憶:抽出された知識を管理する
CREATE TABLE semantic_memory (
  id           BIGINT PRIMARY KEY AUTO_INCREMENT,
  fact         TEXT NOT NULL,  -- 抽出された事実
  source_count INT DEFAULT 1,  -- 何回確認されたか
  last_confirmed_at DATETIME NOT NULL,
  contradicted_at   DATETIME NULL, -- 矛盾が判明した日時
  embedding    VECTOR(1536),
  INDEX idx_embedding USING HNSW (embedding)
);このスキーマのポイントは、confidence(確信度)とsuperseded_by(上書きポインタ)を持っている点です。
記憶は不変ではなく、新しい情報によって修正されたり、信頼性が低下したりすることを前提に設計されています。
情報の減衰を考慮したクエリ
記憶を呼び出す際、単に「似ているもの」を探すのではなく、時間の経過による減衰を計算に加えます。
-- 意味記憶の検索:確信度と時間の減衰を考慮する
SELECT fact,
       -- 指数関数的な減衰(半減期を約60日に設定)
       confidence * EXP(-DATEDIFF(NOW(), last_confirmed_at) / 90.0) AS effective_weight
FROM semantic_memory
WHERE contradicted_at IS NULL -- 矛盾した情報を排除
  AND VEC_COSINE_DISTANCE(embedding, @task_vec) < 0.3 -- 関連性の高い情報を抽出
ORDER BY effective_weight DESC
LIMIT 5;| fact | effective_weight |
|-----------------------------------|------------------|
| ユーザーは午前中の会議を優先する | 0.925 |
| 支払い通貨は常に日本円(JPY) | 0.881 |
| 前回の返金リクエストは承認済み | 0.450 |このように、データベースレベルで記憶の重み付け演算を行うことが、効率的なエージェント構築の鍵となります。
同時実行制御とデータの一貫性
エージェントが自律的に記憶を更新する場合、複数のプロセスが同時に同じ記憶を書き換えようとする可能性があります。
ここで重要になるのが、「楽観的ロック」と「悲観的ロック」の使い分けです。
人間によるレビューや重要な設定更新には、対象をロックする悲観的制御が適しています。
一方で、バックグラウンドで行われる大量の要約処理などには、バージョン管理を用いた楽観的制御が効率的です。
データベースがこれらのACID特性を備えた分散SQLであることは、エージェントの規模が拡大した際に決定的な差となります。
まとめ
AIエージェントの記憶を実装することは、単にデータを保存する場所を選ぶことではありません。
「何を保存し、何を要約し、何を忘れるか」という一連のライフサイクルを設計することこそが、本質的な記憶の実装です。
永続的なストレージはあくまで基盤であり、その上で動くインテリジェントなクエリと管理戦略が、エージェントに魂を吹き込みます。
今後、エージェントがより複雑な業務を担うようになるにつれ、エピソード記憶や意味記憶を高度に処理できる「記憶基盤」の重要性はさらに高まっていくでしょう。
開発者は、単なるキャッシュやベクトルDBの枠を超え、認知科学の視点を取り入れた包括的な記憶システムの構築を目指すべきです。