
C言語を用いてソフトウェアを開発する際、多くのエンジニアが直面する大きな壁の一つが「文字コードの取り扱い」です。
日本語のようなマルチバイト文字を扱う場合、ASCII文字とは異なり、1文字が複数のバイトで構成されるため、単純なポインタ演算だけでは意図した結果が得られません。
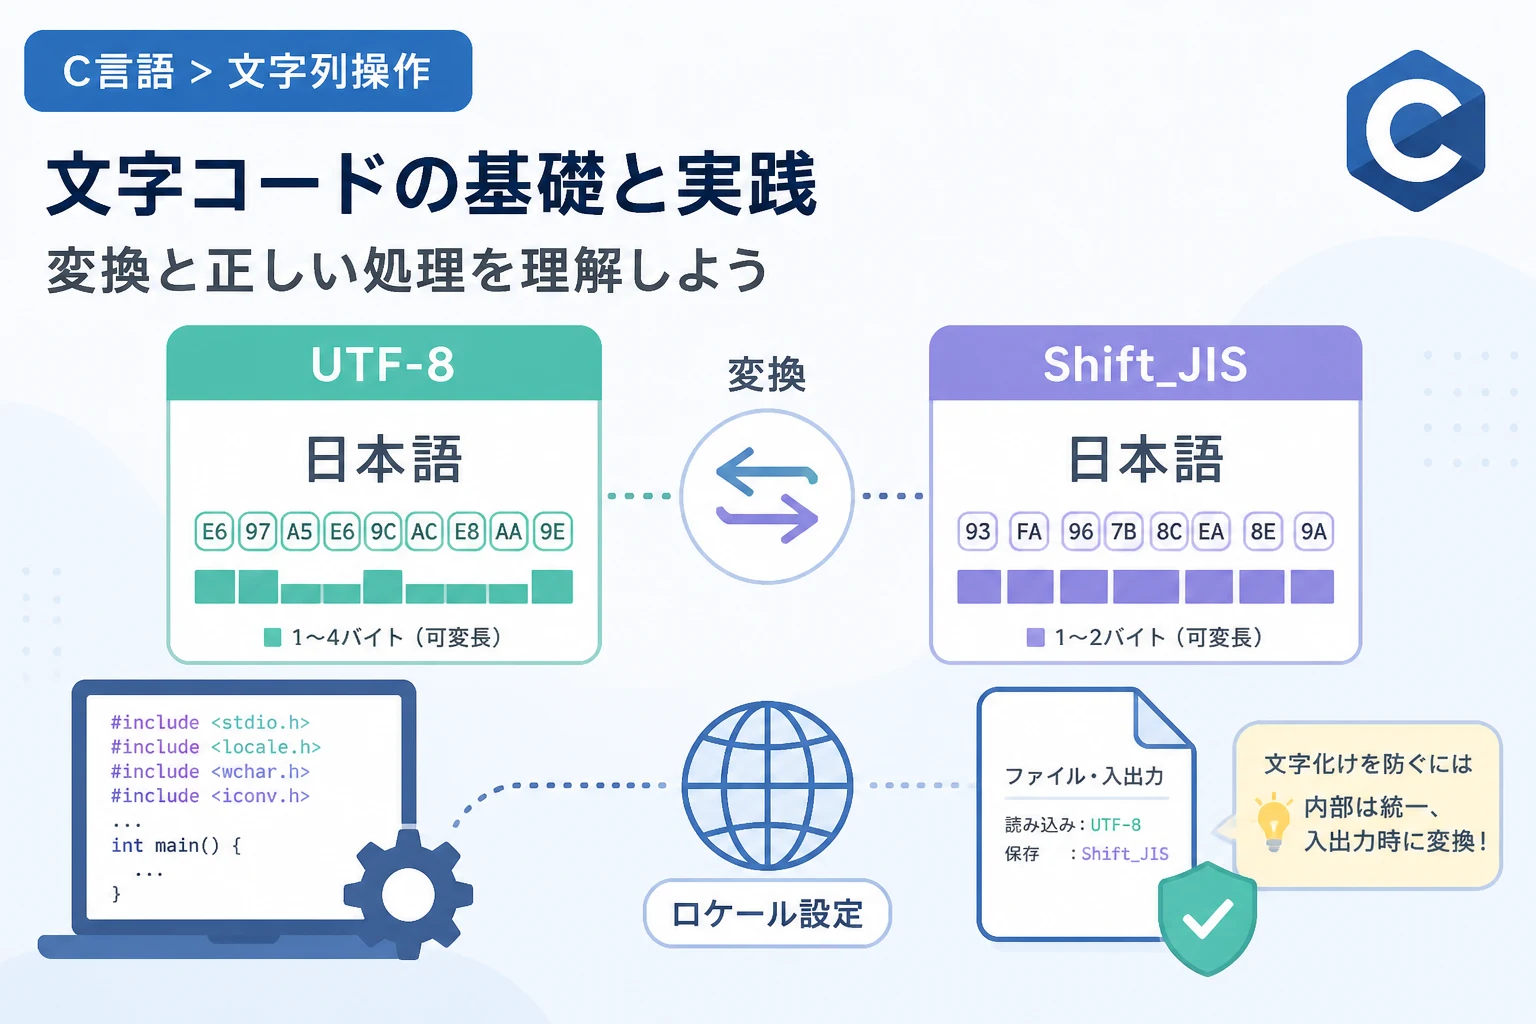
特に、歴史的な背景からWindows環境で広く使われてきたShift_JISと、現代の標準であるUTF-8の混在は、文字化けやプログラムの異常終了を引き起こす要因となります。
本記事では、C言語における文字コードの基礎知識から、主要な文字コード間の変換方法、そして実践的な処理手法までを詳しく解説します。
C言語における文字コードの基礎概念
C言語における文字の最小単位はchar型ですが、これは本来「8ビット(1バイト)」の整数を保持するための型です。
英語圏の文字であればASCIIコードで1バイトに収まりますが、日本語の「あ」や「漢」といった文字は、1バイトでは表現しきれません。
この問題を解決するために、C言語では「マルチバイト文字列」と「ワイド文字列」という2つのアプローチが用意されています。
マルチバイト文字列とワイド文字列の違い
マルチバイト文字列は、1文字を1バイトから数バイトの可変長で表現する形式であり、UTF-8やShift_JISがこれに該当します。
一方、ワイド文字列は、すべての文字を固定長(通常は2バイトまたは4バイト)のwchar_t型で表現する形式です。
マルチバイト文字列はメモリ効率が良い反面、特定の文字を探したり、文字数をカウントしたりする処理が複雑になります。
対してワイド文字列は、配列のインデックスがそのまま文字の位置に対応するため処理が容易ですが、使用するメモリ量が増加します。
| 特徴 | マルチバイト文字列 (char[]) | ワイド文字列 (wchar_t[]) |
|---|---|---|
| データ型 | char | wchar_t |
| 文字長 | 可変長 (1〜4バイト) | 固定長 (2または4バイト) |
| 主な符号化方式 | UTF-8, Shift_JIS, EUC-JP | UTF-16, UTF-32 |
| メモリ消費 | 少ない | 多い |
ロケール(Locale)の重要性
C言語の標準ライブラリで日本語を正しく扱うためには、「ロケール」の設定が不可欠です。
ロケールとは、言語や国・地域ごとの文化規則を定義したもので、文字コードの解釈もこれに含まれます。
プログラムの開始直後にsetlocale(LC_ALL, "");を実行することで、OSのデフォルト設定に従った文字処理が可能になります。
UTF-8とShift_JISの特徴と違い
現代の開発において最も頻繁に扱うのがUTF-8とShift_JISです。
これら2つの文字コードは内部構造が大きく異なるため、その特性を理解しておくことが重要です。
UTF-8(Unicode Transformation Format – 8bit)
UTF-8は世界的に標準化されているUnicodeの符号化方式の一つであり、インターネット上のコンテンツの大部分で採用されています。
1文字を1バイトから4バイトで表現し、ASCII文字(半角英数字)を1バイトで表現できるため、既存のC言語のライブラリと親和性が高いのが特徴です。
また、「エンディアン(バイト順)」を気にする必要がないという大きなメリットがあります。
Shift_JIS(SJIS)
Shift_JISは日本独自の文字コードであり、主にWindowsの日本語版環境(CP932)で長く使われてきました。
1文字を1バイトまたは2バイトで表現しますが、2バイト目の中に「\(バックスラッシュ/円記号)」と同じ値を持つ文字が含まれる「ダメ文字問題」が存在します。
この問題により、プログラム内でエスケープ文字として誤認され、予期せぬ挙動を引き起こすことがあります。
標準ライブラリによる文字変換の実装
C言語の標準ヘッダである<stdlib.h>や<wchar.h>には、マルチバイト文字とワイド文字を変換するための関数が用意されています。
mbstowcs関数によるマルチバイトからワイド文字への変換
mbstowcs(multibyte string to wide character string)関数を使用すると、現在のロケールに基づいた変換が行えます。
#include <stdio.h>
#include <stdlib.h>
#include <locale.h>

int main() {
    // ロケールをシステムのデフォルトに設定
    setlocale(LC_ALL, "");

    const char *mb_str = "こんにちは"; // マルチバイト文字列
    wchar_t wc_str[20];

    // マルチバイト文字列をワイド文字列に変換
    size_t len = mbstowcs(wc_str, mb_str, 20);

    if (len == (size_t)-1) {
        perror("変換失敗");
        return 1;
    }

    printf("変換後のワイド文字列の文字数: %zu\n", len);
    // ワイド文字の出力には wprintf を使用
    wprintf(L"ワイド文字列の内容: %ls\n", wc_str);

    return 0;
}変換後のワイド文字列の文字数: 5
ワイド文字列の内容: こんにちはwcstombs関数によるワイド文字からマルチバイトへの変換
逆に、内部処理で加工したワイド文字列を外部に出力(ファイル保存など)する際は、wcstombs関数を使用してマルチバイト文字列に戻します。
この際もロケール設定が適切でないと、正しい変換結果が得られないため注意が必要です。
iconvライブラリを使用した高度な変換
標準ライブラリの変換関数は、現在のロケールに依存するため、「UTF-8からShift_JISへ直接変換する」といった柔軟な処理には向きません。
そこで、UNIX系システムやマルチプラットフォーム開発で広く利用されているiconvライブラリを使用する方法が推奨されます。
iconvによる変換の実装例
以下のコードは、UTF-8の文字列をShift_JISに変換する関数の例です。
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <iconv.h>

int convert_encoding(const char *src, char *dest, size_t dest_size, const char *from_enc, const char *to_enc) {
    iconv_t cd = iconv_open(to_enc, from_enc);
    if (cd == (iconv_t)-1) {
        perror("iconv_open");
        return -1;
    }

    size_t in_bytes = strlen(src);
    size_t out_bytes = dest_size - 1;
    char *in_buf = (char *)src;
    char *out_buf = dest;

    if (iconv(cd, &in_buf, &in_bytes, &out_buf, &out_bytes) == (size_t)-1) {
        perror("iconv");
        iconv_close(cd);
        return -1;
    }

    *out_buf = '\0'; // 終端文字を付加
    iconv_close(cd);
    return 0;
}

int main() {
    const char *utf8_text = "C言語プログラミング";
    char sjis_buffer[256];

    if (convert_encoding(utf8_text, sjis_buffer, sizeof(sjis_buffer), "UTF-8", "SHIFT_JIS") == 0) {
        printf("変換に成功しました。\n");
    }

    return 0;
}iconv_openで変換ハンドルを作成し、iconv関数で実際の変換処理を行い、最後にiconv_closeでリソースを解放するという流れになります。
この方法は、OSのロケール設定に縛られずに、多様な文字コードを相互変換できるため非常に強力です。
Windows環境における変換(APIの利用)
Windows環境での開発においては、標準ライブラリやiconvの代わりに、Windows APIであるMultiByteToWideCharおよびWideCharToMultiByteがよく使われます。
Windowsの内部処理は歴史的にUTF-16(ワイド文字)に基づいているため、一度ワイド文字を経由させることで、精度の高い変換が可能になります。
MultiByteToWideChar関数の活用
MultiByteToWideCharの第一引数にコードページ(CP_UTF8や932など)を指定することで、入力文字列の形式を明示できます。
これにより、Shift_JISで書かれた古いファイルを読み込み、内部的にUTF-8で処理するといったフローが実現できます。
文字コード処理における注意点とトラブルシューティング
文字コードの実装においては、いくつかの典型的なミスが発生しやすいポイントがあります。
バッファサイズの不足
マルチバイト文字は1文字あたりのバイト数が変動するため、変換後の文字列が元のサイズより大きくなることがあります。
特にUTF-8からShift_JIS、あるいはその逆の変換を行う際は、「変換後の最大バイト数」を考慮した余裕のあるメモリ確保が必須です。
BOM(Byte Order Mark)の存在
UTF-8のファイルには、冒頭に3バイトのBOM(EF BB BF)が付与されていることがあります。
C言語で単純にファイルを読み込むと、このBOMが文字列の一部として扱われ、比較処理などで不一致の原因となります。
ファイルを読み込む際は、冒頭の数バイトをチェックし、BOMが存在する場合はスキップする処理を入れるのが一般的です。
ヌル終端の扱い
C言語の文字列は必ずヌル文字(\0)で終わる必要がありますが、変換関数の中には自動的にヌル終端を付与しないものもあります。
変換関数の戻り値を確認し、必要に応じて手動で\0を書き込むことを忘れないようにしてください。
C11規格以降の新しい文字型
2011年に策定されたC11規格では、文字コードの扱いをより厳密にするために新しい型が導入されました。
char16_t:UTF-16エンコーディングされた文字を保持するための型char32_t:UTF-32エンコーディングされた文字を保持するための型
これらを使用するには<uchar.h>をインクルードします。
これにより、wchar_tのサイズがOS(Windowsでは2バイト、Linuxでは4バイト)によって異なるという問題に依存せず、プラットフォーム間で一貫したコードを記述しやすくなりました。
#include <uchar.h>
#include <stdio.h>

int main() {
    // uプレフィックスでUTF-16定数を定義
    char16_t utf16_char = u'あ';
    // UプレフィックスでUTF-32定数を定義
    char32_t utf32_char = U'あ';

    printf("C11の新しい型を用いた処理の準備が整っています。\n");
    return 0;
}
実用的な文字列処理の実装テクニック
実際にC言語でアプリケーションを構築する際、どのように文字列を扱うべきかの指針をまとめます。
内部処理は統一する
プログラム内部で使用する文字コードは、UTF-8またはワイド文字のどちらか一方に統一すべきです。
各関数ごとに文字コードがバラバラだと、変換処理が散在し、バグの温床となります。
「入力時に内部形式へ変換し、出力時に外部形式へ変換する」という設計思想(サンドイッチ構造)が最も安全です。
外部ライブラリの検討
もし大規模な文字列操作や高度な多言語対応が必要な場合は、自前で実装するよりも、ICU (International Components for Unicode)のような実績のあるライブラリを利用することを検討してください。
ICUは非常に強力で、正規化や複雑な比較、日付・通貨のフォーマットなどもサポートしています。
まとめ
C言語における文字コードの扱いは、他のモダンなプログラミング言語と比較して、低レイヤーの理解が強く求められます。
単なるバイト配列として文字列を扱うのではなく、それがどのような符号化方式で構成されているのかを常に意識する必要があります。
今回解説したsetlocaleによる設定、mbstowcsなどの標準関数、そしてiconvを用いた柔軟な変換手法をマスターすることで、文字化けに強い堅牢なプログラムを作成できるようになります。
UTF-8が主流となっている現代においても、Shift_JISなどのレガシーな文字コードを扱う場面は少なくありません。
適切な変換知識を身につけ、環境に左右されない柔軟な実装を目指しましょう。