
Go言語においてstring型は、日常的なプログラミングで最も頻繁に利用されるデータ型の一つです。
バックエンド開発やクラウドネイティブなアプリケーションの構築において、文字列処理の効率はシステム全体のパフォーマンスに直結します。
Goのstring型は非常にシンプルに設計されていますが、その内部構造やメモリ管理の仕組みを理解することで、より高速で安全なコードを書くことが可能になります。
本記事では、string型の基本操作から、2026年現在の開発現場で求められるパフォーマンス最適化のテクニックまでを詳しく解説します。
Goにおけるstring型の基礎知識と内部構造
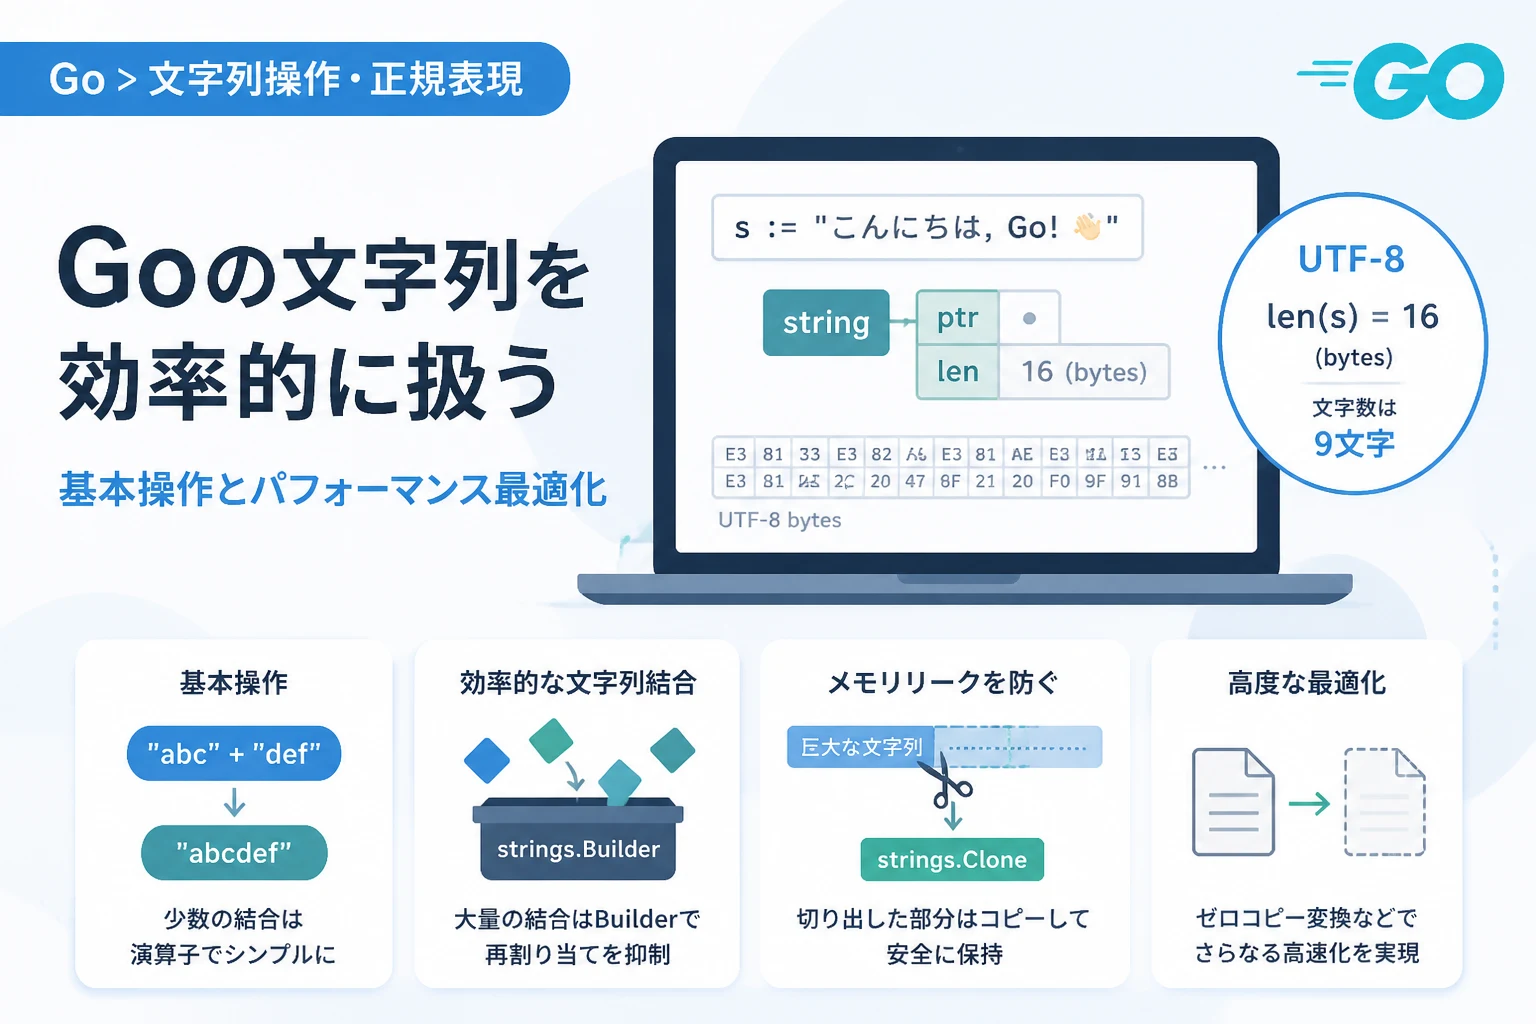
Go言語のstring型は、読み取り専用のバイトスライスとして実装されています。
内部的には、データの実体を示すポインタと、その長さを管理する整数値の2つのフィールドを持つ構造体のような形式で管理されています。
この構造を理解することは、Goにおける効率的なメモリ操作を学ぶ上での第一歩となります。
string型の不変性(イミュータブル)
Goの文字列は一度作成されると、その内容を直接書き換えることはできません。
例えば、文字列の特定のインデックスにある文字を直接変更しようとすると、コンパイルエラーが発生します。
この不変性という性質により、複数のゴルーチン間で文字列を共有しても競合状態が発生せず、安全にデータを扱うことができます。
一方で、文字列の一部を変更したい場合は、新しくメモリを割り当てて別の文字列を作成する必要があるため、頻繁な更新には注意が必要です。
UTF-8エンコーディングの採用
Goのソースコードは常にUTF-8として解釈され、string型のリテラルも同様にUTF-8でエンコードされたバイト列として保持されます。
これにより、日本語のようなマルチバイト文字も特別な設定なしに扱うことが可能です。
ただし、string型をインデックスで操作する場合、それは「文字」ではなく「バイト」を指しているという点に注意しなければなりません。
基本的な文字列操作と構文
Go言語で文字列を扱うための基本的な構文と、標準的な操作方法を確認していきましょう。
文字列の宣言と初期化
文字列の宣言には、ダブルクォート " またはバッククォート ` を使用します。
package main

import "fmt"

func main() {
    // 通常の文字列リテラル
    var s1 string = "Hello, Go!"

    // 生文字リテラル(改行や特殊文字をそのまま保持)
    s2 := `これは
複数行の
文字列です`

    fmt.Println(s1)
    fmt.Println(s2)
}Hello, Go!
これは
複数行の
文字列です文字列の長さとバイト数
組み込み関数の len() を使用すると、文字列のバイト数を取得できます。
ここで重要なのは、len()が返す値は「文字数」ではなく「バイト数」であるという点です。
package main

import (
    "fmt"
    "unicode/utf8"
)

func main() {
    s := "Go言語"

    // バイト数を表示
    fmt.Printf("バイト数: %d\n", len(s))

    // 実際の文字数(ルーン数)を表示
    fmt.Printf("文字数: %d\n", utf8.RuneCountInString(s))
}バイト数: 8
文字数: 4「Go言語」という文字列は、半角英字が1バイト×2、日本語(UTF-8)が3バイト×2の合計8バイトとしてカウントされます。
文字数を正しくカウントしたい場合は、unicode/utf8 パッケージの RuneCountInString 関数を使用しましょう。
実践的な文字列の結合と編集
実務的なアプリケーション開発では、複数の文字列を組み合わせたり、動的にメッセージを生成したりする場面が多く存在します。
プラス演算子による結合
最も簡単な結合方法は + 演算子を使用することです。
少数の文字列を結合する場合、この方法は直感的で可読性にも優れています。
str := "Hello" + " " + "World"しかし、ループ内などで大量の文字列を結合する場合、プラス演算子を使用するとパフォーマンスが劇的に低下します。
なぜなら、文字列は不変であるため、結合のたびに新しいメモリ領域が確保され、既存のデータがコピーされるからです。
fmt.Sprintfによる整形
複雑な変数を埋め込んだ文字列を作成する場合は、fmt.Sprintf が便利です。
name := "Gopher"
age := 10
s := fmt.Sprintf("Name: %s, Age: %d", name, age)
非常に柔軟なフォーマットが可能ですが、内部でリフレクション(型解析)を使用するため、実行速度は他の方法に比べて低速になる傾向があります。
パフォーマンスを最大化するstrings.Builderの活用
大量の文字列結合が必要なシナリオでは、strings.Builderを使用するのが現在のGoにおけるベストプラクティスです。
strings.Builder は内部的に可変のバイトスライスを持ち、メモリの再割り当てを最小限に抑えながら文字列を構築します。
strings.Builderの基本的な使い方
以下の例では、多数の文字列を効率的に結合しています。
package main

import (
    "strings"
    "fmt"
)

func main() {
    var builder strings.Builder

    // 事前に必要な容量を確保(最適化)
    builder.Grow(100)

    for i := 0; i < 10; i++ {
        builder.WriteString("Go ")
    }

    result := builder.String()
    fmt.Println(result)
}Go Go Go Go Go Go Go Go Go GoGrow メソッドを使用してあらかじめ必要なメモリサイズを指定しておくことで、結合中のメモリ再割り当て回数をゼロにすることができます。
これにより、大規模なテキスト生成処理においても極めて高いパフォーマンスを発揮します。
rune型とマルチバイト文字の適切な処理
Goにおいて「文字」を個別に扱いたい場合、rune 型の理解が欠かせません。
rune は int32 のエイリアスであり、1つのUnicodeコードポイントを表します。
rangeループによる文字の抽出
文字列を for range でループ処理すると、各要素はバイトではなく rune として抽出されます。
package main

import "fmt"

func main() {
    s := "Goプログラミング"
    for i, r := range s {
        fmt.Printf("Index: %d, Char: %c\n", i, r)
    }
}Index: 0, Char: G
Index: 1, Char: o
Index: 2, Char: プ
Index: 5, Char: ロ
Index: 8, Char: グ
Index: 11, Char: ラ
Index: 14, Char: ミ
Index: 17, Char: ン
Index: 20, Char: グ出力結果を見るとわかるように、日本語(3バイト文字)の後のインデックスが3ずつ増加しています。
このように、Goの range ループはマルチバイト文字の境界を正しく認識して処理してくれます。
文字列とバイトスライスの相互変換と最適化
ネットワーク通信やファイルI/Oでは、文字列(string)とバイトスライス([]byte)の相互変換が頻繁に発生します。
標準的な変換方法
最も安全で一般的な変換は、キャストを使用する方法です。
s := "Hello"
b := []byte(s) // string to []byte
s2 := string(b) // []byte to string
このキャスト操作を行うと、データのコピーが発生します。
不変であるstringと可変である[]byteの間でデータの整合性を保つため、このコピーは言語仕様上必要なものです。
Go 1.20以降のゼロコピー変換テクニック
パフォーマンスが極めて重要なシステムでは、コピーを避けて変換を行いたい場合があります。
Go 1.20からは、unsafe パッケージを使用せずに(あるいは安全に)ゼロコピーで変換するためのAPIが整備されました。
package main

import (
    "fmt"
    "unsafe"
)

func main() {
    b := []byte("Hot Data")

    // []byteをstringに変換(コピーが発生しない)
    s := unsafe.String(&b[0], len(b))

    fmt.Println(s)
}
ただし、この方法で変換された文字列の背後にあるバイトスライスを変更すると、文字列の不変性が壊れるため、使用には細心の注意が必要です。
基本的には標準のキャストを使用し、プロファイリングによって変換がボトルネックになっていることが証明された場合のみ、このような最適化を検討してください。
文字列操作の効率化に役立つ標準パッケージ
Goには、文字列処理を支援する強力な標準ライブラリが備わっています。
stringsパッケージの活用
strings パッケージには、検索、置換、分割などの便利な関数が揃っています。
| 関数名 | 用途 |
|---|---|
strings.Contains | 特定の文字列が含まれているか判定する |
strings.Split | 区切り文字で分割してスライスを返す |
strings.ReplaceAll | 一致する全ての部分を置換する |
strings.HasPrefix | 接頭辞が一致するか判定する |
strconvパッケージによる型変換
数値と文字列の相互変換には strconv パッケージを使用します。
// 数値を文字列へ
s := strconv.Itoa(123)

// 文字列を数値へ
i, err := strconv.Atoi("456")
fmt.Sprintf でも数値の文字列化は可能ですが、strconv の方が特化しているため高速に動作します。
文字列操作で陥りやすい罠とメモリリークの防止
Goの文字列は便利な一方で、メモリ管理上の注意点がいくつか存在します。
大規模な文字列からのサブスライス作成
巨大な文字列から一部を切り出して保持する場合、思わぬメモリの持ち回りが発生することがあります。
var smallString string

func sliceHugeString() {
    hugeString := "とても大きなデータ...(数GB)"
    // 最初の10バイトだけを保持したい
    smallString = hugeString[:10]
}このコードを実行すると、smallString は hugeString のメモリ領域を参照し続けます。
たとえ hugeString 自体がスコープを外れても、一部が参照されている限り、数GBのメモリ全体がガベージコレクション(GC)の対象になりません。
これを防ぐためには、新しく文字列をコピーして作成する strings.Clone 関数(Go 1.18以降)を使用するのが効果的です。
smallString = strings.Clone(hugeString[:10])文字列比較のコスト
文字列の比較 == は、まずポインタと長さが同じかどうかをチェックし、異なる場合は内容を順に比較します。
非常に長い文字列同士を頻繁に比較する処理は、CPU負荷を高める要因となります。
ハッシュ値を計算して比較する、あるいは比較の頻度を下げる設計にするなどの工夫が、大規模システムでは求められます。
まとめ
Go言語のstring型は、不変性という強力な特性を持つことで、安全かつシンプルな文字列操作を実現しています。
一方で、その内部構造や「バイトの集まり」であるという性質を正しく理解していないと、マルチバイト文字の扱いやパフォーマンス面で思わぬ不具合を招く可能性があります。
基本的には + 演算子や fmt.Sprintf で十分ですが、高負荷な処理や大量のデータ結合を行う場合には strings.Builder の活用を常に意識しましょう。
また、2026年現在のモダンな開発においては、unsafe パッケージを用いたゼロコピー変換や、strings.Clone によるメモリ管理の最適化も重要なテクニックとなっています。
本記事で紹介したテクニックを駆使して、クリーンで効率的なGoプログラムを記述してください。