Pythonでプログラミングを行う際、文字列の長さを取得する操作は非常に頻繁に発生します。
ユーザーからの入力値を検証したり、データを整形して表示したりする場合に、文字数の把握は欠かせない要素となります。
Pythonには標準で文字列の長さを取得するための便利な関数やメソッドが用意されており、初心者でも簡単に扱うことができます。
しかし、日本語などのマルチバイト文字や絵文字、あるいはバイト単位での長さを扱う場合には、いくつかの注意点が存在します。
本記事では、Pythonで文字列の長さを取得する基本であるlen()関数の使い方から、実務で役立つ応用的なカウント方法までを網羅的に解説します。
Pythonのlen関数で文字列の長さを取得する基本
Pythonにおいて文字列の長さを取得する最も標準的な方法は、組み込み関数であるlen()を使用することです。
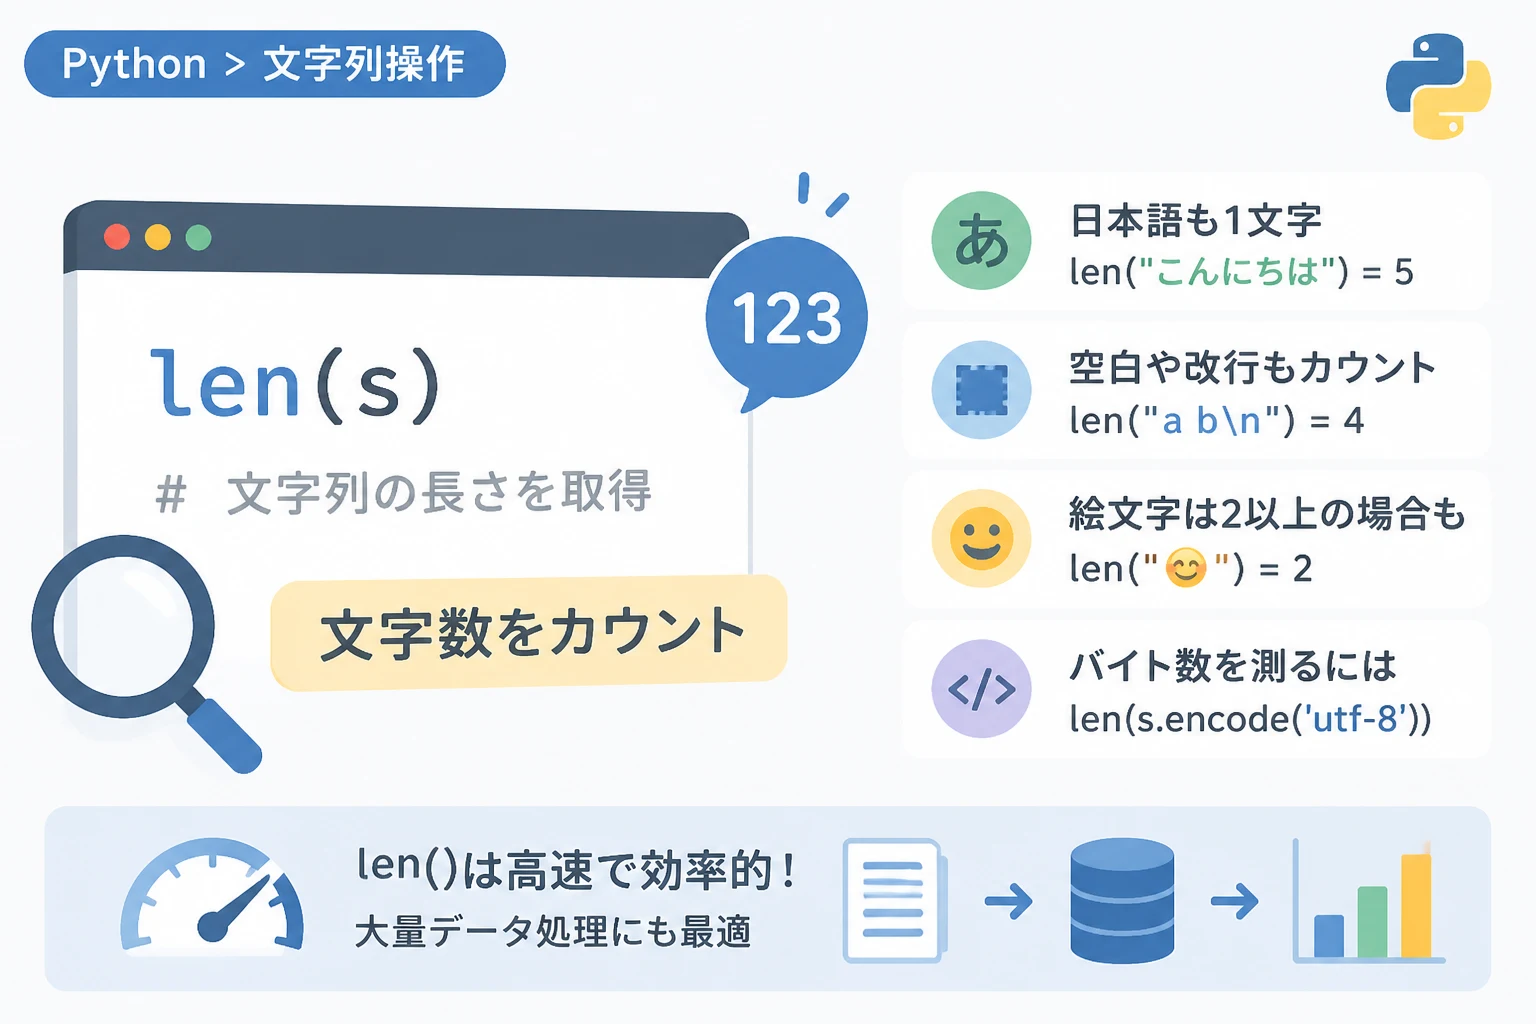
len()関数は、引数に指定したオブジェクトの要素数を返す関数であり、文字列を渡した場合にはその「文字数」を返します。
len関数の基本的な構文
len()関数の使い方は非常にシンプルで、括弧の中に長さを調べたい文字列を記述するだけです。
# 文字列を定義します
sample_text = "Python"

# len関数を使って長さを取得します
length = len(sample_text)

# 結果を表示します
print(length)6このように、半角英数字であれば1文字を1として正確にカウントします。
空文字やスペースを含む場合の挙動
len()関数は、空白(スペース)や特殊な文字も1文字としてカウントするという点に注意が必要です。
何も文字が入っていない空文字列 "" の場合、結果は 0 となります。
# 半角スペースを含む文字列
space_text = "Hello World"
print(f"スペースあり: {len(space_text)}")

# 空文字列
empty_text = ""
print(f"空文字: {len(empty_text)}")スペースあり: 11
空文字: 0「Hello World」の場合、英単語の間のスペースも1文字として数えられていることがわかります。
日本語(マルチバイト文字)の文字数カウント
Python 3では文字列はすべてUnicodeとして扱われるため、日本語の全角文字も1文字として正しくカウントされます。
かつてのプログラミング言語では全角文字を2文字分として扱うこともありましたが、Pythonのlen()関数では直感的な文字数が得られます。
全角文字のカウント例
ひらがな、カタカナ、漢字が混じった文字列でも、見たままの文字数が返ってきます。
# 日本語の文字列を定義
jp_text = "プログラミング学習"

# 文字数を取得
print(len(jp_text))9この結果から、日本語の各文字が適切に1文字として評価されていることが確認できます。
バイト数で長さを取得する方法
ネットワーク通信やファイル保存など、システム上の制約で「文字数」ではなく「バイト数」を知る必要があるケースがあります。
バイト数を取得するには、文字列を一度encode()メソッドでバイト列に変換してからlen()関数を適用します。
# UTF-8でエンコードした場合のバイト数を取得
text = "こんにちは"
byte_data = text.encode("utf-8")

print(f"文字数: {len(text)}")
print(f"バイト数(UTF-8): {len(byte_data)}")文字数: 5
バイト数(UTF-8): 15UTF-8エンコーディングでは、一般的な日本語1文字は3バイトとして計算されるため、5文字で15バイトという結果になります。
Shift-JISなど別のエンコーディングを指定すれば、その形式に応じたバイト数が取得可能です。
特定の文字の出現回数をカウントする応用
文字列全体の長さではなく、特定の文字が何回現れるかを知りたい場合にはcount()メソッドを使用します。
これは、特定のキーワードの出現頻度を調べたり、データのフォーマットを確認したりする際に便利です。
count()メソッドの基本
文字列.count("検索したい文字") という形式で記述します。
target_string = "apple orange banana apple"

# "apple" がいくつ含まれているかカウント
apple_count = target_string.count("apple")

print(f"appleの個数: {apple_count}")appleの個数: 2このメソッドは、重なり合う部分についてはカウントしないという性質があるため注意してください。
範囲を指定したカウント
count()メソッドには、検索を開始する位置と終了する位置を指定するオプション引数があります。
text = "abcabcabc"

# インデックス3から最後までの中で "a" を探す
print(text.count("a", 3))2このように、文字列の一部だけを対象にして出現回数を調べることが可能です。
絵文字や特殊な文字を扱う際の注意点
現代のアプリケーション開発では、絵文字の扱いに細心の注意を払う必要があります。
一見1文字に見える絵文字でも、内部的な構造によってはlen()関数が「1」を返さない場合があるからです。
サロゲートペアとlen関数
一部の特殊な漢字や古い絵文字は、内部的に2つのコードポイントを組み合わせて表現される「サロゲートペア」として構成されています。
しかし、Python 3の内部実装(Unicode型)ではこれらを適切に処理するため、基本的には問題になりません。
# 特殊な漢字(𠮷:つちよし)
special_kanji = "𠮷"
print(len(special_kanji))1結合文字と絵文字の複雑さ
一方で、肌の色を指定した絵文字や、複数の絵文字を組み合わせて1つのキャラクターに見せているもの(ZWJ結合)は注意が必要です。
これらは「見た目の文字数」は1つですが、コンピュータ上では複数の文字が連結されている状態です。
# 家族の絵文字(複数の人間と結合文字で構成される場合がある)
emoji_family = "👨👩👧"
print(f"見た目は1つだがlenの結果は: {len(emoji_family)}")見た目は1つだがlenの結果は: 5もし「人間の目に映る文字数」を正確にカウントしたい場合は、標準ライブラリのunicodedataを駆使するか、外部ライブラリのgraphemeなどを導入する必要があります。
実務で使える文字列長操作のテクニック
実際の開発現場では、単純にlen()を呼び出すだけでなく、前処理を組み合わせて長さを測ることが多いです。
空白や改行を除外してカウントする
ユーザーが入力したテキストの有効な文字数だけを数えたい場合、strip()やreplace()を併用します。
user_input = "  Pythonプログラミング  \n"

# 前後の空白と改行を削除してからカウント
trimmed_len = len(user_input.strip())

# すべての空白を削除してカウント
no_space_len = len(user_input.replace(" ", "").replace(" ", "").strip())

print(f"元の長さ: {len(user_input)}")
print(f"トリム後: {trimmed_len}")
print(f"空白完全除去: {no_space_len}")元の長さ: 21
トリム後: 14
空白完全除去: 14このように、目的に応じて「何をもって1文字とするか」を定義することが重要です。
文字列制限のバリデーション実装
入力フォームなどで「100文字以内」といった制限を設ける場合、len()の結果をもとに条件分岐を行います。
def validate_length(text, max_len):
    if len(text) > max_len:
        return False
    return True

comment = "これはテストコメントです。"
if validate_length(comment, 10):
    print("OK")
else:
print("文字数が多すぎます")文字数が多すぎます実務では、このようなチェック関数を共通部品として作成しておくのが一般的です。
文字列の長さ取得におけるパフォーマンス
大量のデータを処理する場合、関数の実行速度が気になるかもしれません。
幸いなことに、Pythonの文字列オブジェクトは自身の長さを内部的に保持しています。
そのため、len()関数を呼び出す際の計算量は O(1) であり、文字列がどれだけ長くても瞬時に結果が得られます。
文字列の末尾まで走査して文字を数え直すわけではないため、非常に効率的です。
ループの中で何度もlen()を呼び出したとしても、それがボトルネックになることはほとんどありません。
ループ処理での利用
インデックスを使って文字列を処理する場合、range(len(s)) という書き方がよく使われます。
text = "ABC"
for i in range(len(text)):
print(f"Index {i}: {text[i]}")Index 0: A
Index 1: B
Index 2: Cただし、Pythonでは for char in text: のように直接文字を反復処理する方が推奨される場合が多いことも覚えておきましょう。
まとめ
Pythonで文字列の長さを取得する方法は、基本的にはlen()関数を呼び出すだけと非常に簡単です。
日本語などのマルチバイト文字も標準で1文字としてカウントされるため、通常のテキスト処理で困ることは少ないでしょう。
しかし、本記事で解説したように、「バイト数」としての長さや「複雑な絵文字」のカウントが必要な場合は、特別な処理が必要になります。
最後に、今回紹介した主なポイントを振り返ります。
| 用途 | 方法・関数 | 備考 |
|---|---|---|
| 通常の文字数取得 | len(s) | 全角・半角問わず1文字として計算 |
| バイト数の取得 | len(s.encode('utf-8')) | エンコーディングに依存する |
| 特定文字の出現数 | s.count('x') | 部分一致の回数をカウント |
| 空白を除いた文字数 | len(s.strip()) | 前後の空白を無視してカウント |
これらの知識を適切に使い分けることで、データのバリデーションや加工を正確に行えるようになります。
Pythonの文字列操作には、他にも便利なメソッドが多数用意されています。
まずは基本となるlen()をマスターし、そこから柔軟なテキスト処理へと応用を広げていきましょう。