
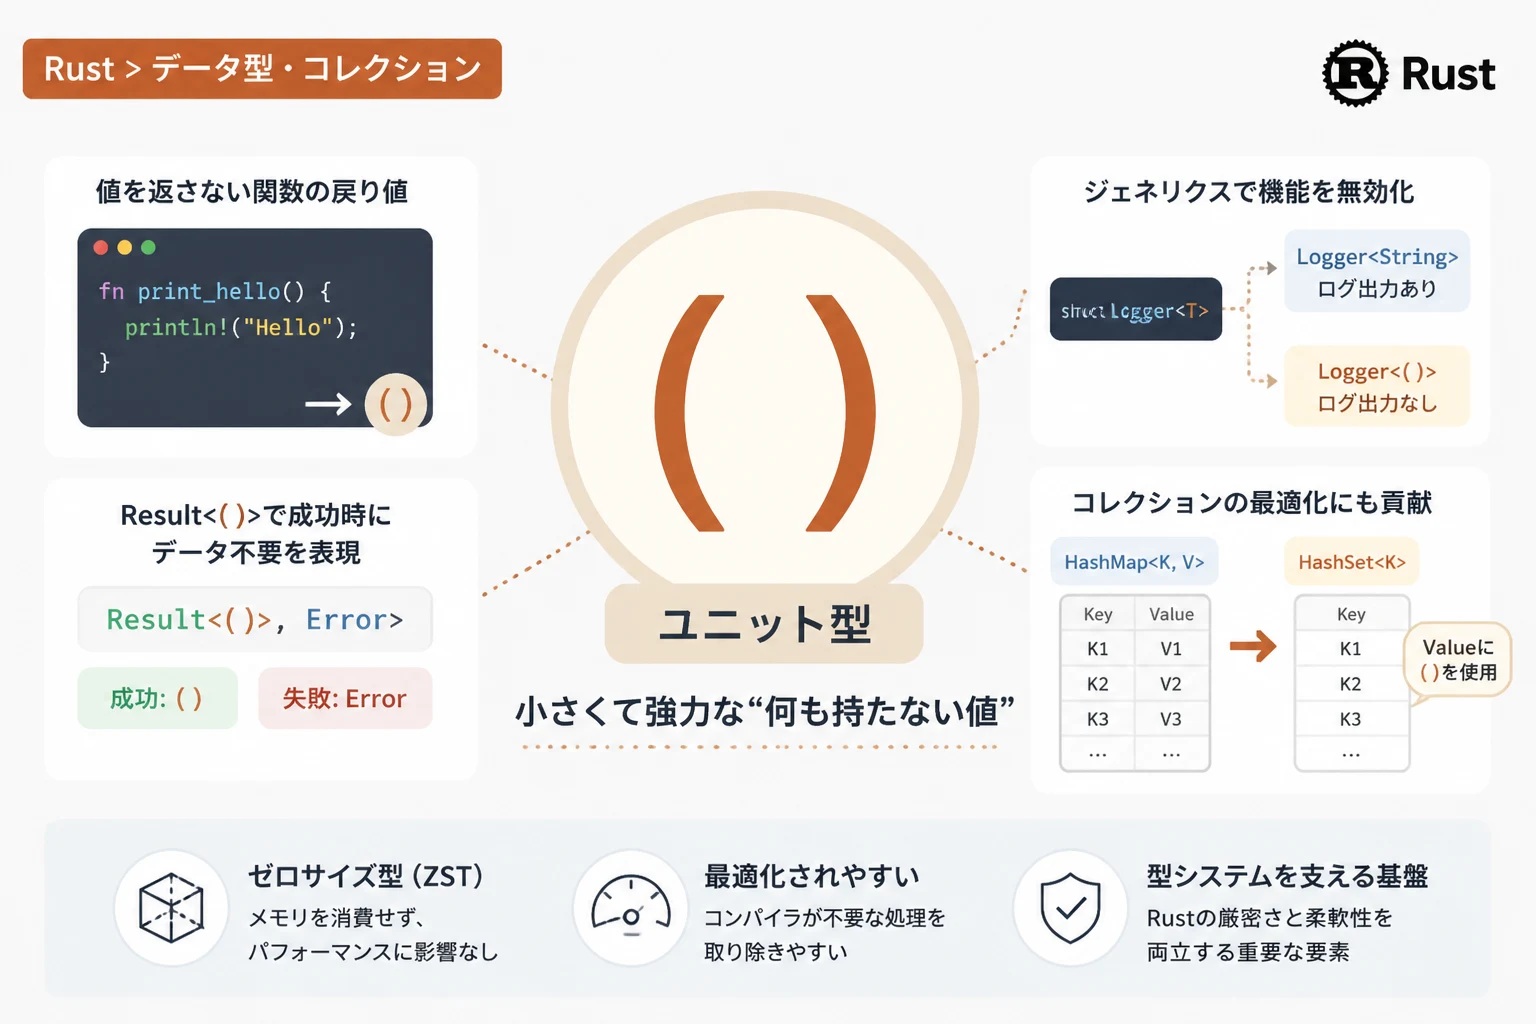
Rustのプログラミングにおいて、空の括弧 () は非常に頻繁に目にする記号です。
これは「ユニット型」と呼ばれ、Rustの型システムの中で極めて重要な役割を果たしています。
一見すると何も意味しないように見えるかもしれませんが、Rustが表現力豊かな静的型付け言語であるための根幹を支えています。
本記事では、ユニット型の基本的な定義から、メモリ上の挙動、さらには実戦的なコードでの活用方法まで詳しく掘り下げていきます。
ユニット型 () の基本概念
ユニット型は、値がたった一つしか存在しない型として定義されています。
その唯一の値自体も () と記述され、これは「ユニット値」と呼ばれます。
多くのプログラミング言語では「何もないこと」を void などのキーワードで表現しますが、Rustではそれを一つの「型」として厳密に扱います。
この設計により、関数の戻り値やジェネリクスの引数において、一貫性のある処理が可能になります。
ゼロサイズ型 (ZST) としての特性
ユニット型は、メモリを一切消費しないゼロサイズ型 (Zero Sized Type) です。
実際に std::mem::size_of 関数を使用して確認してみましょう。
fn main() {
    // ユニット型のサイズをバイト単位で取得
    let size = std::mem::size_of::<()>();
    println!("ユニット型のサイズ: {} バイト", size);
}ユニット型のサイズ: 0 バイトこのように、ユニット型はコンパイル後、メモリ領域を占有しません。
これは、Rustのコンパイラが「値が一つしかないため、情報を保持する必要がない」と判断し、最適化を行うためです。
そのため、大量のユニット型を保持したとしても、実行時のメモリパフォーマンスに悪影響を与えることはありません。
関数の戻り値としてのユニット型
Rustにおいて、値を返さない関数は暗黙的にユニット型を返しています。
例えば、標準的な println! を呼び出すだけの関数がこれに該当します。
fn say_hello() {
    println!("こんにちは、Rust!");
}

fn main() {
    let result: () = say_hello();
    println!("関数の戻り値: {:?}", result);
}こんにちは、Rust!
関数の戻り値: ()上記の say_hello 関数は、戻り値の型を指定していませんが、実際には fn say_hello() -> () と定義したのと同義です。
セミコロンがユニット型を生成する仕組み
Rustは「式ベース」の言語であり、文(Statement)の末尾にセミコロンを付けることで、その式の評価結果を捨ててユニット型を返します。
このセミコロンの有無が、関数の戻り値を決定する重要なルールとなります。
fn add_one(x: i32) -> i32 {
    x + 1 // セミコロンがないので、i32型の値を返す
}

fn add_one_unit(x: i32) {
    x + 1; // セミコロンがあるため、評価結果は捨てられ () が返る
}
初心者が陥りやすいミスとして、値を返すべき関数の最後に誤ってセミコロンを付けてしまい、コンパイルエラーになるケースがあります。
このエラーは「期待される型は i32 ですが、ユニット型 () が見つかりました」という内容になります。
エラー処理における Result<(), E> の活用
Rustの実戦的な開発において、ユニット型が最も活躍する場面の一つがエラー処理です。
特定の処理を行い、成功した場合には特に返す値がないが、失敗した場合にはエラー情報を返したいというケースが多々あります。
このような場合、Result<(), E> という型を使用します。
use std::fs::File;
use std::io::{Write, Error};

fn write_to_file() -> Result<(), Error> {
    let mut file = File::create("log.txt")?;
    file.write_all(b"Hello, Rust unit type!")?;

    // 成功時に「何もないこと」を明示的に返す
    Ok(())
}

fn main() {
    match write_to_file() {
        Ok(_) => println!("書き込みに成功しました。"),
        Err(e) => println!("エラーが発生しました: {}", e),
    }
}
このように Ok(()) と記述することで、「処理は正常に完了したが、返すべきデータはない」という状態を型安全に表現できます。
また、Rustの main 関数自体も、2018エディション以降は Result<(), E> を戻り値に持つことが可能になりました。
ジェネリクスとトレイトにおけるユニット型の活用
ユニット型は、ジェネリクス(多相性)を利用する際の強力なツールになります。
ある構造体やトレイトが抽象的な型 T を要求している場合、そこに () を当てはめることで「その機能を使わない」という選択を静的に表現できます。
HashSet<K> の内部実装とユニット型
標準ライブラリの HashSet<K> は、実は内部的に HashMap<K, V> を再利用して実装されています。
具体的には、HashMap の値(Value)の型としてユニット型を指定することで、HashSet を実現しています。
// HashSet の構造のイメージ
struct MyHashSet<K> {
    map: HashMap<K, ()>,
}
ユニット型はメモリを消費しないため、この実装方法をとっても HashMap<K, bool> などを使用するより効率的です。
このように「キーだけが必要で、値には興味がない」というデータ構造を作る際に、ユニット型は最適な選択肢となります。
ユニット型が実装している標準トレイト
ユニット型は、標準ライブラリによって多くの便利なトレイトが実装されています。
| トレイト名 | 説明 |
|---|---|
Default | Default::default() で () を生成できます。 |
Clone / Copy | 代入時にコピーされ、所有権の移動を気にする必要がありません。 |
Debug | {:?} で文字列として出力可能です。 |
PartialEq / Eq | ユニット型同士の比較が可能です(常に真となります)。 |
これらのトレイト実装のおかげで、汎用的なジェネリックコードの中にユニット型を違和感なく組み込むことができます。
他の型との比較
ユニット型をより深く理解するために、他言語の概念やRustの他の特殊な型と比較してみましょう。
void との違い
C言語やJavaの void は、関数が値を返さないことを示すキーワードであり、それ自体を変数に格納することはできません。
一方、Rustの () は完全な「型」であり、変数への代入や引数としての受け渡しが可能です。
この「第一級の型である」という性質が、Rustのジェネリクスの柔軟性を支えています。
! (never型) との違い
ユニット型と混同されやすいものに ! (never型)があります。
ユニット型は「一つの値を持ち、正常に終了する」ことを表しますが、never型は「決して値を返さない」ことを表します。
fn infinite_loop() -> ! {
    loop {
        // 無限ループのため、この関数は戻ってこない
    }
}
無限ループやプログラムの強制終了(panic!)を行う関数は、ユニット型ではなくnever型を返します。
「空の値がある」ことと「値が返ってくること自体があり得ない」ことの区別を、Rustは型システムで厳密に分けています。
まとめ
Rustのユニット型 () は、単なる「空の括弧」以上の深い意味を持っています。
それはメモリ消費量ゼロの効率的な型であり、式ベースの言語設計を支える重要な要素です。
関数の戻り値としての基本的な利用から、エラー処理の Result<(), E>、さらには HashSet のような高度なデータ構造の最適化まで、その用途は多岐にわたります。
ユニット型の特性を正しく理解し、使いこなすことは、Rustらしい美しく効率的なコードを書くための第一歩と言えるでしょう。
ぜひ、ジェネリクスやトレイトの設計において、ユニット型を積極的に活用してみてください。