
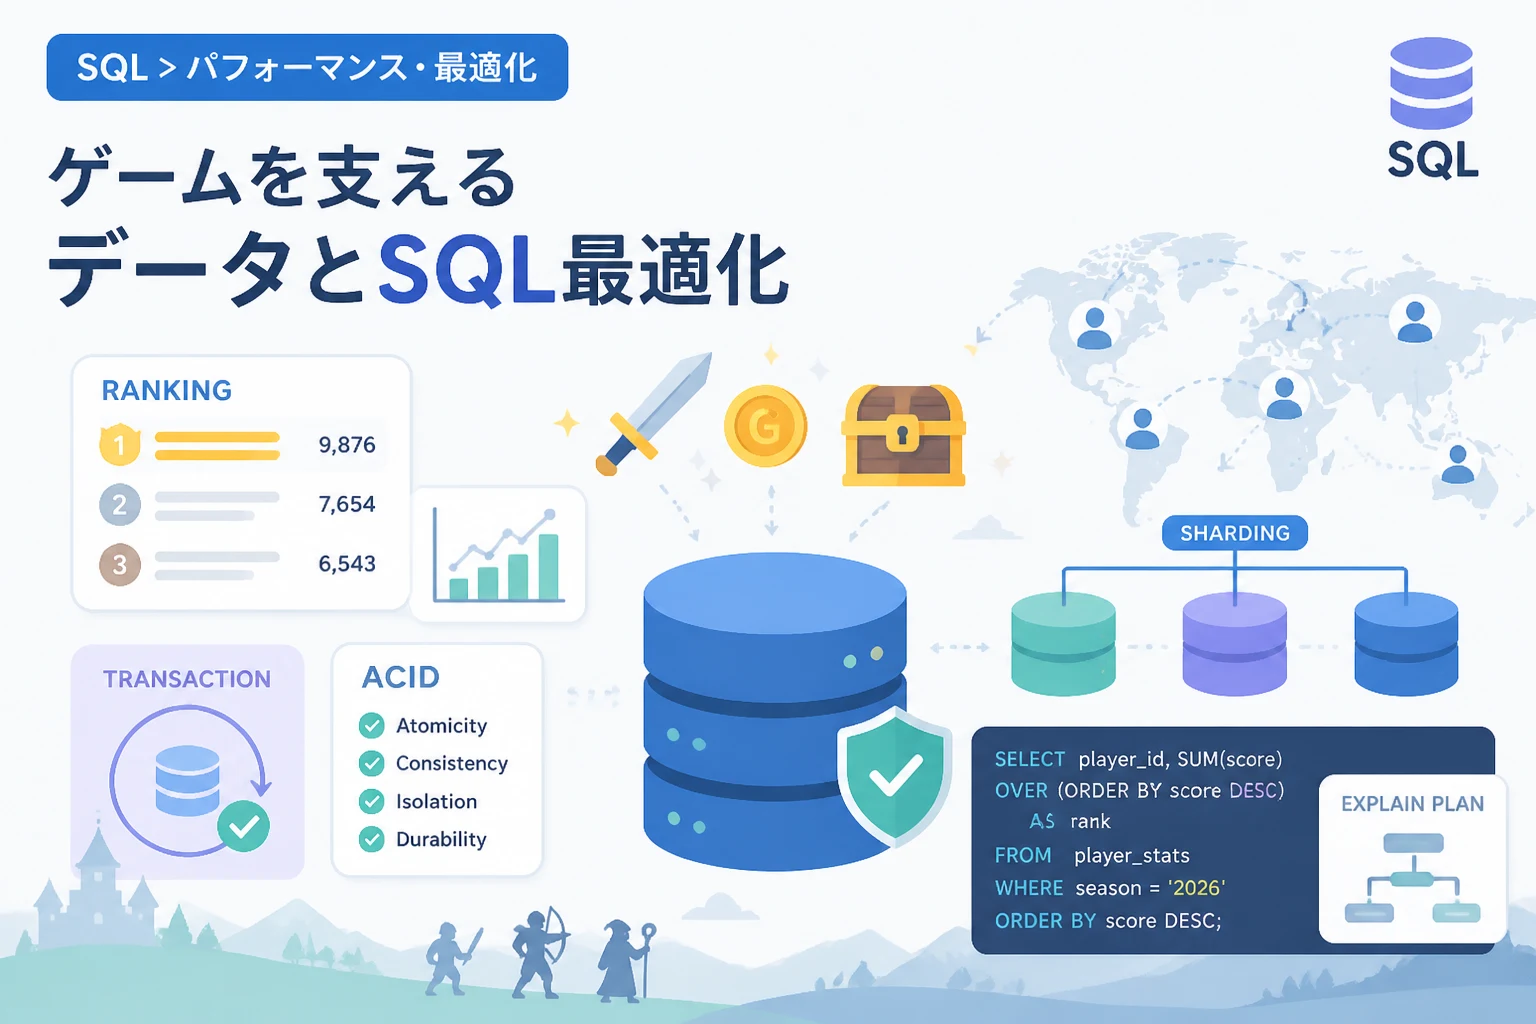
2026年のゲーム開発現場において、データの管理能力はプロジェクトの成否を分ける決定的な要素となっています。
特に数百万規模の同時接続ユーザーを抱えるタイトルでは、データベースの設計ミスが致命的な遅延やサービス停止を引き起こすリスクがあります。
リレーショナルデータベース(RDBMS)とSQLは、長年培われた信頼性とデータの整合性維持能力により、最新のゲームエンジンと並んでバックエンドの核として君臨し続けています。
本記事では、大規模ユーザーを支えるためのSQL活用術として、具体的なデータベース設計の考え方から高度な最適化テクニックまでを詳しく掘り下げていきます。
ゲーム開発におけるSQLの役割と重要性
現代のオンラインゲームにおいて、SQLが担う役割は単なるデータの保存場所にとどまりません。
プレイヤーの所持金や経験値、インベントリ内のアイテムなど、1円の狂いも許されないアセット管理には、SQLのACID特性が不可欠です。
ACID特性とは、原子性、一貫性、独立性、永続性を指し、これらが高いレベルで保証されることで、急激なサーバー負荷時でもデータの矛盾を防ぐことが可能になります。
整合性が求められるゲーム内経済
ゲーム内通貨やレアアイテムの取引が行われるマーケットプレイス機能では、トランザクション管理が極めて重要です。
もしアイテムの受け渡し中に通信障害が発生し、片方のプレイヤーからアイテムが消え、もう片方には届かないといった事態が起きれば、ユーザーの信頼を瞬時に失ってしまいます。
SQLを使用することで、こうした複雑な一連の処理を一つの不可分な単位として実行し、失敗時には自動的に元の状態へ戻す(ロールバック)ことが容易になります。
柔軟なデータ集計による運営支援
SQLの強みは、複雑な条件でのデータ抽出と集計を高速に行える点にもあります。
運営チームが「過去30日以内にログインし、かつ特定のイベントをクリアしたレベル50以上のユーザー数」を把握したい場合、SQLクエリ一つで即座に回答を得られます。
このように、ゲームバランスの調整やマーケティング施策に直結する分析基盤として、SQLは強力な武器となります。
大規模ユーザーに対応するデータベース設計の基本
ユーザー数が小規模なうちは単一のデータベースサーバーで十分ですが、数十万人を超える規模では設計思想を根本から変える必要があります。
パフォーマンスを維持しつつ拡張性を確保するためには、データの正規化と非正規化のバランス、そして負荷分散の仕組みを正しく理解しなければなりません。
正規化とパフォーマンスのトレードオフ
データベース設計の基本である正規化は、データの重複を排除し、管理を容易にするために行われます。
しかし、ゲーム開発においては過度な正規化がテーブル結合(JOIN)の増加を招き、クエリの実行速度を低下させる原因になることがあります。
そのため、頻繁に参照されるユーザープロフィールなどは、あえて一部のデータを重複して持たせる「意図的な非正規化」を検討することが一般的です。
垂直分割と水平分割(シャーディング)
一つのデータベースが限界に達した際、まず検討されるのが垂直分割です。
これは、ユーザー基本情報テーブルとログテーブルなど、役割ごとにデータベースサーバーを分ける手法を指します。
さらに大規模なトラフィックに対応するためには、同じ構造のテーブルを複数のサーバーに分散させる水平分割(シャーディング)が採用されます。
プレイヤーIDに基づいたシャーディングの例
シャーディングでは、どのデータをどのサーバーに配置するかを決定する「シャードキー」の選定が重要です。
一般的にはプレイヤーIDをシャードキーとし、IDの範囲やハッシュ値に基づいて保存先を決定します。
これにより、特定のサーバーに負荷が集中するのを防ぎ、システム全体の書き込み容量を直線的に拡張することが可能になります。
| サーバー名 | 格納されるプレイヤーID範囲 | 主な役割 |
|---|---|---|
| Shard-01 | 1 ~ 1,000,000 | アジア圏ユーザー用 |
| Shard-02 | 1,000,001 ~ 2,000,000 | 北米圏ユーザー用 |
| Shard-03 | 2,000,001 ~ 3,000,000 | 欧州圏ユーザー用 |
実践的なSQL活用テクニック:ランキングとインベントリ
ゲーム独自の機能をSQLで実装する際、パフォーマンスと正確性を両立させるためのテクニックを紹介します。
特にランキングシステムとインベントリ管理は、ゲームの面白さと公平性を支える重要な要素です。
ウィンドウ関数による効率的なランキング集計
全ユーザーの中から特定のユーザーの順位を求める処理は、古くは重い処理の代表格でした。
しかし、最新のSQL標準に含まれるウィンドウ関数を活用することで、高速かつ簡潔に記述できます。
-- スコア順に全ユーザーの順位を算出するクエリ
SELECT
    user_id,
    score,
    RANK() OVER (ORDER BY score DESC) as current_rank
FROM
    player_scores
WHERE
event_id = 2026;user_id | score | current_rank
--------+-------+-------------
U99821 | 15400 | 1
U10234 | 14950 | 2
U44532 | 14200 | 3ウィンドウ関数を利用すると、サブクエリを多用することなく、同一テーブル内の他の行と比較した計算結果を一行ずつ付与できます。
これにより、データベースエンジンの内部最適化が効きやすくなり、数万件程度のランキングであれば瞬時に計算が完了します。
トランザクション管理によるアイテム重複防止
インベントリシステムでは、アイテムの付与や消費を厳格に管理しなければなりません。
以下のようなSQLトランザクションを用いることで、処理が途中で途切れた際の不整合を防止します。
-- ガチャ実行時のアイテム付与と石の消費
BEGIN;

-- 1. ユーザーの所持石を確認し、不足していればエラーを出す
UPDATE users
SET gem_count = gem_count - 300
WHERE user_id = 'U12345' AND gem_count >= 300;

-- 2. 上記の更新が成功(影響を受けた行が1)なら、アイテムを追加
INSERT INTO inventory (user_id, item_id, quantity)
VALUES ('U12345', 'ITEM_SS_001', 1);

-- 3. すべて成功したなら確定
COMMIT;このように、複数のUPDATEやINSERTを一つのBEGINとCOMMITで囲むことで、「石だけ減ってアイテムが届かない」あるいは「石が減らずにアイテムだけ増える」といった不正増殖バグを未然に防ぐことができます。
パフォーマンスを最大化する最適化戦略
SQLの書き方一つで、サーバーのレスポンス速度は10倍、100倍と変わることがあります。
ゲーム開発の現場では、単に動くコードではなく、高負荷に耐えうる「強いクエリ」を書く技術が求められます。
インデックス設計のベストプラクティス
インデックスは本に例えると「索引」のようなもので、目的のデータを素早く見つけるために欠かせません。
しかし、インデックスを闇雲に作成すると、今度はデータの挿入(INSERT)や更新(UPDATE)が遅くなるという副作用があります。
ゲームでは、WHERE句やORDER BY句で頻繁に使用されるカラムに限定して、複合インデックスを作成するのが定石です。
例えば、「特定のギルドに所属するユーザーを最終ログイン順に並べる」という処理が多い場合、guild_idとlast_login_atの2つのカラムを組み合わせた複合インデックスが絶大な効果を発揮します。
クエリプランの分析とリライト
SQLが遅いと感じた際、最初に行うべきはEXPLAINコマンドによる実行計画の確認です。
-- クエリの実行計画を表示する
EXPLAIN ANALYZE
SELECT * FROM game_logs
WHERE action_type = 'purchase'
AND created_at > '2026-05-01';EXPLAINの結果を確認し、「Seq Scan(フルテーブルスキャン)」が発生している場合は注意が必要です。
これは、データベースがすべての行を上から順に調べていることを意味し、データ量が増えるほど急激に重くなります。
適切なインデックスを貼るか、クエリの検索条件を見直すことで、「Index Scan」へと導くことが最適化の第一歩です。
N+1問題の回避
ゲーム開発においてよくあるパフォーマンス低下の要因に「N+1問題」があります。
これは、例えば10人のプレイヤーリストを取得した後、その10人分それぞれの所属ギルド名を取得するために、10回のクエリを発行してしまう現象です。
これを防ぐためには、一回のSQLでJOINを使用してまとめてデータを取得するか、IN句を用いて一括で問い合わせるようにバックエンドコードを記述する必要があります。
2026年のトレンド:AIによる自律型データベース管理
2026年現在、データベース運用においてもAIの活用が一般化しています。
かつてはDBA(データベース管理者)が手作業で行っていたインデックスの調整やクエリのチューニングを、AIがリアルタイムのトラフィックを分析して自動で行う機能が登場しています。
しかし、AI任せにするのではなく、「なぜこのクエリが遅いのか」を論理的に理解できるエンジニアの価値は依然として高いままです。
SQLの内部動作原理を理解しているからこそ、AIの提案が正しいかを判断し、ゲーム固有の複雑なロジックを最適化できるからです。
まとめ
ゲーム開発におけるSQLの活用は、単なるデータの入出力以上の意味を持っています。
それは、何百万人というユーザーが織りなす仮想世界の秩序を守り、円滑なユーザー体験を提供する土台を作ることに他なりません。
本記事で解説したシャーディングによる負荷分散、ウィンドウ関数による効率的な集計、そして厳格なトランザクション管理は、今後もゲーム開発のコア技術であり続けるでしょう。
日々の開発において、一見地味に見えるSQLクエリの最適化が、最終的には数千万人を熱狂させるタイトルの安定稼働を支える力となります。
常にパフォーマンスを意識したデータベース設計とクエリ記述を心がけ、最新のSQL技術を最大限に活用していきましょう。