
C言語において、文字列の比較はプログラミングの基礎でありながら、多くの初心者がつまずきやすいポイントでもあります。
JavaやPythonといったモダンな言語に慣れていると、つい比較演算子を使ってしまいがちですが、C言語では特有のルールを理解しなければなりません。
文字列の実体がメモリ上のどこに配置されているのか、そしてどのように終端を判断するのかを正しく把握することが重要です。
この記事では、標準ライブラリ関数であるstrcmpを中心に、安全で効率的な文字列比較の手法について詳しく説明します。
最新のC言語標準であるC23(ISO/IEC 9899:2024)の視点も踏まえ、現代的なコーディングスタイルを身につけていきましょう。
C言語における文字列比較の基本
C言語で文字列を比較する際、最も大切なことは「文字列は単なる文字の配列である」という事実を忘れないことです。
文字列の末尾には必ずヌル文字(\0)が付与されており、コンピュータはこの終端文字を見つけるまでを一つの文字列として認識します。
比較演算子「==」では比較できない理由
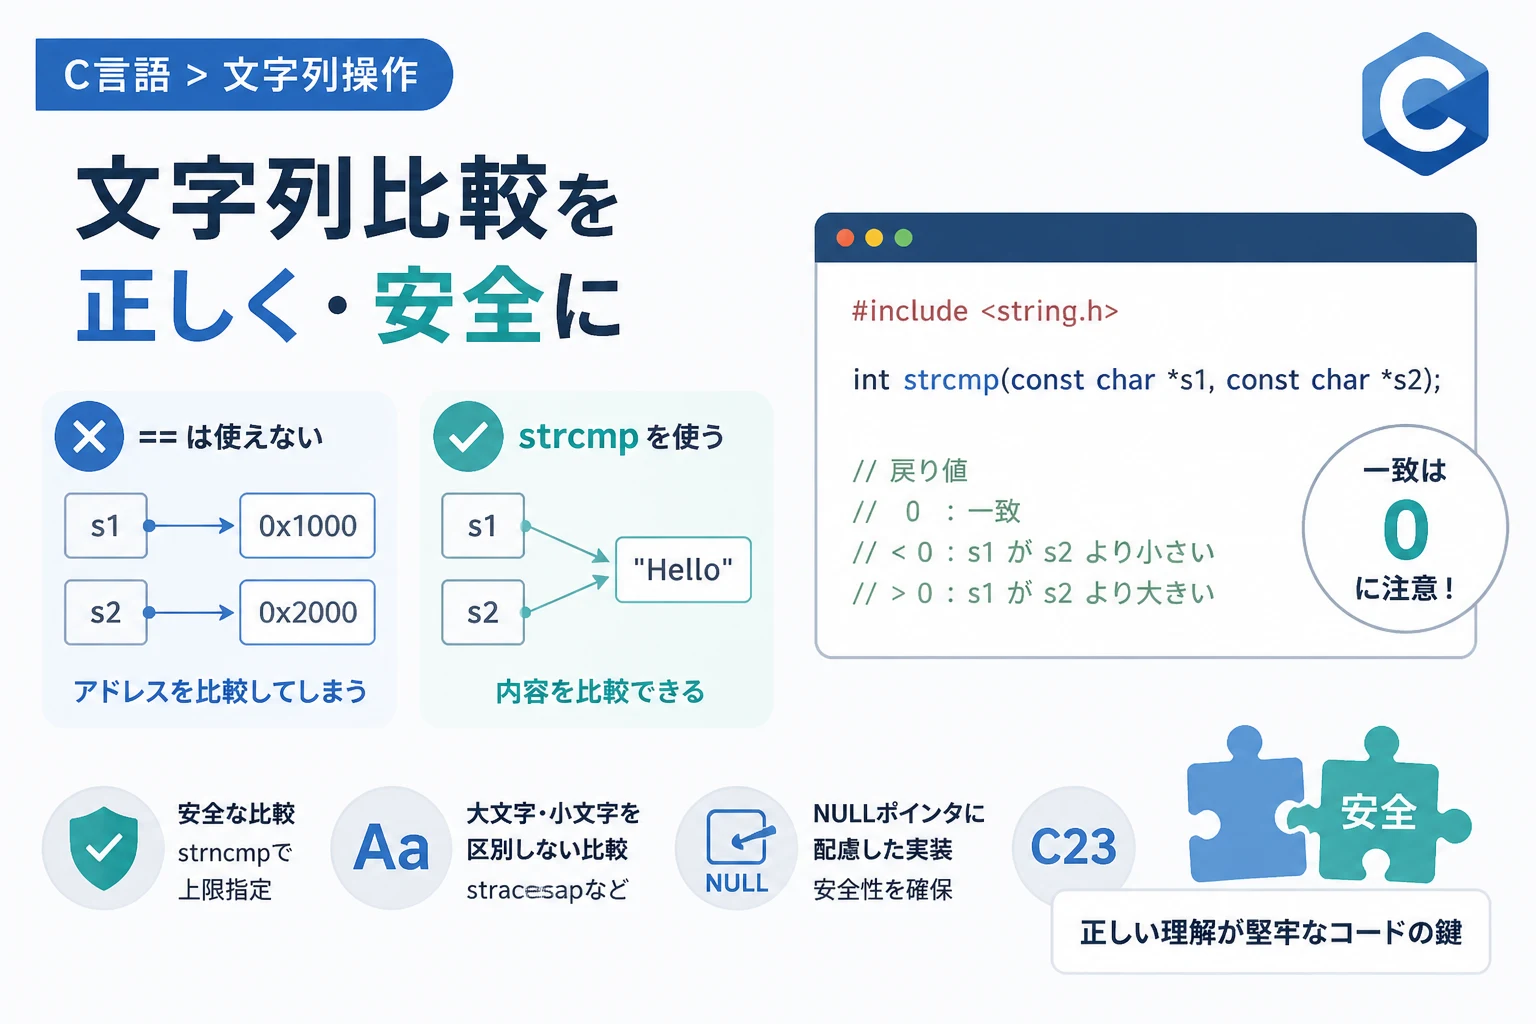
C言語において、文字列に対して==演算子を使用すると、期待した結果は得られません。
なぜなら、C言語の文字列変数はその実体ではなく、メモリ上の先頭アドレスを指すポインタに過ぎないからです。
==演算子を使った場合、比較されるのは文字列の中身ではなく、それぞれの文字列が格納されている「アドレス値」になります。
たとえ二つの文字列の内容が全く同じ「Apple」であったとしても、それらが異なるメモリ領域に配置されていれば、アドレス比較の結果は「偽(不一致)」となります。
そのため、文字列の内容そのものを一文字ずつ比較するためには、専用の関数を利用する必要があるのです。
ポインタ比較と実体比較の違い
ポインタの比較は、二つのポインタ変数が「同じメモリ上の場所」を指しているかどうかを調べるために使われます。
一方で、実体の比較は、異なる場所に保存されているデータの内容が同一であるかどうかを確認する作業です。
C言語で文字列の中身をチェックしたい場合は、必ず後者の「実体比較」を行わなければなりません。
この実体比較を効率的に行うために用意されているのが、標準ライブラリのstring.hに含まれる関数群です。
strcmp関数の使い方
文字列比較において最も一般的に使用されるのが、strcmp関数です。
この関数は、二つの文字列を先頭から一文字ずつ比較し、それらが同一であるか、あるいは辞書順でどちらが先かを判定します。
ヘッダーファイルとプロトタイプ宣言
strcmp関数を使用するには、プログラムの冒頭でstring.hをインクルードする必要があります。
関数の定義は以下のようになっています。
#include <string.h>
int strcmp(const char *s1, const char *s2);
第一引数と第二引数には、比較したい文字列へのポインタを渡します。
引数にconstが付いているのは、関数内で文字列の内容が書き換えられないことを保証するためです。
戻り値の意味
strcmp関数の戻り値は、比較結果に応じて以下のような整数値を返します。
| 戻り値の状態 | 意味 |
|---|---|
| 0 | 二つの文字列が完全に一致している |
| 正の値(0より大きい) | 最初の文字列が二番目の文字列より辞書順で大きい |
| 負の値(0より小さい) | 最初の文字列が二番目の文字列より辞書順で小さい |
ここで特に重要なのは、一致した場合の戻り値が「0」であるという点です。
多くの初心者が、真偽値(True/False)の感覚で「1が一致」と勘違いしてしまいがちですので注意してください。
条件分岐で一致を判定する場合は、if (strcmp(str1, str2) == 0)と記述するのが基本です。
具体的な実装コード例
実際にstrcmp関数を使って、ユーザー入力と特定の文字列を比較するサンプルコードを見てみましょう。
#include <stdio.h>
#include <string.h>

int main() {
    char password[] = "secret123";
    char input[20];

    printf("パスワードを入力してください: ");
    scanf("%s", input);

    // 文字列の比較
    if (strcmp(input, password) == 0) {
        printf("認証に成功しました。\n");
    } else {
        printf("認証に失敗しました。パスワードが異なります。\n");
    }

    return 0;
}パスワードを入力してください: secret123
認証に成功しました。このプログラムでは、入力されたinputとあらかじめ定義されたpasswordの内容を比較しています。
一文字でも異なれば、戻り値は0以外となり「認証に失敗」のルートを通ります。
指定した文字数だけ比較するstrncmp関数
strcmp関数は非常に便利ですが、実務レベルの開発ではstrncmp関数の方が好まれる場面が多くあります。
これは、比較する文字数の上限を指定できる安全なバリエーションです。
なぜstrncmpが必要なのか
strcmp関数は、どちらかの文字列にヌル文字(\0)が出現するまで無限にメモリを読み進めます。
もし文字列が正しく終端されていない不正なデータを読み込んでしまった場合、意図しないメモリ領域にアクセスし、プログラムがクラッシュする危険性があります。
strncmpを使用すれば、最大何文字までチェックするかを指定できるため、バッファオーバーランのリスクを低減できます。
安全な実装への活用
strncmpのプロトタイプ宣言は以下の通りです。
int strncmp(const char *s1, const char *s2, size_t n);第三引数nに、比較する最大文字数を指定します。
例えば、文字列の「接頭辞(プレフィックス)」だけを確認したい場合にも非常に有効です。
#include <stdio.h>
#include <string.h>

int main() {
    char filename[] = "image_2026_01.jpg";

    // 先頭5文字が "image" かどうかを確認
    if (strncmp(filename, "image", 5) == 0) {
        printf("これは画像ファイルです。\n");
    }

    return 0;
}これは画像ファイルです。このように、特定の長さだけを安全にチェックできるのがstrncmpの強みです。
大文字・小文字を区別せずに比較する方法
標準のstrcmp関数は、大文字と小文字を厳格に区別します(例:’A’と’a’は別物とみなす)。
しかし、ユーザー名やファイル拡張子の検索など、大文字小文字を区別したくないケースも多々あります。
strcasecmpやstricmpの利用
実は、標準Cライブラリ(ANSI C)には大文字小文字を無視する関数は含まれていません。
しかし、多くの環境では拡張機能としてstrcasecmp(POSIX準拠)やstricmp(Windows/MSVC)が用意されています。
POSIX環境(LinuxやmacOS)では、strings.hをインクルードしてstrcasecmpを使用します。
#include <stdio.h>
#include <strings.h> // string.hではなくstrings.hが必要な場合がある

int main() {
    char str1[] = "Hello";
    char str2[] = "HELLO";

    if (strcasecmp(str1, str2) == 0) {
        printf("大文字小文字を区別せずに一致しました。\n");
    }

    return 0;
}
Windows環境(Visual Studioなど)の場合は、_stricmpという名称の関数を使用するのが一般的です。
環境に依存しない実装方法
特定のOSに依存したくない場合は、自作の比較関数を作成するか、比較前に文字列をすべて大文字(または小文字)に変換する手法を検討しましょう。
tolower関数を使用して、一文字ずつ小文字に変換しながら比較するループを作成することで、ポータブルなコードを書くことができます。
安全な文字列比較のための注意点
C言語における文字列操作は、セキュリティ上の脆弱性が最も発生しやすい箇所の一つです。
単に比較するだけでなく、堅牢なプログラムを書くための注意点を押さえておきましょう。
NULLポインタチェックの重要性
strcmp関数にNULL(ヌルポインタ)を渡すと、プログラムは即座にセグメンテーションフォルトを起こして終了します。
外部からの入力や、動的メモリ確保(malloc)の結果を比較に使う場合は、事前にポインタが有効であることを確認してください。
if (str1 != NULL && str2 != NULL) {
    if (strcmp(str1, str2) == 0) {
        // 処理
    }
}
このような些細なチェックが、商用ソフトウェアの安定性を支える重要な要素となります。
バッファオーバーランの防止
先述の通り、strncmpの利用はバッファオーバーラン対策として非常に有効です。
また、C11規格からは、より安全性を高めたstrcmp_sのような「境界チェック付き関数」も導入されました。
ただし、これらの関数はすべてのコンパイラでサポートされているわけではないため、利用環境の確認が必要です。
基本的には、「入力バッファのサイズを常に意識し、未知の長さのデータを扱わない」という設計思想が不可欠です。
文字列比較の応用パターン
文字列の比較は、単なる一致確認以外にもさまざまな用途で活用されます。
文字列のソート(並べ替え)
strcmpの戻り値が「正・負・0」を返す性質を利用すれば、文字列の配列を辞書順に並べ替えることができます。
標準ライブラリのqsort関数と組み合わせることで、効率的なソートを実装可能です。
#include <stdio.h>
#include <stdlib.h>
#include <string.h>

// qsort用の比較関数
int compare(const void *a, const void *b) {
    return strcmp(*(const char **)a, *(const char **)b);
}

int main() {
    const char *list[] = {"Orange", "Apple", "Banana", "Cherry"};
    int n = 4;

    qsort(list, n, sizeof(char *), compare);

    printf("ソート結果:\n");
    for (int i = 0; i < n; i++) {
        printf("%s\n", list[i]);
    }

    return 0;
}ソート結果:
Apple
Banana
Cherry
Orangeこのように、strcmpの仕様を深く理解することで、アルゴリズムの実装にも応用が効くようになります。
特定のプレフィックス・サフィックスの判定
文字列の「終わり」が特定のパターンで終わっているか(サフィックス)を判定したい場面も多いでしょう。
例えば、「.txt」で終わるファイルを探す場合、文字列全体の長さから「.txt」の長さ分を差し引いた位置のアドレスを比較関数に渡します。
const char *file = "document.txt";
const char *ext = ".txt";
if (strlen(file) >= strlen(ext) &&
    strcmp(file + strlen(file) - strlen(ext), ext) == 0) {
    printf("テキストファイルです。\n");
}
ポインタ演算を組み合わせることで、柔軟な文字列解析が可能になります。
現代のC言語(C23以降)における文字列処理のトレンド
2026年現在、C言語はC23規格の普及により、より安全で厳密なコーディングが求められています。
従来の「暗黙の了解」に頼ったプログラミングは影を潜め、型安全や静的解析ツールの活用が当たり前となりました。
文字列比較においても、単に動けば良いというわけではなく、コンパイラの警告レベルを最大にしても警告が出ないような、クリーンなコードを書くことが推奨されます。
また、UTF-8などのマルチバイト文字列の比較についても、ライブラリを活用した適切な処理が一般化しています。
標準のstrcmpはあくまでバイト単位の比較であるため、多言語対応が必要なシステムではstrcoll関数を使用してロケールに応じた比較を行うことも重要です。
まとめ
C言語での文字列比較は、他の言語と比較すると手間に感じるかもしれません。
しかし、strcmpやstrncmpの挙動を正しく理解することは、メモリ管理やポインタの仕組みを理解することに直結します。
「==」演算子はアドレスの比較であること、「strcmp」の戻り値が0のときに一致すること、そして「strncmp」による安全性の確保の3点を常に意識してください。
これらの基本を忠実に守ることで、バグの少ない、堅牢で効率的なC言語プログラムを構築できるようになります。
日々の開発において、状況に応じた最適な比較関数を選択できるエンジニアを目指しましょう。